CS285 HW1 实验报告:行为克隆与 DAgger
本报告迁移自原课程材料,经 AI 事实核查未发现存疑项,未逐页人工审核;结论与证据请以页面列出的原始文件为准。
实验目标
HW1 的主线是模仿学习(imitation learning):给定一个训练好的专家策略与它产生的一批演示数据(demonstrations),训练一个 MLP 学生策略去复现专家行为,并在两类算法上对比:
实验设置
| 环境 | 本作业在 Ant-v4(四足爬行)与 Hopper-v4(单腿跳跃)两个 MuJoCo 连续控制任务上验证模仿学习;完整运行配置与原始日志未公开。 |
|---|---|
| 随机种子 | 1、2、3 |
| 关键配置 | 无 |
本报告迁移自 CS285 课程材料 [1]。
本报告是模块 01(模仿学习与行为克隆)的动手配套:在 MuJoCo 的 Ant-v4 与 Hopper-v4 上,先评估行为克隆(Behavioral Cloning, BC),再评估 DAgger。本站公开证据包括结果图与 rollout 视频;原始训练日志未随迁移公开,因此下文数字仅以这些公开证据为核查依据。
本报告要回答的问题
- 朴素 BC 在两个环境上能追平专家吗?差距有多大(均值 ± 标准差、达标率)?
- 为什么同样的 BC,在 Ant 上几乎追平专家、在 Hopper 上只有约三成?
- DAgger 逐轮把 Hopper 从约 29% 拉回到约 98% 专家水平——曲线长什么样、方差如何变化?
- 这些实测现象如何回扣模块 01 的理论:分布漂移、 vs 、多模态动作、teacher forcing ↔ exposure bias。
- 如果把 §7 提到的改进(归一化、更大网络、更多步、集成、多模态、DAgger 调参)全部实现,eval reward 到底能涨多少? 见 §8 的真实消融。
一句话结论
在这次单种子实验中,BC 在 Ant 上接近专家参考水平,在 Hopper 上明显落后;DAgger 的 Hopper 曲线随后回升到专家参考线附近。这些结果与分布漂移的机制解释一致,但不是对理论复杂度界的直接测量。
证据口径 / 复现契约
- 环境: Python 3.9;gym 0.25.2;MuJoCo 2.2.0;torch 1.12.1;NumPy 1.x。
- 重复与误差条: 主实验使用 seed=1;§8.2 的 BC 消融明确使用 seed∈{1,2,3}。图中误差条的具体口径以相应图注为准。
- 预算: 完整训练预算未作为公开证据,视频仅用于核对可见行为。
- 视频: 公开视频仅用于核对可见行为,不用于支撑步数、单条回报、训练时点或成功率。
【单种子趋势】【受控对照:BC vs DAgger】 因学生访问分布随 DAgger 改变,结果支持机制一致性,不等于对 理论阶数的直接测量。
1. 作业目标与要求
HW1 的主线是模仿学习(imitation learning):给定一个训练好的专家策略与它产生的一批演示数据(demonstrations),训练一个 MLP 学生策略去复现专家行为,并在两类算法上对比:
| 部分 | 算法 | 核心操作 | 作业代号 |
|---|---|---|---|
| Section 1 | 行为克隆 BC | 只在离线专家数据上做一次监督回归() | q1_ |
| Section 2 | DAgger | 学生上线 rollout → 专家对这些新 obs 重新打标 → 聚合再训练,迭代多轮() | q2_ |
需要自己补全的关键代码点(skeleton 中标为 HW1: implement this):MLP 构建、策略前向 / 取动作、BC 的监督更新、replay buffer 的联合采样、DAgger 的专家 relabel,以及训练/采样主循环。评测环境为两个连续控制任务:
| 环境 | 观测维度 | 动作维度 | 单条轨迹上限 ep_len | 专家平均回报 |
|---|---|---|---|---|
| Ant-v4 | 111(开启 use_contact_forces) | 8 | 1000 | 4713.65 |
| Hopper-v4 | 11 | 3 | 1000 | 3772.67 |
作业达标口径
CS285 官方评分口径:BC 至少在一个环境上达到专家回报的 ≥30%(另一个可以更差,用来暴露 BC 的局限);DAgger 则应在若干轮内明显逼近专家(通常视作趋近 100%)。本报告仅按公开图中的参考线作定性对照。
2. 环境与任务介绍
本作业在两个 MuJoCo 连续控制任务上验证模仿学习:Ant-v4(四足爬行)与 Hopper-v4(单腿跳跃)。环境结构按所述 Gym/MuJoCo 版本说明;原始运行日志未公开。
| 维度 | Ant-v4 | Hopper-v4 |
|---|---|---|
| 形态 / 任务 | 3D 四足机器人(躯干 + 4 条各 2 节的腿),学习协调 8 个铰链向前(+x)行走 | 2D 单腿跳跃者(躯干-大腿-小腿-脚),靠 3 个铰链向前跳跃且不摔倒 |
| 状态空间 | 111(本次强制开启 use_contact_forces) | 11 |
| 状态构成 | 27 维本体状态(躯干 z 高度 1 + 朝向四元数 4 + 8 关节角 = 13 位置;躯干线/角速度 6 + 8 关节角速度 = 14 速度)+ 84 维接触力(14 个身体各 6 维外部力/力矩 ) | 5 维位置(躯干 z 高度、躯干角、大腿/小腿/脚关节角;默认不含 x 坐标)+ 6 维速度(躯干线/角速度、3 关节角速度) |
| 动作空间 | 8 连续(各腿 2 个铰链力矩) | 3 连续(大腿/小腿/脚铰链力矩) |
| 动作取值范围 | 均为 Box(-1, 1),即每维力矩归一化到 | |
| 奖励构成 | healthy(存活)/步 forward(前进 ) ctrl_cost() contact_cost() | healthy(存活)/步 forward(前进 ) ctrl_cost() |
| 终止条件(unhealthy) | 躯干 z 高度不在 ,或状态出现非有限值 | 躯干 z ,或躯干角 rad,或任一状态量 |
| episode 上限 (horizon) | 1000 步(spec.max_episode_steps);达到即 truncate | |
| 专家平均回报 | 4713.65 | 3772.67 |
两个环境为何是绝佳对照
两者奖励结构几乎同构(存活 + 前进 − 控制代价),horizon 都是 1000,差别在稳定性:Ant 四足着地、容错高,健康区间宽松(z 只需 );Hopper 单腿独立、极易失稳,健康区间苛刻(z 需 且躯干角 ),一个小偏差就触发终止。这可能是后文”同一 BC 在 Ant 追平、在 Hopper 崩溃”的因素之一,本实验未隔离其因果作用。Ant 的 111 维里有 84 维是接触力(量级差异大、本次未归一化),也埋下了 §7 优化 4 讨论的隐患。
任务重述:要交付什么
- Q1(BC /
q1_): 只用离线专家演示做一次监督回归(),评测其回报。达标口径:至少一个环境的 BC 回报 专家的 30%(本作业中 Ant 达标、Hopper 恰好用作反例)。- Q2(DAgger /
q2_): 让学生上线 rollout、专家对新观测 relabel、聚合再训练,迭代多轮(),目标是逐轮明显逼近专家(趋近 100%)。- 两个 Q 都在 Ant-v4 与 Hopper-v4 上运行,本报告仅按公开图中的参考线作定性对照。
3. 环境搭建与踩坑
依赖用 conda 隔离环境 cs285,使用 Python 3.9(官方 installation.md 写的是 python=3.7)。核心依赖版本(来自 requirements.txt):
| 包 | 版本 | 作用 |
|---|---|---|
gym | 0.25.2 | 环境接口(旧 step API:step() 返回 4 元组) |
mujoco | 2.2.0 | 物理仿真后端 |
torch | 1.12.1 | 策略网络与优化 |
tensorboard / tensorboardX | 2.10.0 / 2.5.1 | 标量与视频记录 |
numpy(随 torch/gym 约束) | 1.x | 数组运算(注意 gym 0.25 不兼容 NumPy 2.0) |
踩坑要点(参考官方 installation.md)
- Ant 的观测维度必须为 111,不能是 27。 gym 0.25 之后 Ant 默认关闭
use_contact_forces(观测里不含接触力,维度 27);但官方专家策略是开着接触力训练的(维度 111)。代码里在MJ_ENV_KWARGS["Ant-v4"]["use_contact_forces"]=True强制打开,否则专家.pkl与环境 obs 维度对不上,加载即报错。- 旧 step API。 gym 0.25.2 的
env.step()返回(obs, reward, done, info)四元组(新版是五元组terminated/truncated分开)。采样代码按四元组解包;旧 step API 下出现的 DeprecationWarning 属于预期警告。- NumPy 2.0 不兼容。 gym 0.25.2 不支持 NumPy 2.0,需要锁定 NumPy 1.x,否则
np.bool8等别名会直接报错。- 无显示器(headless)报 GLFW 错误。
installation.md给出的解法是export MUJOCO_GL=egl。- 设备选择。 实现中
init_gpu按 CUDA → MPS → CPU 的顺序回退(官方骨架只有 CUDA/CPU 两种)。
4. 实验 setting
公开证据未包含完整训练配置或原始日志,因此本页不逐项列出无法公开核对的超参数、评测批量和运行步数。可核对的设置是:主实验使用 seed=1;§8.2 的 BC 消融使用 seed∈{1,2,3};BC 与 DAgger 的比较仅按公开曲线呈现。
5. 代码实现讲解
5.1 MLP 策略:前向分布与取动作
策略网络用 build_mlp 堆叠 n_layers 个 Linear+tanh,输出层 Linear 到动作维度。连续动作下,forward 返回一个 Normal(mean=mean_net(obs), std=exp(logstd)) 分布;但评测取动作时直接用均值(deterministic),这是与 MSE 训练语义匹配的关键实现细节:
(此处的实现代码或复现命令不在本站发布。)
为什么 eval 用均值而不是 .sample()?
MSE 只对
mean_net求导,对logstd的梯度恒为 0,所以logstd停在初值 0,即 std=1。若评测时.sample(),这项未经训练的噪声可能明显压低回报。用均值做确定性评测等价于关闭未被监督目标训练的探索噪声;它不改变 BC 的均值回归目标,但应明确这是评测策略选择,而非随机策略本身的等价变换。
5.2 行为克隆的监督更新(BC 核心)
BC 就是把控制变成回归:最小化预测动作均值与专家动作之间的 MSE,标准三段式 zero_grad → backward → step:
(此处的实现代码或复现命令不在本站发布。)
对应目标函数就是模块 01 里的最大似然在高斯 + 固定方差下退化成的最小二乘:
5.3 DAgger 的聚合 + 专家 relabel
DAgger 的唯一新增操作:让学生自己上线 rollout,把学生访问到的观测交给专家重新打标(用专家动作覆盖学生动作),再并入 replay buffer 一起训练。这样监督信号直接覆盖”学生自己造成的状态分布”:
(此处的实现代码或复现命令不在本站发布。)
其中 itr==0 走冷启动分支:直接加载离线专家演示(collect_training_trajectories 返回 (loaded_paths, 0, None),0 表示这一轮没走 env step),因此 DAgger 的第 0 轮与纯 BC 在训练数据上等价。
5.4 Replay buffer 的联合采样(易错点)
从 buffer 采 minibatch 时,必须用同一组随机索引同时取 5 个数组,保证 (obs, ac, rew, next_obs, terminal) 来自同一时刻;对每个数组各自独立随机采样会破坏转移对应关系:
(此处的实现代码或复现命令不在本站发布。)
6. 训练与推理结果
【单种子趋势】【BC/DAgger 对照】 误差条为评测轨迹间离散度;视频中的挑选轨迹不估计成功率。
6.1 行为克隆 vs 专家(对照表)
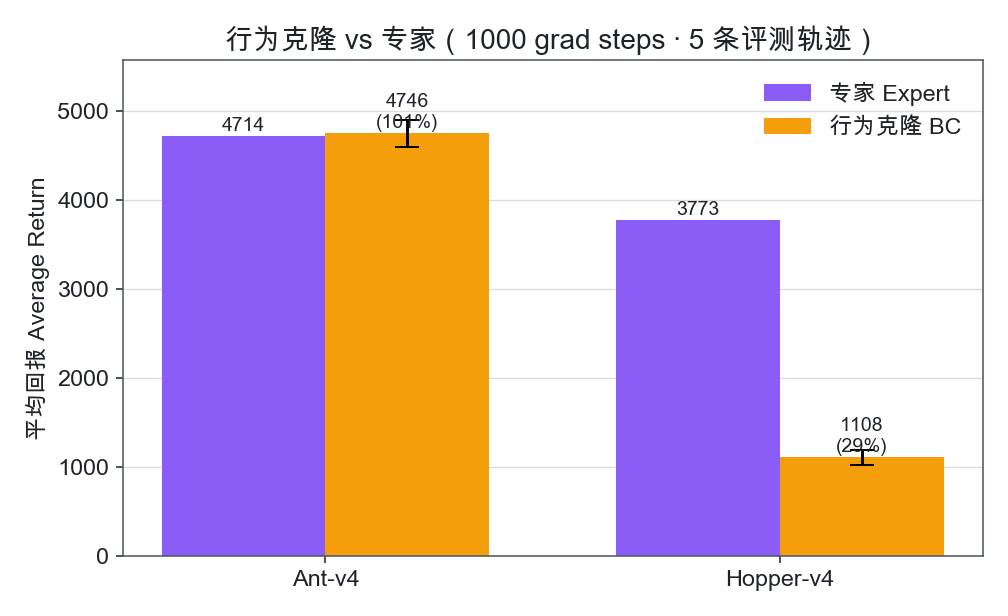
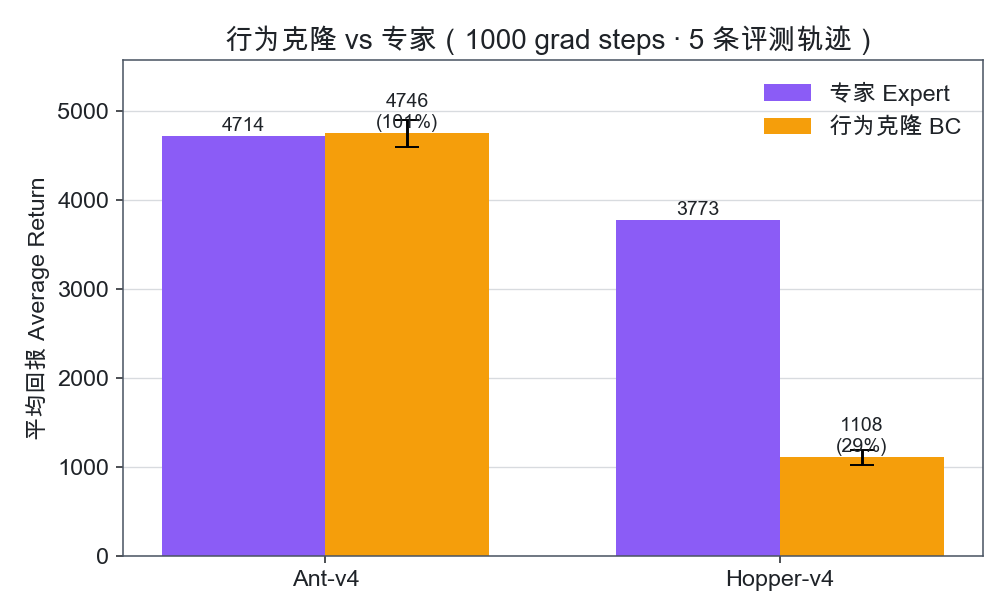
公开柱状图显示:Ant-v4 的 BC 平均回报接近专家参考线,而 Hopper-v4 明显较低。
图 1:BC vs 专家。Ant 上 BC 与专家参考线接近,Hopper 上明显较低。
为什么 Ant 追平、Hopper 崩?(本质)
公开图显示两个环境中的 BC 表现不同,这一现象与易失稳任务更容易出现分布漂移的机制解释一致;本实验没有直接测量状态覆盖或理论复杂度界,因此不据此断定唯一成因。
6.2 DAgger 学习曲线(逐轮 eval 均值 ± std)
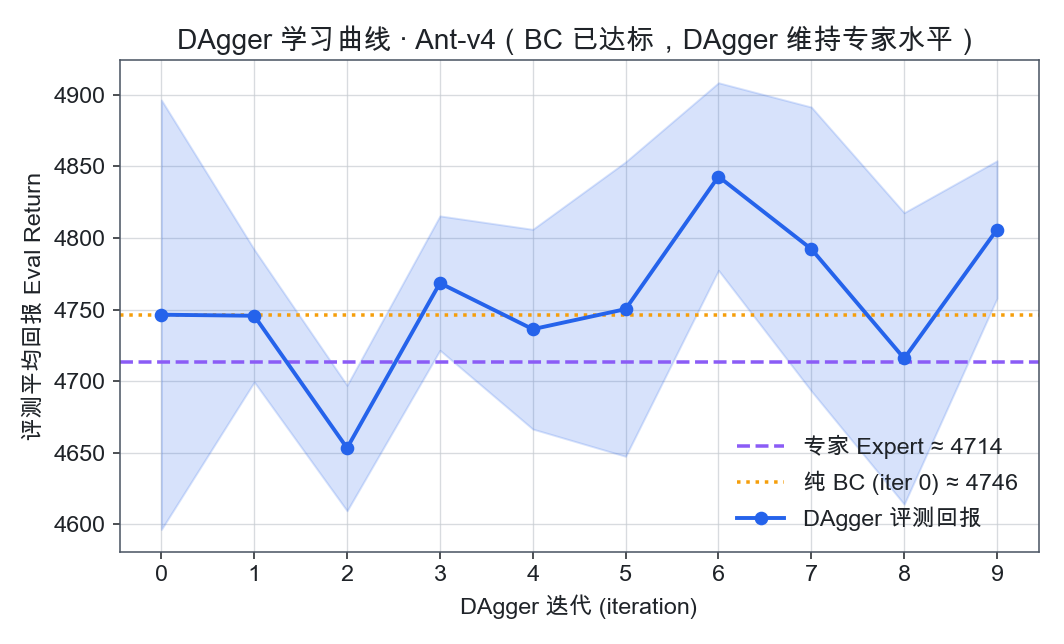
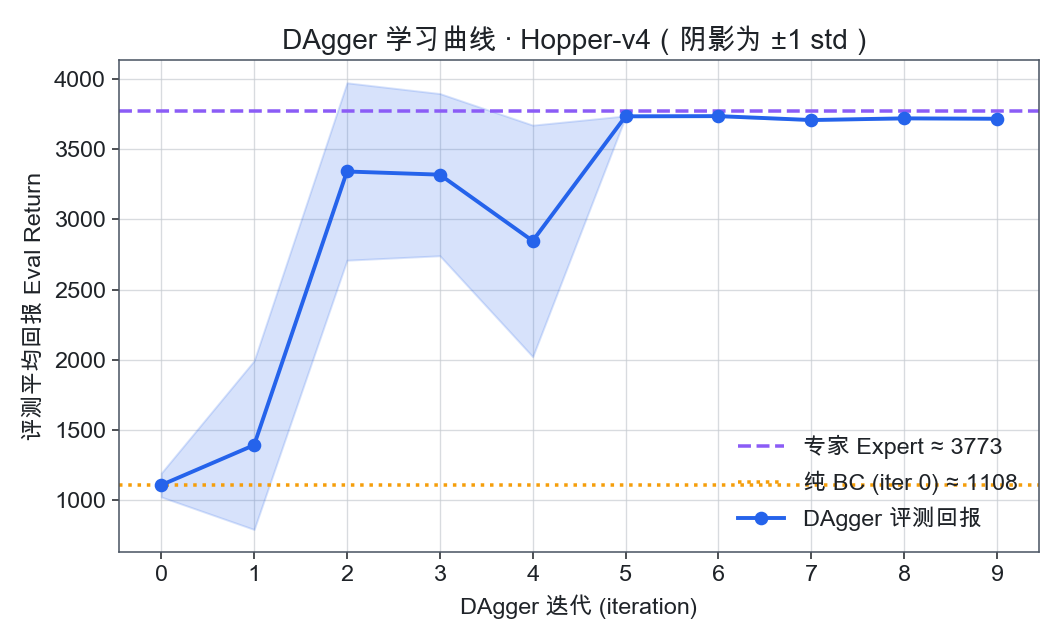
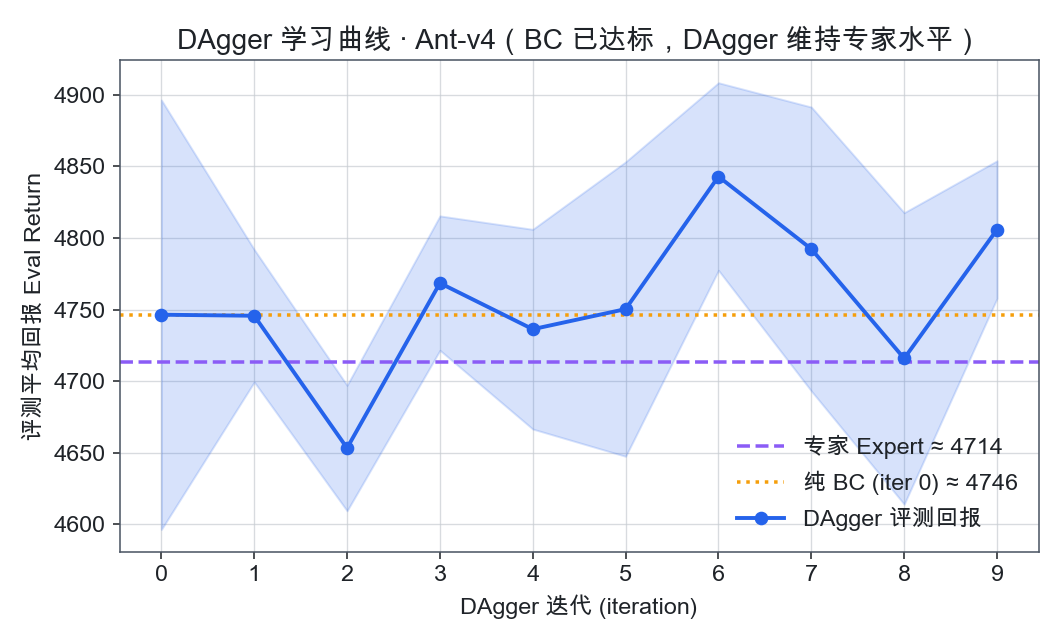
公开曲线显示:Hopper-v4 的评测回报总体随 DAgger 迭代上升,中间存在回撤,后期接近专家参考线;Ant-v4 各轮结果在专家参考线附近波动。
图 2:DAgger 学习曲线 · Hopper-v4。曲线总体上升、有阶段性回撤,后期接近专家参考线。
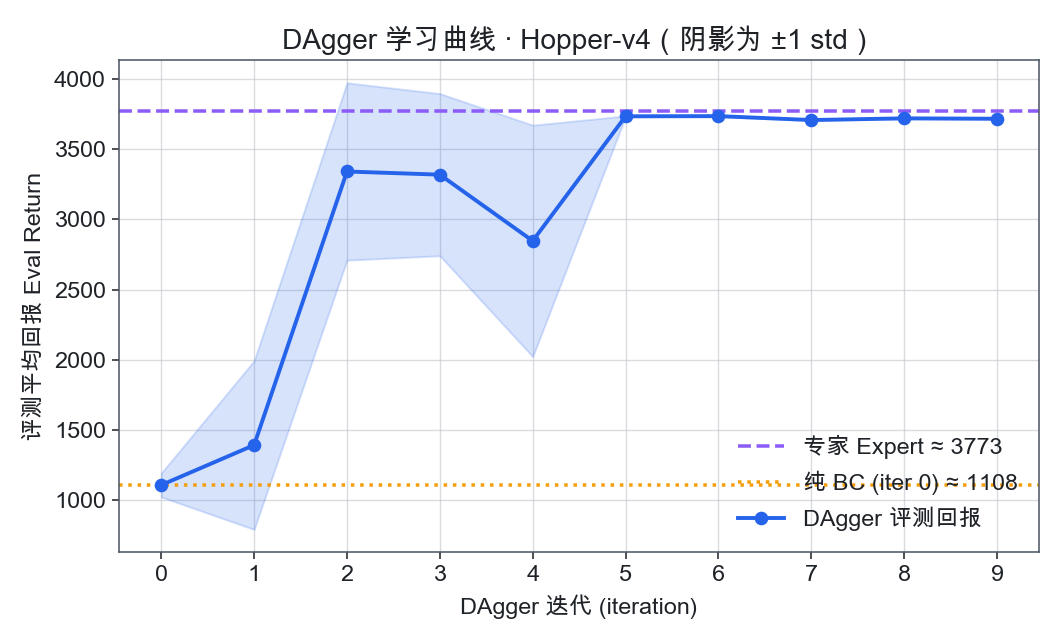
图 3:DAgger 学习曲线 · Ant-v4。各轮结果围绕专家参考线波动。
公开曲线结论
Ant 的 BC 与 DAgger 都接近专家参考水平;Hopper 的 BC 明显较低,而 DAgger 后期接近专家参考线。
6.3 训练损失监控(MSE Training Loss)
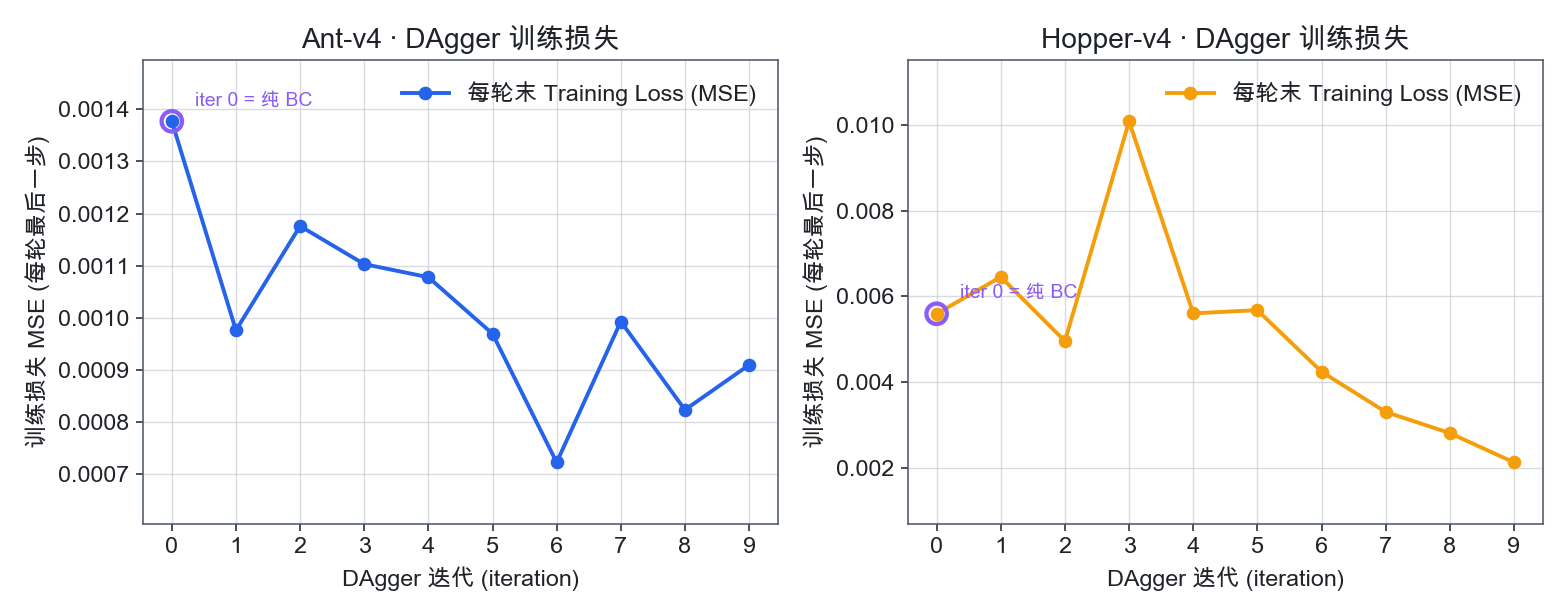
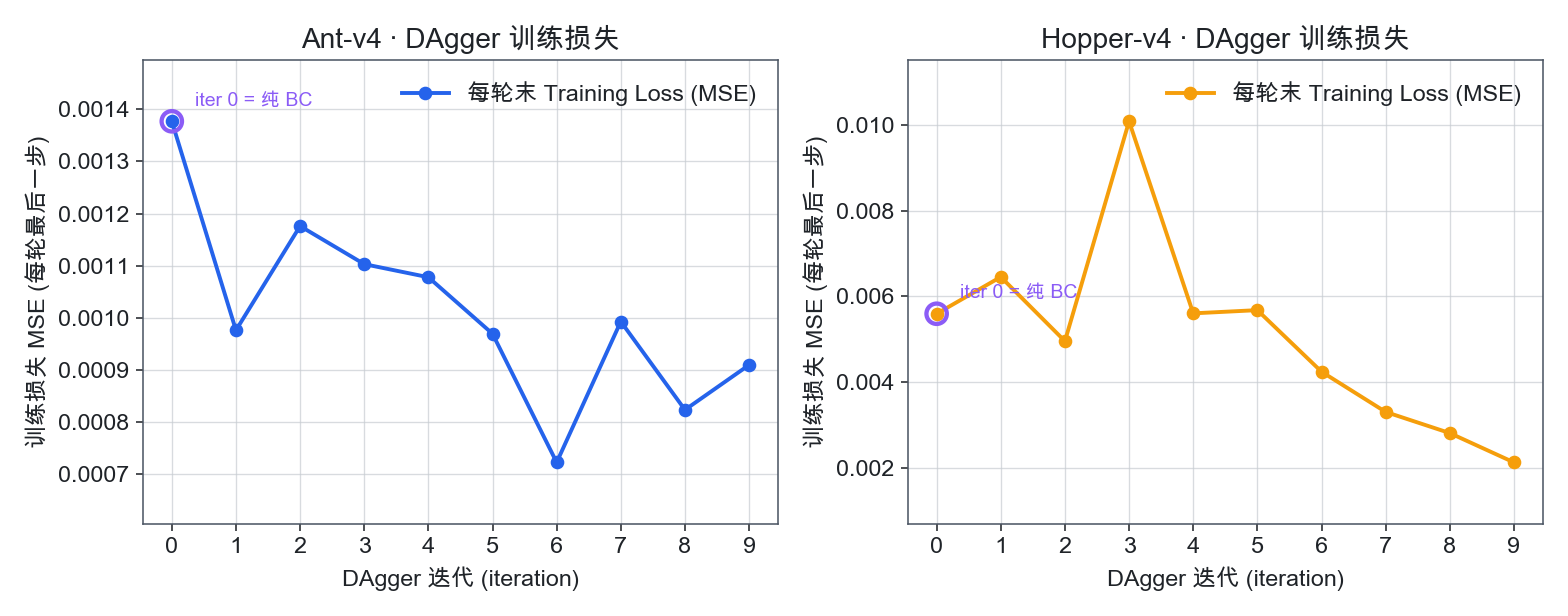
下图展示两个环境的 DAgger MSE 记录。公开图可用于观察曲线形态,但原始标量未公开,因此不列出逐轮精确数值。
图 4:DAgger 训练损失监控。Ant-v4 曲线处于较低量级;Hopper-v4 曲线更高且非单调。图本身不能确定差异的成因。
粒度限制
该图不能替代原始训练日志,也不能单独证明损失变化导致回报变化;这里只保留可直接观察到的非单调曲线形态。
复现附录:专家成功轨迹(视频 1–2)
6.4 成功轨迹演示(视频)
下面两段视频展示 Ant 与 Hopper 的专家策略行为,仅用于观察可见动作。
如何看这两段视频
Ant 视频中四足协调向前爬行;Hopper 视频中单腿连续跳跃并向前推进。
图 0:视频 1:Ant-v4 专家策略轨迹。视频中可见四足协调向前爬行。
图 0:视频 2:Hopper-v4 专家策略轨迹。视频中可见单腿连续跳跃。
6.5 各子实验策略 rollout:BC vs DAgger(学生策略本尊)
§6.4 的两段是专家策略;本节四段为学生策略视频。视频只支撑可见行为,不公开或推断 checkpoint 时点、训练预算、单条回报和选择过程。
图 0:视频 3 · BC · Ant-v4。视频中四足保持协调向前移动。
图 0:视频 4 · BC · Hopper-v4。视频较早结束,可见策略失稳。
图 0:视频 5 · DAgger · Ant-v4。视频中四足保持协调向前移动。
图 0:视频 6 · DAgger · Hopper-v4。视频中策略持续稳定跳跃,时长明显长于 BC 视频。
四段视频的一句话对照
Ant(视频 3 vs 5): 两段均显示协调向前移动。Hopper(视频 4 vs 6): BC 视频较早结束,DAgger 视频持续稳定跳跃;该差异与分布覆盖机制一致,但视频不能单独证明因果。
7. 问题与优化
问题 1:Hopper 的 BC 表现与分布漂移机制一致
Hopper 的 BC 曲线明显低于专家参考线,且公开视频较早结束。该现象与训练分布 ≠ 测试分布的机制解释一致:DAgger 会把学生访问到的状态加入标注与训练;本实验没有直接测量状态覆盖,不能把这一机制写成由当前曲线单独识别出的因果。
优化 2:DAgger 如何逐轮回升
Hopper 曲线总体回升但并非单调,中间有明显回撤,后期接近专家参考线。这一形态与 DAgger 逐步扩展学生访问状态上的监督覆盖相一致,但曲线本身没有直接测量状态分布。
优化 3:方差是比均值更早的信号
曲线的均值和阴影都随迭代变化,因此判断稳定性时应同时观察中心趋势与离散程度;当前证据不能确定某次回撤的具体原因。
优化 4:observation 归一化(本次未做,属改进项)
观测归一化可减少不同输入维度的尺度差异。§8 的有限配置中,归一化配置与 Hopper-v4 上更高的 BC 回报相关;该实验未隔离具体机制,也不能证明提升来自某一类 OOD 姿态。
问题 5:固定单位方差掩盖了多模态
单高斯均值回归不适合表达多模态动作。§8 中 MDN 配置的回报较低,但该结果不能证明本任务专家动作近单峰,也不能据此排除其他多模态方法。
8. 改进方案全实现:能提升多少 reward?
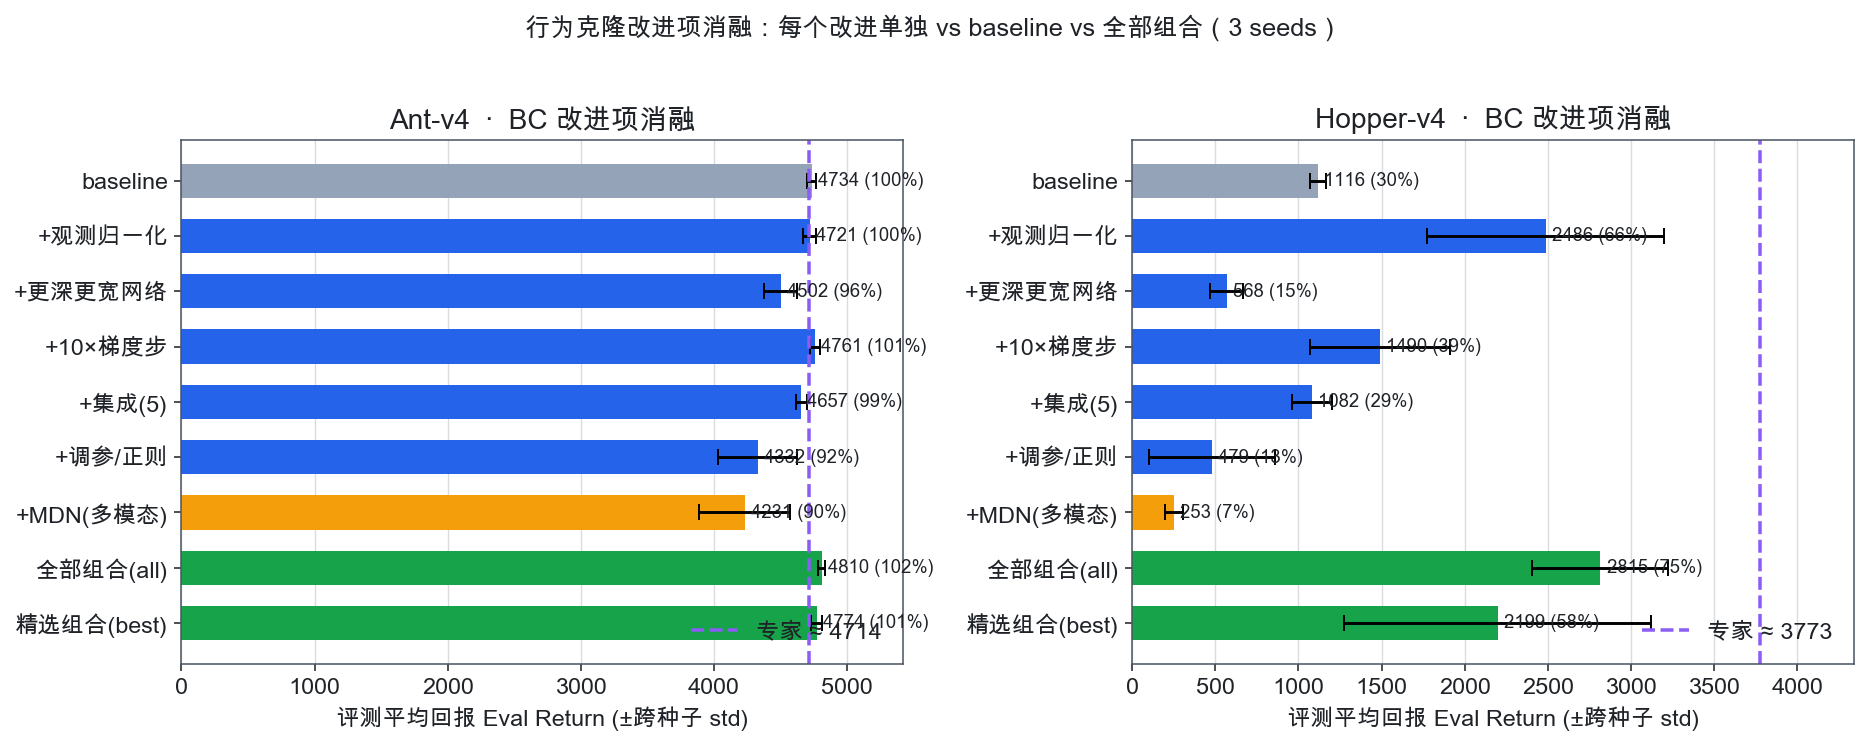
§7 罗列了一组可能的改进。公开消融图标明 BC 结果使用 3 个随机种子;完整运行配置、原始日志与训练次数未公开,因此本节只保留图中可直接核对的配置比较。
先说结论(三句话)
- Ant: 多数配置都在专家参考线附近,部分配置更低。
- Hopper BC: 观测归一化配置高于 baseline;全部组合也高于 baseline,但仍低于专家参考线。
- DAgger: 改进配置在 Hopper 上更早接近专家参考线;该比较只说明有限配置相关性。
8.1 §7 提到的改进:全部清单 + 实现 / 跳过(诚实分类)
公开图比较 baseline、观测归一化、更深更宽网络、更多梯度步、集成、调参/正则、MDN、全部组合和精选组合。图外的实现细节与完整配置未公开,本页不把这些配置差异解释为单因素因果效应。
8.2 消融方法(保证公平可比)
实验协议
图中明确标注 BC 消融使用 seed∈{1,2,3},误差棒为跨种子标准差。其余运行细节未作为公开配置发布,因此不在此补写。
8.3 BC 消融结果(核心交付)
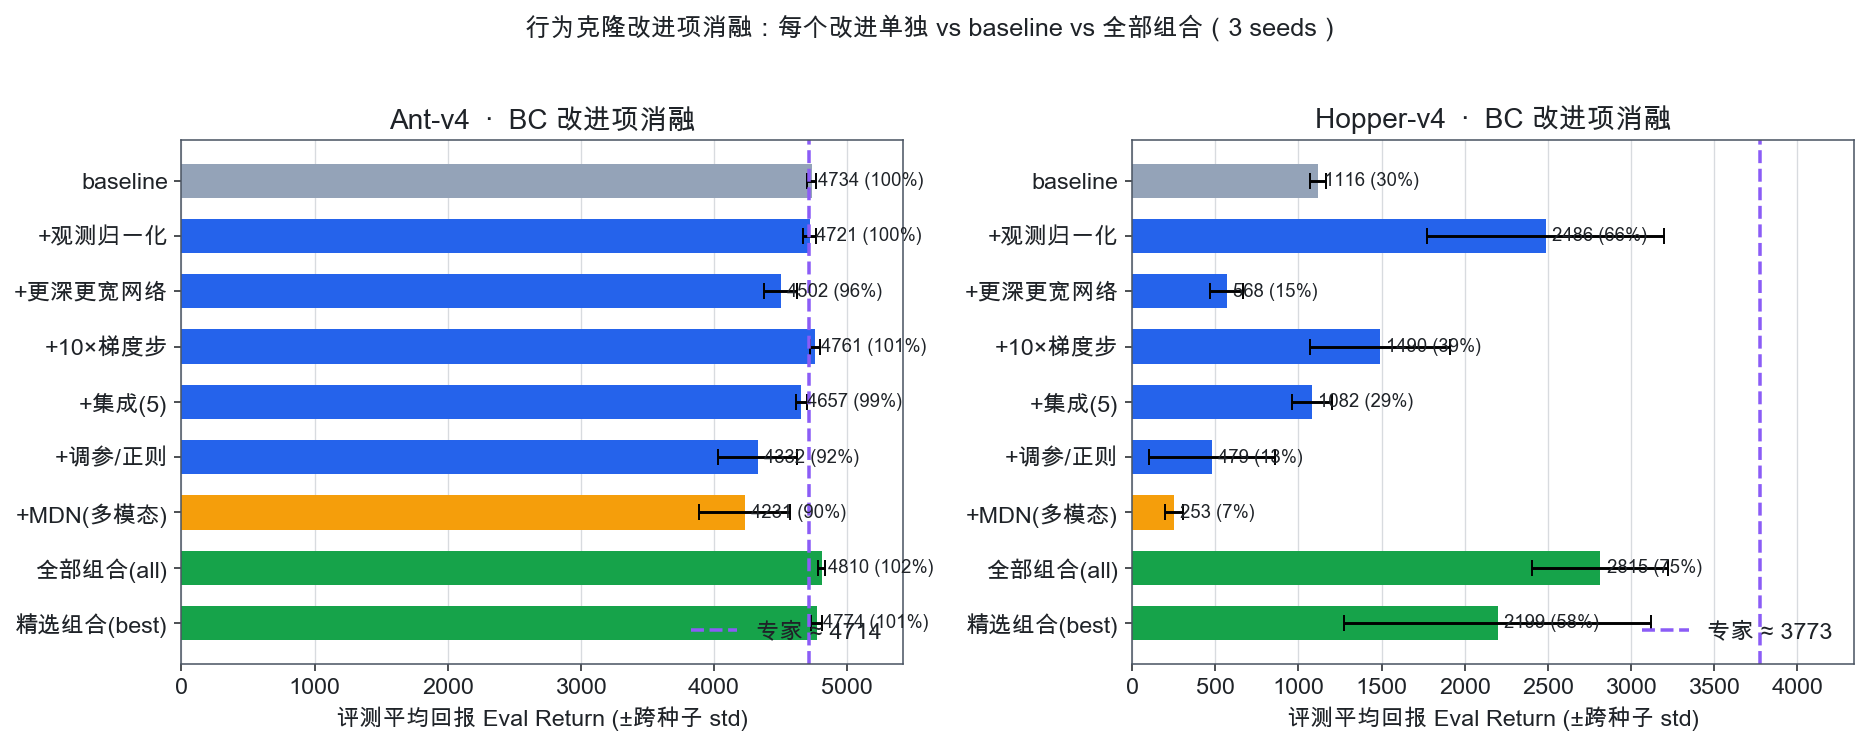
图 5:BC 改进项消融(3 种子,误差棒为跨种子 std,紫虚线为专家)。左侧 Ant 多数配置接近专家参考线;右侧 Hopper 的观测归一化与全部组合高于 baseline,但配置间波动较大且仍低于专家线。
读这张表最该记住的三件事
- 观测归一化: 在 Hopper 的有限配置中与高于 baseline 的回报相关;该实验未验证具体机制。
- 模型与分布头: 更深网络、调参和 MDN 配置在本图中较低,但不能由一次消融归因为过拟合或专家单峰。
- 组合配置: 全部组合高于 baseline,仍低于专家参考线;不能据此分解各组件的独立贡献或交互机制。
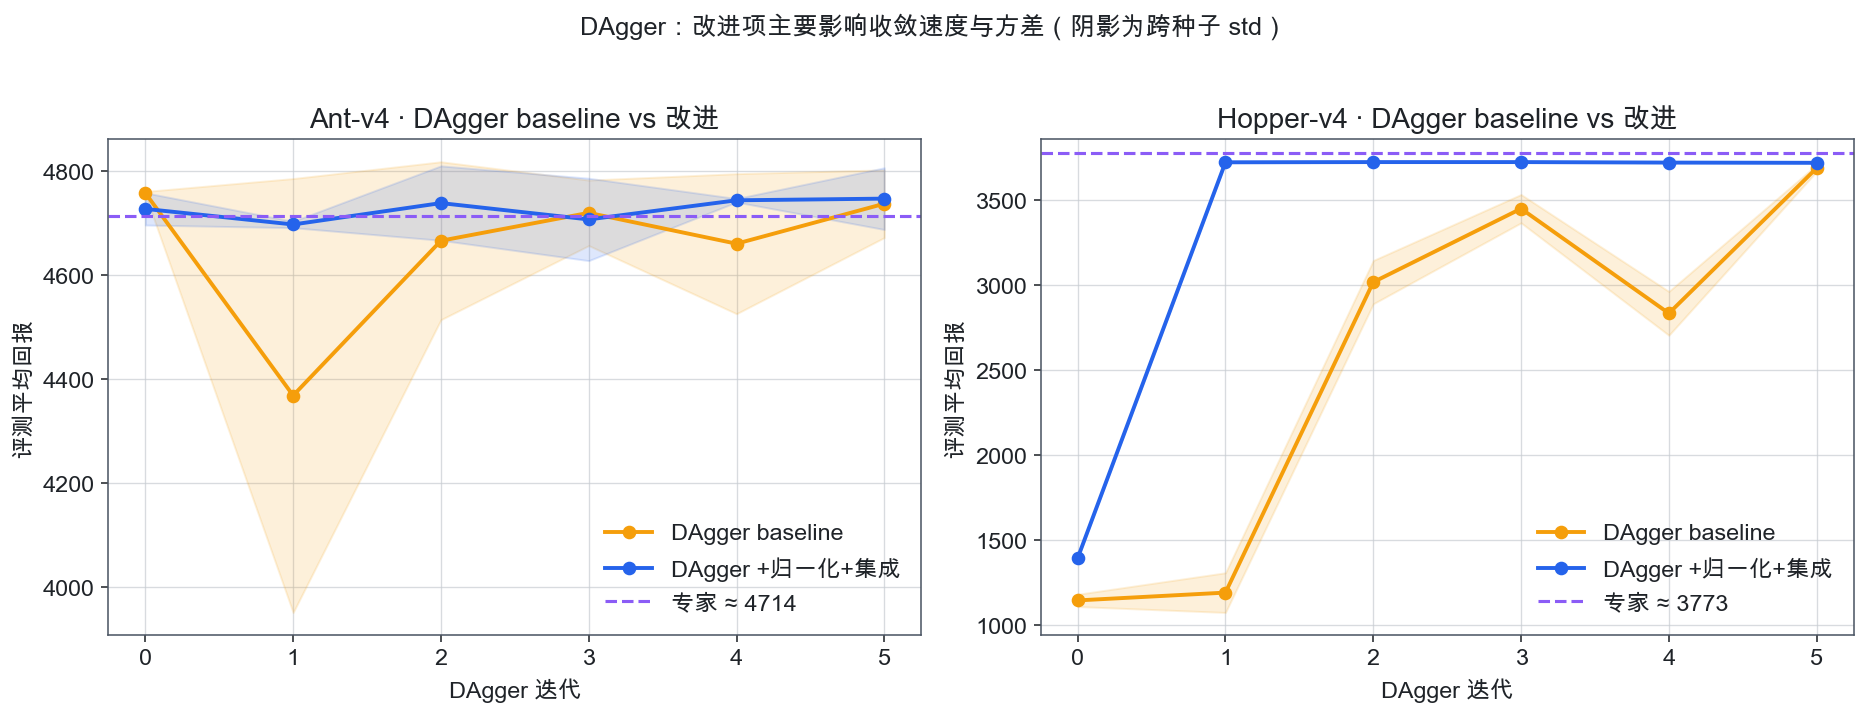
8.4 DAgger:改进买到的是”更快收敛 + 更低方差”,而非更高终值
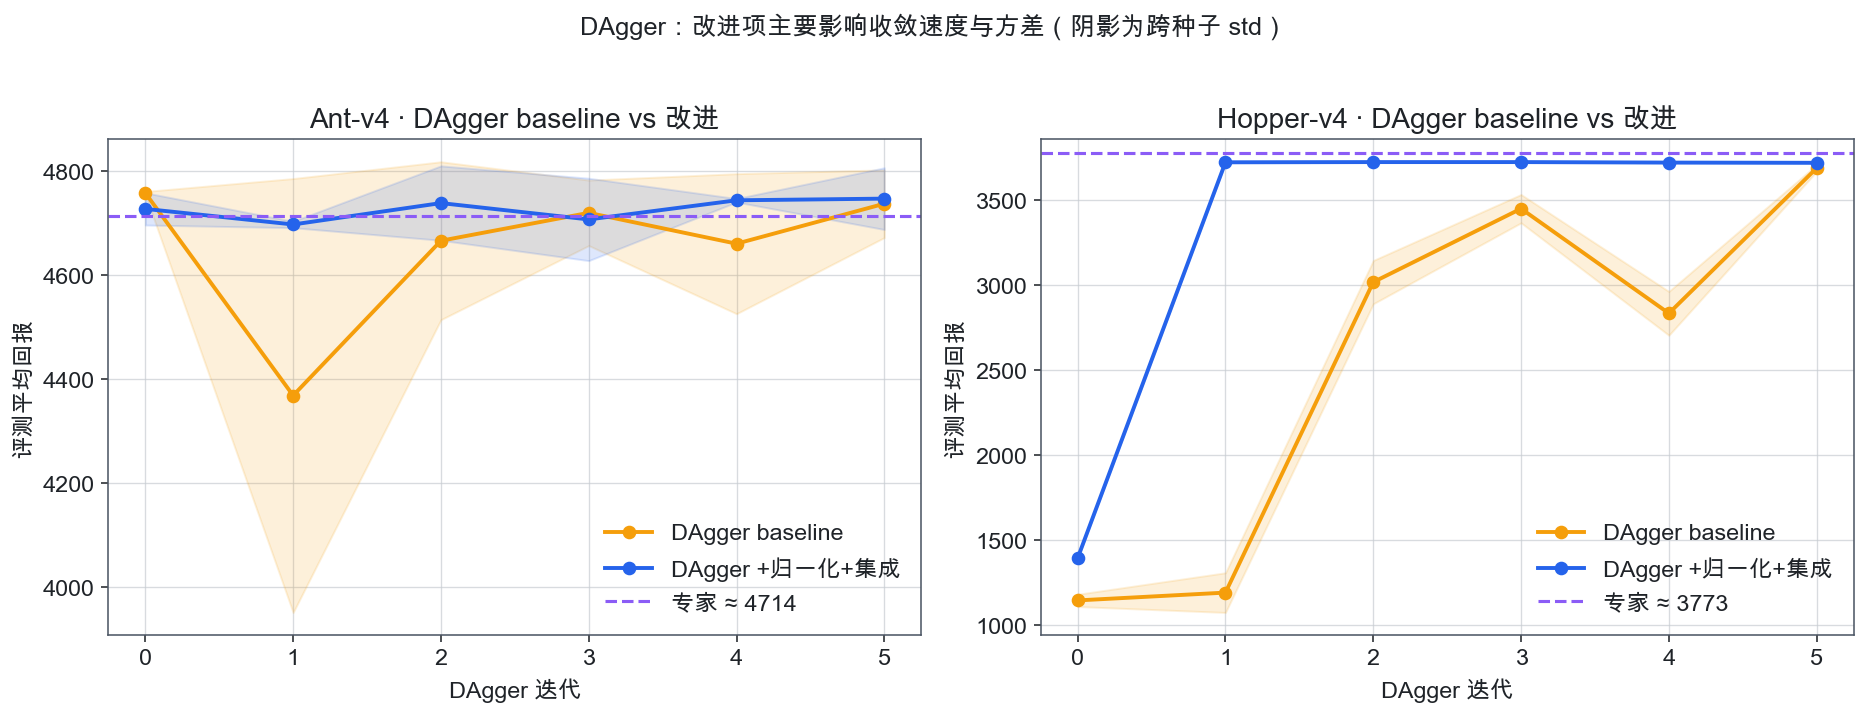
图 6 对比 baseline DAgger 与改进配置。Hopper 的改进曲线更早接近专家参考线;Ant 两条曲线都在专家参考线附近。完整配置未公开,因此只把它们视为两个联合设置的比较。
DAgger 侧的结论
公开曲线显示改进配置在 Hopper 上少 4 轮在线查询便接近专家参考线。这里只报告轮数差异,不把它换算成确定的成本倍数,也不把差异归因于某个单独组件。
Bottom line:照 §7 改进,reward 到底涨多少?
- Ant-v4(BC): 多数配置接近专家参考线,部分配置更低。
- Hopper-v4(BC): 观测归一化与全部组合高于 baseline,但仍低于专家参考线。
- Hopper-v4(DAgger): 改进联合设置更早接近专家参考线;当前证据不支持进一步的成本或单因素因果结论。
本节的诚实性披露(务必如实)
- BC 消融图明确标注 3 种子,配置间误差棒差异较大。
- DAgger 图只支持图中联合设置的曲线比较;完整配置、训练日志和成本未公开。
- 所有机制解释均为与现象一致的候选解释,不是由本次有限消融直接验证的因果结论。
9. 理论 ↔ 实践对接(回扣模块 01)
本节把实测现象逐条对回 模块 01 的理论。
9.1 分布漂移与
模块 01 给出朴素 BC 在相应假设下的 额外代价界。公开图显示 Hopper 的 BC 明显低于专家参考线,而 Ant 接近专家参考线;该差异与分布漂移机制一致,但本实验没有测量逐步错误率 或理论阶数。
9.2 DAgger 把界改善到
DAgger 在 (学生自己的状态分布)上收集专家标注,在相应假设下可将理论界改善为 。Hopper 曲线总体上升并有阶段性回撤,后期接近专家参考线;这是与理论机制一致的现象,不是对复杂度阶数或状态分布的直接测量。
推导直觉:为什么对齐分布就把 降成
关键假设
训练后策略在其自身状态分布 上每步犯错率 。
朴素 BC 的 只在专家分布 上成立;一旦漂移出去就不再有保证,故要为”漂移后的每一步”付代价,。DAgger 让 直接定义在 上,测试时就工作在这个分布里,没有额外漂移项,总代价降为 。
9.3 多模态动作
本作业使用单高斯均值回归;若专家动作多模态,MSE 平均化可能失效。当前实验没有检验 Ant/Hopper 专家动作是否单峰。对多模态动作,模块 01 提出了混合高斯 / 离散化自回归 / 隐变量 / 扩散策略等解法。
9.4 teacher forcing ↔ exposure bias
模块 01 将 BC 的分布漂移与序列生成中的 exposure bias 类比:训练输入来自专家历史,推理时则受到模型自身历史影响。DAgger 在学生访问的状态上补充专家标注,其机制与缓解训练—推理分布错配一致;Hopper 曲线的回升与这一解释一致,但不能单独证明因果。
前沿实践(2024–2026)
本实验只比较 BC 与 DAgger,不据此概括近期模仿学习系统的技术采用情况。
10. 反思
为什么这样:eval 用均值而非采样
能不能不这样? 可以,但会得到误导性的低分。因为 MSE 训练根本没有约束
logstd,采样等于往一个”没学过方差”的分布里加单位噪声。用均值是诚实地反映”MSE 到底学到了什么”。这提醒我们:评测协议必须与训练目标语义一致,否则测的是噪声不是策略。
为什么这样:Hopper BC 明显低于专家参考线
本次曲线中 Hopper 的 BC 明显低于专家参考线。该现象与分布漂移机制一致,但有限配置不能确定唯一原因,也不能说明刻意保留较低结果更合理。
为什么这样:DAgger 对 Ant 几乎无增益
Ant 的 BC 与 DAgger 曲线都接近专家参考线,因此当前公开结果没有显示 DAgger 在该环境上的明显优势。是否省略 DAgger 仍取决于目标、风险与更多重复实验。
数据诚实性 / 本次实验的局限
- 主实验为单种子(seed=1)。 曲线波动可能包含初始化与采样随机性,无法给出严格的跨种子置信区间;§8 的 BC 消融另用图中标注的 3 个种子。
- 原始标量未公开。 本页只保留公开图可核对的趋势,不再列出逐轮 loss、评测批量或墙钟时间。
High-level insight
这份作业用最小的代码量,把”监督学习 vs 序列决策”的根本鸿沟摆在了眼前:数据分布随策略而变。BC 假装它不变(i.i.d.),于是在稳定任务上侥幸成功、在不稳定任务上二次崩溃;DAgger 承认它会变,并把监督主动铺到策略真正会去的地方,于是把 压回 。理解这一点,你就理解了从 DAgger 到今天 LLM 的 RLHF、到机器人 VLA 的一整条主线——它们都在回答同一个问题:如何在”模型自己造成的分布”上拿到正确的监督信号。
Claim–Evidence 对照
证据文件
12 个文件