CS285 HW3 实验报告:深度 Q 学习与 Actor-Critic
本报告迁移自原课程材料,经 AI 事实核查未发现存疑项,未逐页人工审核;结论与证据请以页面列出的原始文件为准。
实验目标
HW3 分两大部分,分别对应"价值方法"与"Actor-Critic"两条主线:
实验设置
| 环境 | HW3 横跨离散控制(DQN 侧)与连续控制(Actor-Critic 侧)共四个环境。下表逐一列出各环境的状态空间、动作空间、奖励、时限(horizon)与目标;所有维度均经代码/运行时核对——LunarLander 来自本仓库自带的定制实现 cs285/envs/box2d/lunar_lander.py(N_OBS_DIM=9、N_ACT_DIM=6、register(max_episode_steps=1000, reward_threshold=200)),其余三个由 gym.make(...) 实测其 observation_space / action_space / spec(本机 gym 0.25.2),无任何编造。 |
|---|---|
| 随机种子 | 1、2 |
| 关键配置 | 无 |
本报告迁移自 CS285 课程材料 [1]。
本报告是 模块 05(价值方法 · 致命三要素 · 过估计) 与 模块 04(Actor-Critic · 优势 · bootstrap) 的动手配套。Part 1 实现并评估 DQN / Double-DQN(在 LunarLander 上对比过估计与稳定性);Part 2 把 hw2 的策略梯度改造成 Actor-Critic,在 CartPole 上做 target-update × grad-step 的消融,并在 MuJoCo 的 InvertedPendulum / HalfCheetah 上验证连续控制。本站公开证据包括训练曲线、损失图和 rollout 视频;正文中的实验数字以这些文件可核对的范围为准。实验使用 CPU,并对训练步数做了显式降规模,见第 4 节。
本报告要回答的问题
- DQN 能不能在缩减到 30 万步的 LunarLander 上学出正回报?曲线与 Q 值长什么样?
- Double-DQN 相对 vanilla DQN,究竟在哪里更好——过估计、方差、还是最终回报?用日志数值逐项对照。
- Actor-Critic 的 critic 为什么必须”反复重算 target × 多步梯度”?为什么
-ntu 1 -ngsptu 1会训不动?- 这些实测现象如何回扣模块 05 的致命三要素 / max 过估计 与模块 04 的优势估计 / bootstrap 偏差-方差权衡。
一句话结论
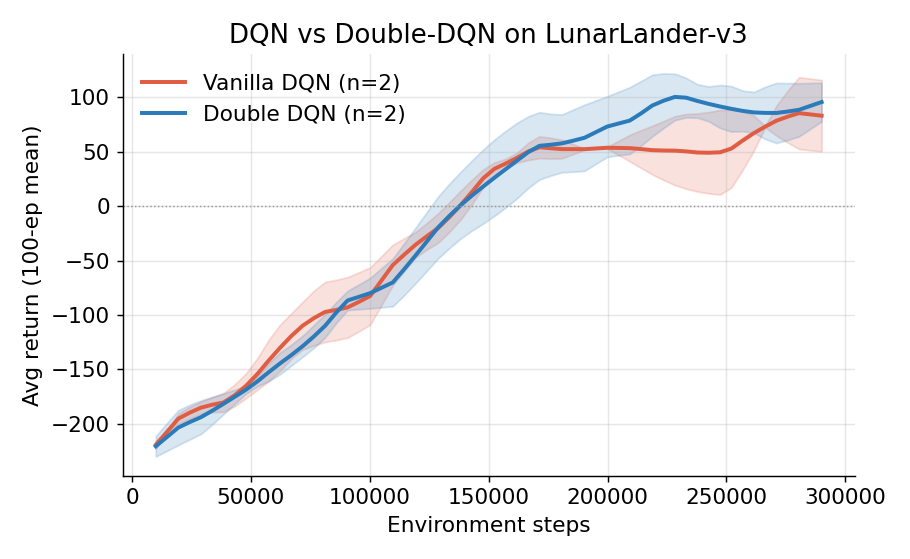
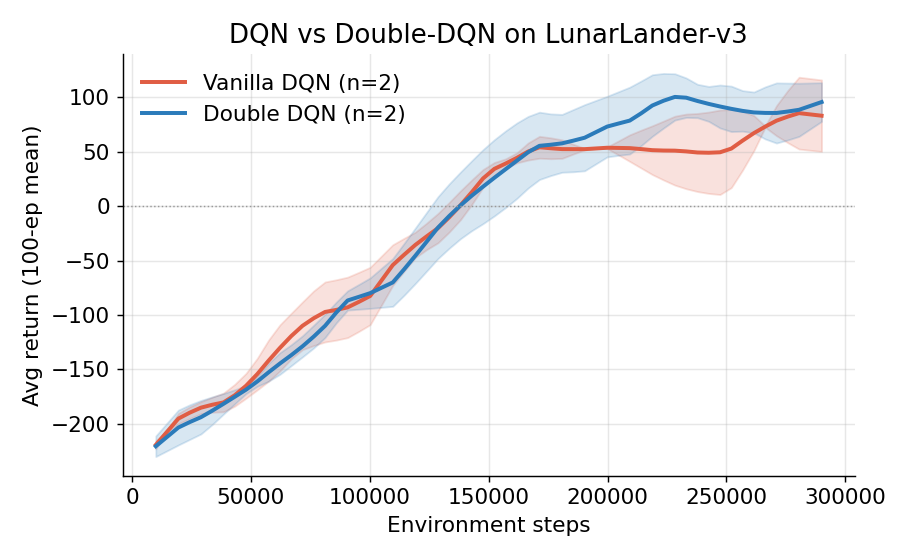
DQN 在 30 万步内把 LunarLander 从约 −220 学到正回报;Double-DQN 全程给出更低的 Q 估计(训练中段约为 vanilla 的一半:≈12 vs ≈21)、更低的种子间方差(±17.8 vs ±32.9)与更高的平均回报(95.8 vs 83.3)——与“Double-DQN 缓解选择偏差”的机制一致,但 2 个种子与无 真值不足以构成完整因果验证。Actor-Critic 侧,
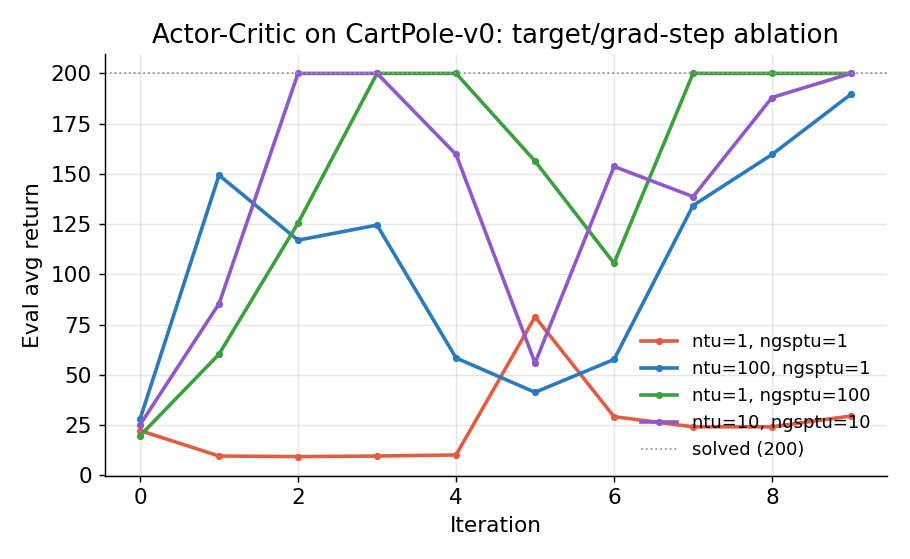
ntu=1,ngsptu=1卡在约 30 分(失败),而只要把”target 重算”或”梯度步”任一拉大,CartPole 就能到 200;连续控制上 InvertedPendulum 打满 1000、降规模后的 HalfCheetah 达到约 124(峰值 136),趋势完全正确。
证据口径 / 复现契约
- 环境: Python 3.9;gym 0.25.2;torch 1.13.1;NumPy 1.26.4;MuJoCo 2.3.3;Box2D 2.3.8;全程 CPU。
- 重复与误差条: DQN/Double-DQN 各 2 seeds,图中带为两 seed 的 min–max;AC 连续控制为单 seed,阴影为评测轨迹间 std。
- 预算: DQN 500k→300k、3→2 seeds;HalfCheetah batch 30000→10000、150→80;LunarLander 代替 Atari。
- checkpoint / 视频: 正文 run 只存标量;视频为按报告口径重训后的 best-eval checkpoint,并可能选最好渲染轨迹,不能代表平均性能。
- **公开证据:**训练曲线、损失图和四段 rollout 视频均在本页
evidence/目录;原始 TensorBoard 日志、代码和 checkpoint 不随本站发布。【两种子趋势:DQN】【受控消融:AC 更新次数】【机制一致性】 没有 真值,较低批均值 Q 是 Double-DQN 机制的间接证据,不是完整因果验证。
1. 作业目标与要求
HW3 分两大部分,分别对应”价值方法”与”Actor-Critic”两条主线:
| 部分 | 算法 | 核心新增实现 | 作业代号 |
|---|---|---|---|
| Part 1 | DQN / Double-DQN | Q 网络 + target 网络硬更新、Bellman target、Double-DQN 的”选/评”解耦、replay buffer 的两段式存取、argmax 贪婪策略 | q1/q2/q3 |
| Part 2 | Actor-Critic | critic 的 bootstrap 目标回归(ntu×ngsptu)、优势 、actor 的 PG 更新 | q4/q5 |
课程作业把 DQN、Double-DQN 与 Actor-Critic 的关键实现放在统一实验框架中;本报告只比较本站公开曲线中的本次运行结果,不把原型中未随本站公开的参考数字作为核查依据。
代码起点:本次几乎所有 TODO 都已由原创实现补全
本仓库的 hw3 骨架里,
infrastructure/、policies/中”从 hw1/hw2 搬运”的部分与 DQN/AC 的新增 TODO 均已用原创代码填好(含中文注释),本报告第 5 节逐段讲解这些实现。除必要的 TODO 外,仅为”降规模”新增了一个--num_timesteps命令行开关、并在 DQN critic 的返回里多记了两个 Q 统计量用于观测过估计(见 5.2),未改动其它模块或报告文件。
2. 环境与任务介绍
HW3 横跨离散控制(DQN 侧)与连续控制(Actor-Critic 侧)共四个环境。下表逐一列出各环境的状态空间、动作空间、奖励、时限(horizon)与目标;所有维度均经代码/运行时核对——LunarLander 来自本仓库自带的定制实现 cs285/envs/box2d/lunar_lander.py(N_OBS_DIM=9、N_ACT_DIM=6、register(max_episode_steps=1000, reward_threshold=200)),其余三个由 gym.make(...) 实测其 observation_space / action_space / spec(本机 gym 0.25.2),无任何编造。
| 环境 | 状态空间 | 动作空间 | 奖励 | 时限 (horizon) | 目标 / 参考线 |
|---|---|---|---|---|---|
| LunarLander-v3 (Part 1,定制版) | 连续 9 维 Box(着陆器位置 、速度 、朝向角、角速度、两条腿是否触地、着陆坪 ) | 离散 6(Discrete(6):主/侧引擎的不同点火组合;注意定制版是 6 动作而非标准 LunarLander 的 4 动作) | 整形奖励(距离/速度/角度接近着陆坪为正、腿触地 +10)− 燃料惩罚(主引擎 ≈−0.3/步);终止时坠毁/出界 −100、成功着陆 +100 | ≤ 1000 步(着陆/坠毁/出界/超时即止),本作业 (有限步、无折扣) | 学会软着陆;README 阈值回报 200(“好智能体 >150”) |
| CartPole-v0 (Part 2,AC 消融) | 连续 4 维 Box(小车位置、小车速度、杆角度、杆角速度) | 离散 2(Discrete(2):向左/向右施加固定推力) | 每存活一步 +1(杆倒下或小车出界即终止) | 200 步(max_episode_steps=200) | 尽量久地保持杆竖直,满分回报 200(阈值 195) |
| InvertedPendulum-v4 (Part 2,连续控制) | 连续 4 维 Box(小车位置/速度、摆角/角速度,MuJoCo 物理) | 连续 1 维(Box(-3, 3, (1,)):作用在小车上的水平力) | 每存活一步 +1(摆偏离竖直超阈值即终止) | 1000 步;本作业 | 平衡倒立摆,回报逼近 1000(阈值 950) |
| HalfCheetah-v4 (Part 2,连续控制) | 连续 17 维 Box(各关节角度/角速度与躯干状态,MuJoCo 物理) | 连续 6 维(Box(-1, 1, (6,)):6 个关节的归一化力矩) | 前进奖励(沿 前进速度)− 控制代价();可正可负 | 环境上限 1000 步;本作业 --ep_len 150、 | 学会快速奔跑;官方阈值 4800,本作业降规模下参考线 ≈150(80 轮 / b=10000) |
本作业要完成的两个任务(Task 复述)
- 任务 (a) · DQN vs Double-DQN 的过估计对比: 在离散的 LunarLander 上实现 vanilla DQN 与 Double-DQN,逐项对照二者的 Q 值过估计、种子间方差与最终回报,检查与“max 选择偏差可能放大不稳定”一致的间接证据,以及 Double-DQN 用“online 选、target 评”去偏的效果。
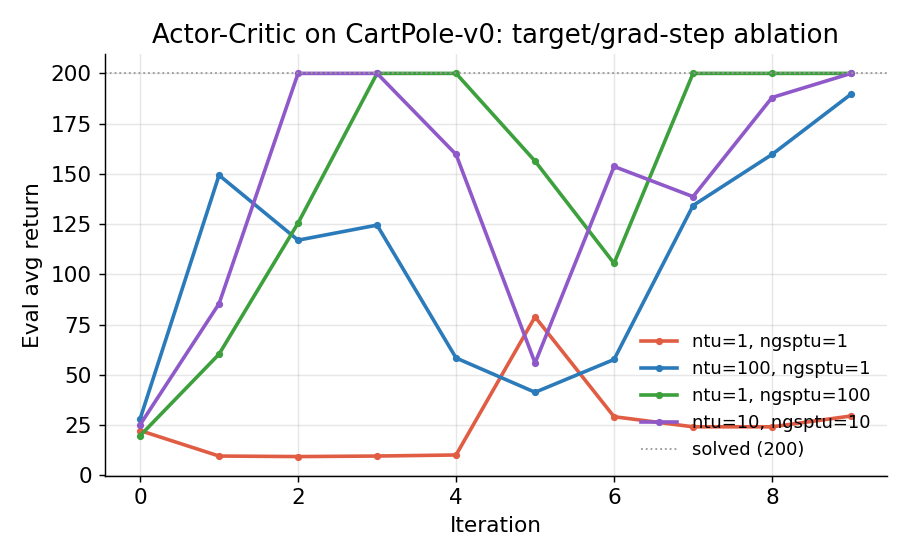
- 任务 (b) · Actor-Critic 的 target-update×grad-step 消融与连续控制: 把 hw2 的策略梯度改造成 AC,在 CartPole 上做
ntu×ngsptu的 4 组消融(1×1 / 100×1 / 1×100 / 10×10),说明“critic 拟合充分度”为何是 AC 的瓶颈;再把选定配置用于 InvertedPendulum / HalfCheetah 两个连续控制环境验证可扩展性。
3. 环境搭建与踩坑
复用已有 conda 环境 cs285(Python 3.9)。本次未新增额外深度学习依赖——环境里已具备运行所需的一切。实际解释器与关键包版本(python -c "import ...; __version__" 实测):
| 包 | 实测版本 | 作用 / 备注 |
|---|---|---|
gym | 0.25.2 | 环境接口(旧 step API,返回 4 元组) |
torch | 1.13.1 | Q 网络 / 策略 / critic 与优化 |
numpy | 1.26.4 | gym 0.25 不兼容 NumPy 2.0,必须锁 1.x |
mujoco | 2.3.3 | 新版 MuJoCo Python 绑定,服务 -v4 环境 |
Box2D | 2.3.8 | LunarLander 物理后端 |
ale-py | 0.7.5 | Atari 学习环境(已装,但本次未做全量 Atari 训练,见下) |
tensorboard | 2.10.0 | 标量日志(本报告数字来源) |
踩坑 1(最耗时):editable 包
cs285被其它 hw 抢占,import 到错的目录本机三个作业(hw1/hw2/hw3)共用同一个 conda 环境,且都以
pip install -e .的方式把顶层包名注册成cs285。三个仓库都没有__init__.py(靠 namespace package + editable finder 定位),于是site-packages里的 editable finder 只能指向一个 hw 目录。实测中该指针在运行期间被并发进程反复改写(先指向 hw1、我重装指到 hw3、几分钟后又被改回 hw2),导致import cs285.agents.dqn_agent时不时报ModuleNotFoundError(因为解析到了没有该文件的 hw2)。
解法: 不依赖这个脆弱的共享指针,改用一个启动壳把 editable finder 从sys.meta_path剥掉、并把 hw3 目录插到sys.path最前,再用runpy.run_path执行脚本。这样每次运行都强制解析到 hw3,且对并发改写免疫。核心片段:(此处的实现代码或复现命令不在本站发布。)
踩坑 2:Apple MPS 缺算子,离散 Actor-Critic 直接崩
init_gpu默认按 CUDA → MPS → CPU 回退,本机会选中 Apple MPS。DQN(LunarLander)在 MPS 上能跑,但 CartPole 的离散 Actor-Critic 在采样时会走到Categorical的取值校验,触发aten::remainder.Tensor_out——该算子MPS 尚未实现,直接抛NotImplementedError。
解法: 所有实验统一加--no_gpu强制 CPU(并顺手export PYTORCH_ENABLE_MPS_FALLBACK=1兜底)。CPU 上小 MLP 本就不慢,且保证了 DQN/AC 数值口径一致。
踩坑 3:MuJoCo
-v2需要老mujoco_py,改用-v4README 里 InvertedPendulum/HalfCheetah 写的是
-v2,但-v2依赖已弃用的mujoco_py(本机未装,gym.make('HalfCheetah-v2')报No module named 'mujoco_py')。新版mujoco(2.3.3) 绑定对应的是-v4环境,实测InvertedPendulum-v4 / HalfCheetah-v4可正常make+reset。本报告一律用-v4,物理与观测语义与-v2基本一致,属语义无损的版本升级。
关于 Atari(依赖已备,但按 README 降级到轻量环境)
ale-py0.7.5 已在环境中,理论上可跑 MsPacman/Pong。但 Atari 的 DQN 用卷积网络且默认num_timesteps=2×10⁸,官方口径就是”1M 步≈3 GPU-小时”;在纯 CPU 上做全量 Atari 完全不现实。README 明确允许”用 LunarLander-v3 检验正确性”,因此 Part 1 全部用 LunarLander-v3(Box2D,MLP,1 帧观测)——这既能干净地展示 DQN vs Double-DQN 的过估计对照,又把算力用在刀刃上。LunarLander-v3由register_custom_envs()在运行时注册(实测观测 9 维、离散 6 动作)。
4. 实验 setting(真实超参 + 降规模说明)
4.1 降规模总览(显式声明)
本次相对官方口径的三处缩减(其余均为默认)
- DQN 训练步数:500k → 300k(LunarLander)。新增
--num_timesteps 300000。关键细节:LunarLander 的 ε 退火时间表按num_timesteps比例计算,故降步数时该时间表同步缩放(否则 ε 会一直停在高位、根本学不动)。- HalfCheetah:batch 30000→10000、迭代 150→80。 其余(
-l 2 -s 32 -lr 0.02 --discount 0.90 --ep_len 150 -ntu 10 -ngsptu 10)照官方。- DQN 种子数:3 → 2(每个变体跑 seed 1、2)。CPU 预算所限;2 个种子已足以显示 vanilla 的高方差(一个种子后期回落)。
目标是展示正确趋势(DQN vs Double-DQN 过估计与稳定性、AC 的 target/grad-step 权衡),而非全尺度刷分。InvertedPendulum、CartPole 均按官方规模。
4.2 DQN(LunarLander-v3)关键超参
来自 get_env_kwargs('LunarLander-v3')(dqn_utils.py)+ 命令行:
| 超参 | 取值 | 说明 |
|---|---|---|
| Q 网络 | MLP 64-64(ReLU) | create_lander_q_network |
gamma | 1.00 | LunarLander 为有限步 episode,用无折扣 |
learning_starts / learning_freq | 1000 / 1 | 先填 1000 步再学;每 env step 学 1 次 |
target_update_freq | 3000 | 每 3000 次参数更新硬拷贝一次 target 网络 |
replay_buffer_size / batch_size | 50000 / 32 | |
| 优化器 / 学习率 | Adam / 1e-3 | lander_optimizer |
| ε 退火 | 1 → 0.02,历时 0.1·num_timesteps | 降规模时按比例缩短 |
grad_norm_clipping | 10 | Huber loss + 梯度裁剪 |
double_q | False / True | vanilla / Double-DQN 的唯一区别 |
实际运行命令(每条各 seed 1、2):
(此处的实现代码或复现命令不在本站发布。)
4.3 Actor-Critic 超参
| 环境 | 命令要点 | ntu × ngsptu |
|---|---|---|
| CartPole-v0 | -n 100 -b 1000(4 组消融) | 1×1 / 100×1 / 1×100 / 10×10 |
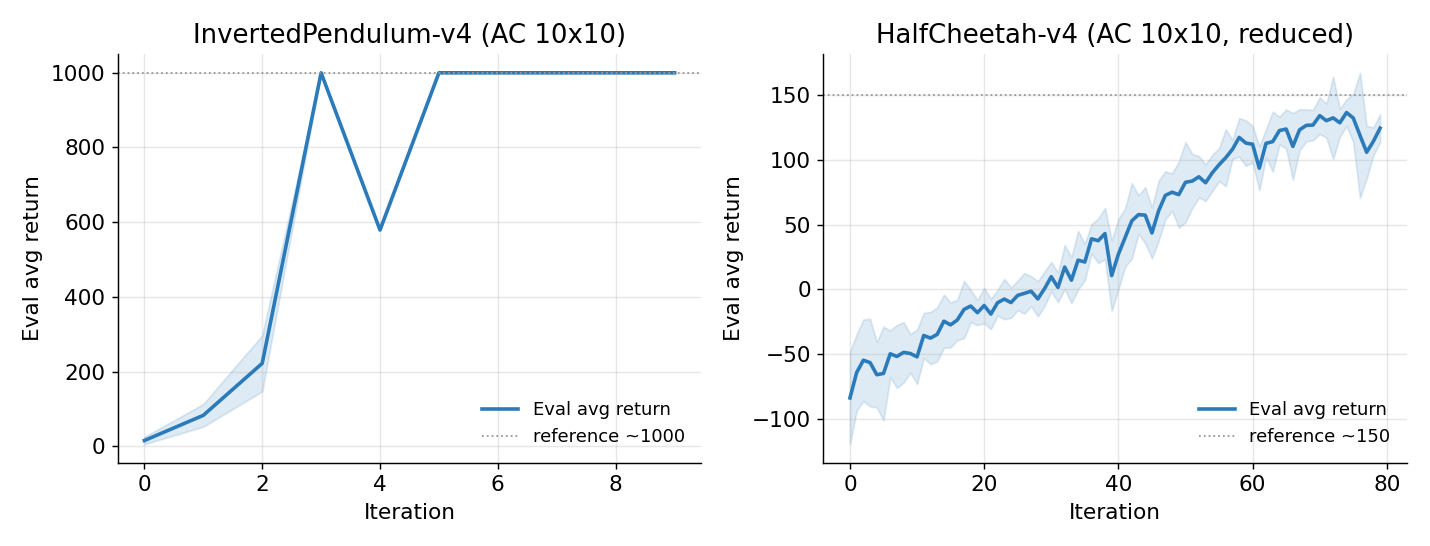
| InvertedPendulum-v4 | --ep_len 1000 --discount 0.95 -n 100 -l 2 -s 64 -b 5000 -lr 0.01 | 10×10 |
| HalfCheetah-v4 | --ep_len 150 --discount 0.90 -n 80 -l 2 -s 32 -b 10000 -eb 1500 -lr 0.02(降规模) | 10×10 |
其中 -ntu=num_target_updates(重算 target 的次数),-ngsptu=num_grad_steps_per_target_update(每次 target 下的梯度步数);优势默认做标准化(standardize_advantages=True)。全部加 --no_gpu。
5. 代码实现讲解
5.1 argmax 贪婪策略(DQN 的 actor)
DQN 的”策略”就是对 Q 取 argmax;ε-greedy 的随机探索不在这里、而在 step_env 外层处理。注意用 ndim 兼容向量观测(升 2 维)与图像观测(升 4 维):
(此处的实现代码或复现命令不在本站发布。)
5.2 DQN critic:target 网络、Bellman 目标与 Double-DQN 解耦
这是 Part 1 的核心。online 网络给出当前 的 ;下一状态用target 网络估值(慢变、稳定);double_q 分支把”选动作”(online 的 argmax)与”评动作”(target 的取值)解耦:
(此处的实现代码或复现命令不在本站发布。)
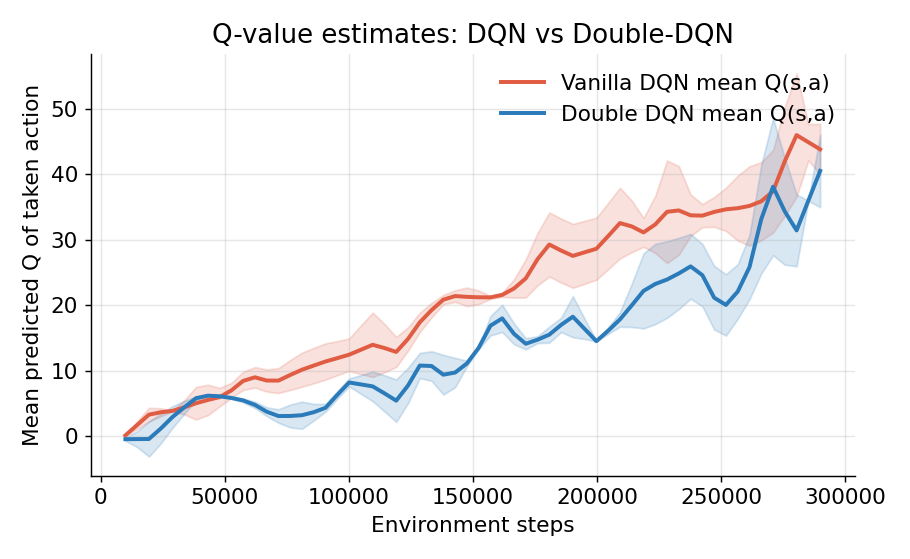
为观测过估计,我在返回字典里额外记录两个统计量(本报告图 3 的数据来源)——这是除必要 TODO 外唯一为观测而加的东西:
(此处的实现代码或复现命令不在本站发布。)
target 网络的硬更新(周期性整包拷贝参数):
(此处的实现代码或复现命令不在本站发布。)
5.3 DQN agent:replay buffer 两段式存取 + 更新触发
MemoryOptimizedReplayBuffer 采用”先存帧、后挂 effect”的省内存设计:store_frame(obs) 拿到索引 → env.step → store_effect(idx, a, r, done)。采样时按 frame_history_len 拼历史帧:
(此处的实现代码或复现命令不在本站发布。)
(此处的实现代码或复现命令不在本站发布。)
5.4 Actor-Critic:critic 的 bootstrap 回归(ntu × ngsptu)
PDF 强调的”来回切换”:用当前 critic 算 target(no_grad)→ 在这组 target 上跑 ngsptu 步梯度 → 重算 target → 重复 ntu 次。总梯度步数 = ntu × ngsptu:
(此处的实现代码或复现命令不在本站发布。)
5.5 优势估计与 actor 更新
一步 TD 残差做优势,终止步把 bootstrap 截断为 0;随后按可选标准化,交给 actor 做与 hw2 一致的 PG 更新:
(此处的实现代码或复现命令不在本站发布。)
AC 主循环:先做 num_critic_updates_per_agent_update 次 critic 更新(内部即 4.4 的双层循环),再估优势,最后做 actor 更新。
6. 实验结果(表 + 图)
【DQN:2 seeds】【AC:单 seed】 Double-DQN 的较低批均值 Q 是间接机制证据;无 真值,不能作完整因果验证。
6.1 DQN 学习曲线(单种子细节)
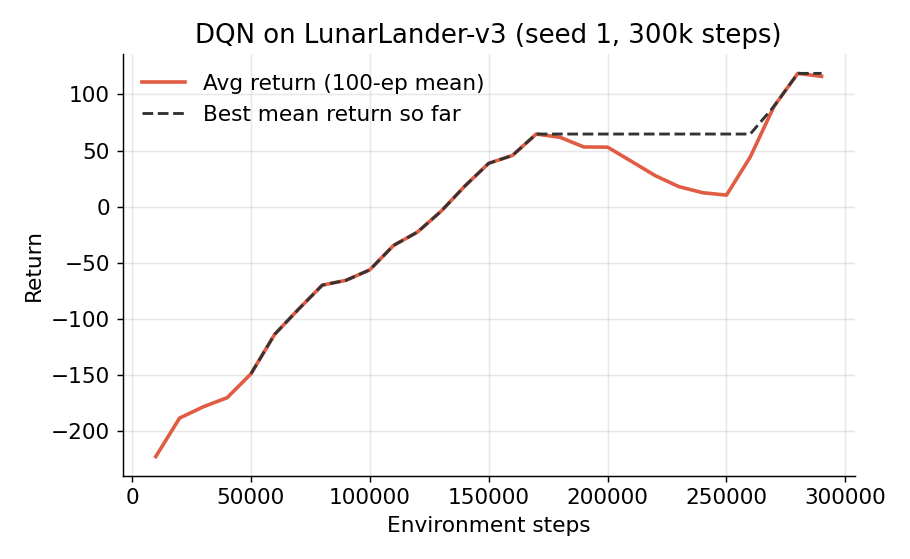
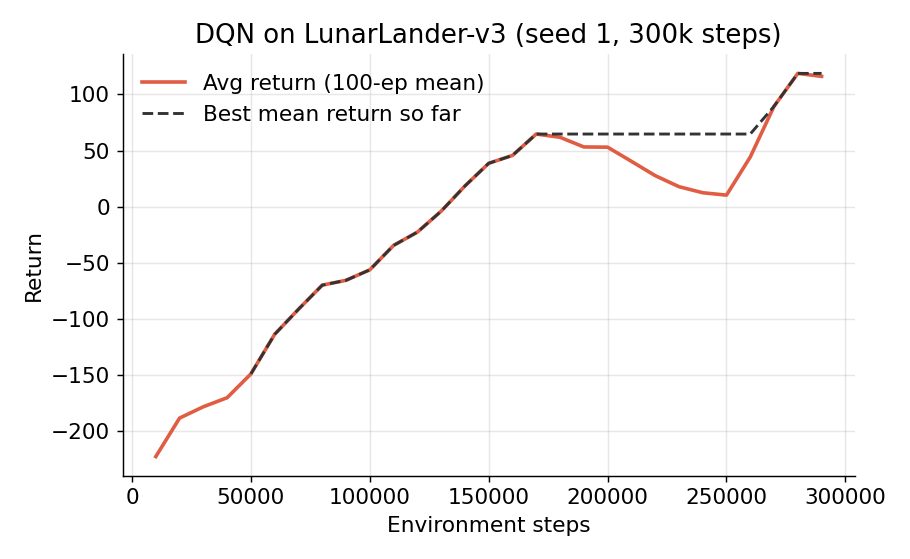
下图为 vanilla DQN(seed 1,30 万步)的 100-episode 平均回报与”历史最好均值”。可见回报在约 17 万步登顶约 65,随后回落到约 10(25 万步),末段又反弹到约 116——即便是较好的种子,中途也出现了明显的不稳定。
图 1:DQN on LunarLander-v3(seed 1,30 万步,降自默认 50 万)。实线为 100-ep 平均回报,虚线为历史最好均值——虚线在 17.5万–26万步之间”压平”,正是回报回落、无新高的一段。
6.2 DQN vs Double-DQN:回报(跨种子平均)
| 算法 | seed1 末回报 | seed2 末回报 | 均值 ± std(n=2) | 备注 |
|---|---|---|---|---|
| Vanilla DQN | 116.1 | 50.4 | 83.3 ± 32.9 | seed2 峰值 89.5 后回落到 50 |
| Double-DQN | 78.0 | 113.6 | 95.8 ± 17.8 | 两种子总体上升(有阶段性回落),方差更小 |
图 2:DQN vs Double-DQN 平均回报(阴影为 2 个种子的 min–max 带)。约 19万–26万步区间,vanilla(红)明显压在约 50 的平台上(受 seed2 回落拖累),而 Double-DQN(蓝)更平顺地爬到约 100。
6.3 DQN vs Double-DQN:Q 值过估计
| 算法 | Q@150k(两种子均值) | 峰值 Q(均值) | 末端 Q(均值) |
|---|---|---|---|
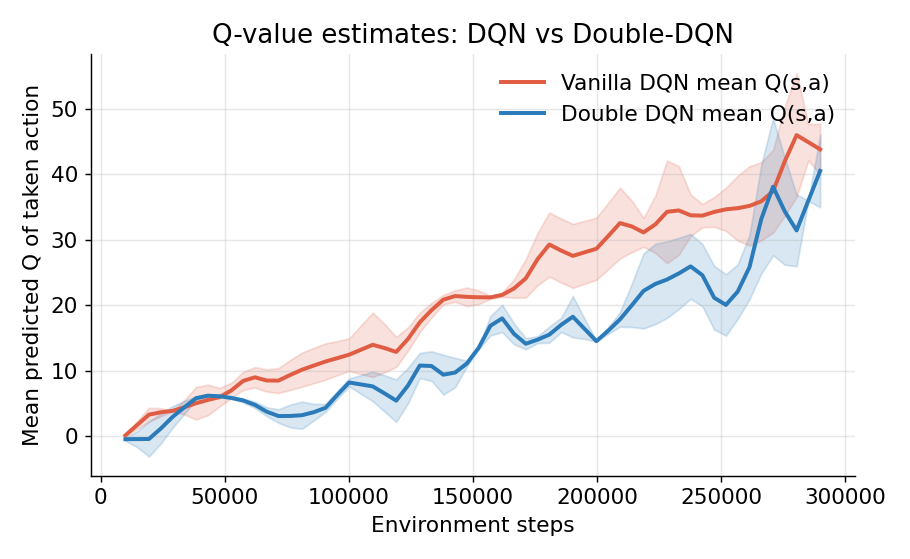
| Vanilla DQN | ≈21.2(22.9 / 19.5) | ≈52.0 | ≈43.8 |
| Double-DQN | ≈11.8(12.2 / 11.3) | ≈48.0 | ≈40.5 |
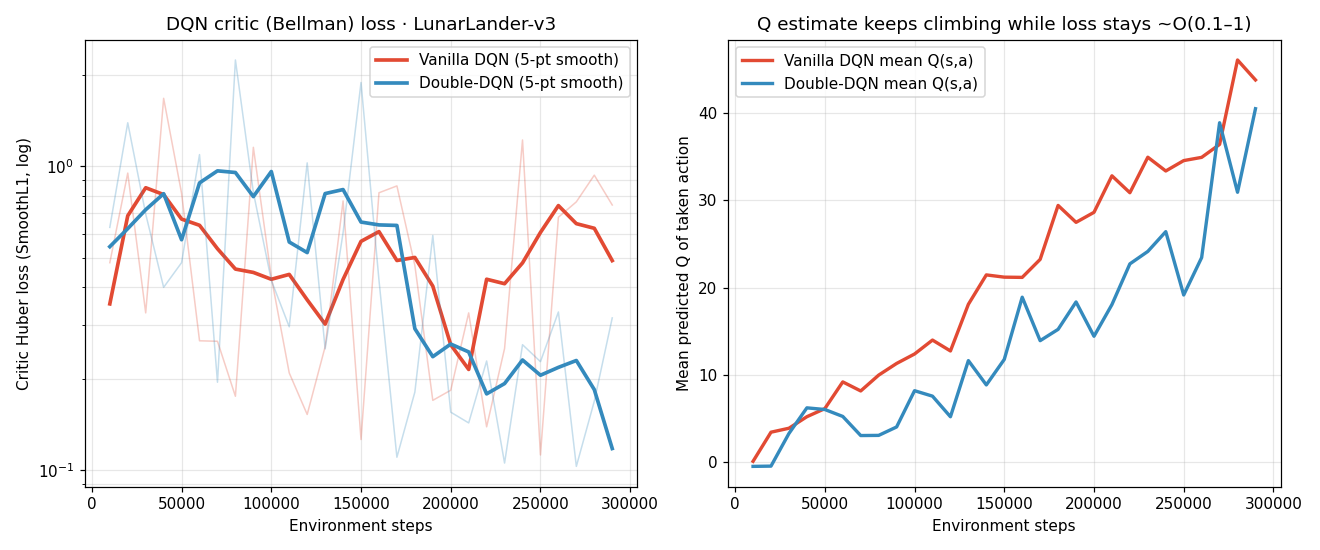
图 3:online 网络对”已执行动作”的平均 Q 估计。vanilla(红)在整个训练中段稳定高于 Double-DQN(蓝),150k 处约为其两倍(21 vs 12)——这是机制一致性的间接证据;由于没有 或独立校准值,不能把批均值 Q gap 当作绝对过估计的直接测量;末段两者收敛且噪声增大。
6.4 Actor-Critic:CartPole 的 ntu × ngsptu 消融
| 设置 (ntu, ngsptu) | 总梯度步/次 | 末轮 eval 回报 | 峰值 eval | 结论 |
|---|---|---|---|---|
| 1 × 1 | 1 | 29.5 | 78.8(第5轮瞬冲) | 失败:critic 根本没拟合好 |
| 100 × 1 | 100 | 189.7 | 189.7 | 成功(稳步逼近 200) |
| 1 × 100 | 100 | 200.0 | 200.0 | 成功 |
| 10 × 10 | 100 | 200.0 | 200.0 | 成功(本报告选作连续控制的默认设置) |
图 4:Actor-Critic on CartPole-v0(-n 100 -b 1000)。1×1(红)几乎贴底(末轮 29.5,仅第 5 轮瞬冲到约 79 又崩),其余三组只要”总更新量=100”都能到 200——印证 PDF:“1,1 训不动,需要增大 target 更新或梯度步。”
6.5 Actor-Critic:连续控制(MuJoCo -v4)
| 环境 | 设置 | 末轮 eval | 峰值 eval | 官方参考 | 达标 |
|---|---|---|---|---|---|
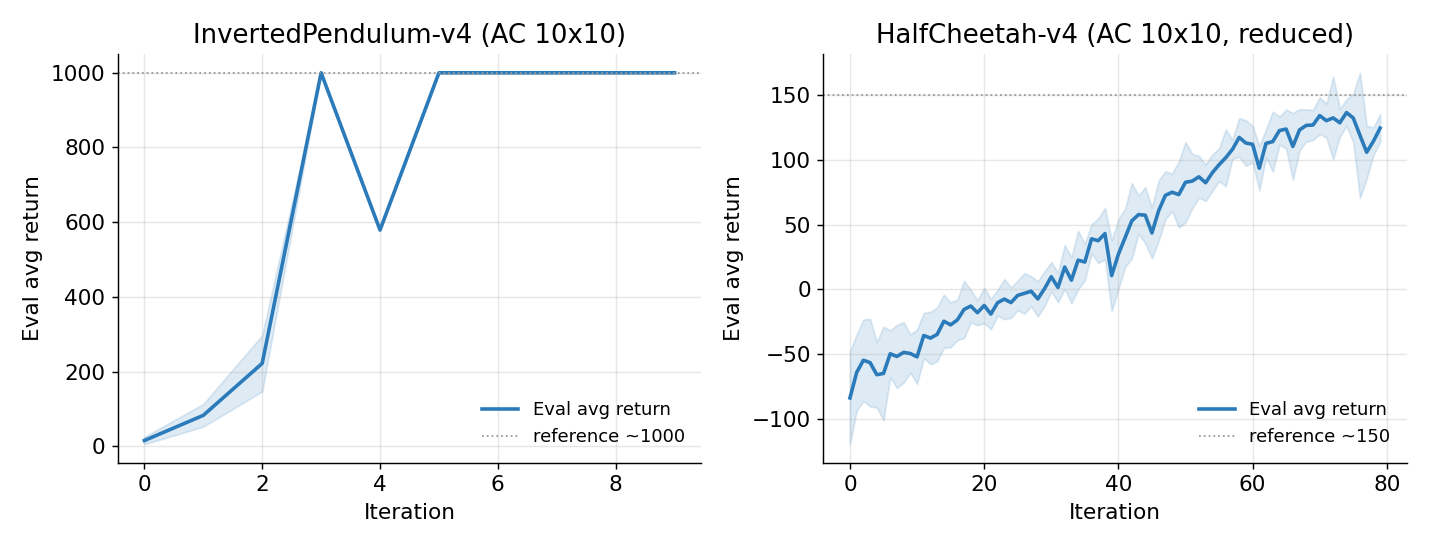
| InvertedPendulum-v4 | 10×10,100 轮 | 1000.0 | 1000.0 | ≈1000 | 达标(打满) |
| HalfCheetah-v4(降规模) | 10×10,80 轮,b=10000 | 124.5 | 136.5 | ≈150(150 轮/b=30000) | 趋势正确(缩规模下接近) |
图 5:连续控制。左:InvertedPendulum-v4 第 3 轮即达 1000(第 4 轮短暂回撤到约 580 后立刻回到 1000 并稳住);右:HalfCheetah-v4 从约 −85 总体上升到约 125(峰值 136,期间有阶段性回落),阴影为评测轨迹间 ±1 std。即使 batch 与迭代都砍到官方的 1/3–1/2,趋势与量级依然正确。
6.6 训练损失监控
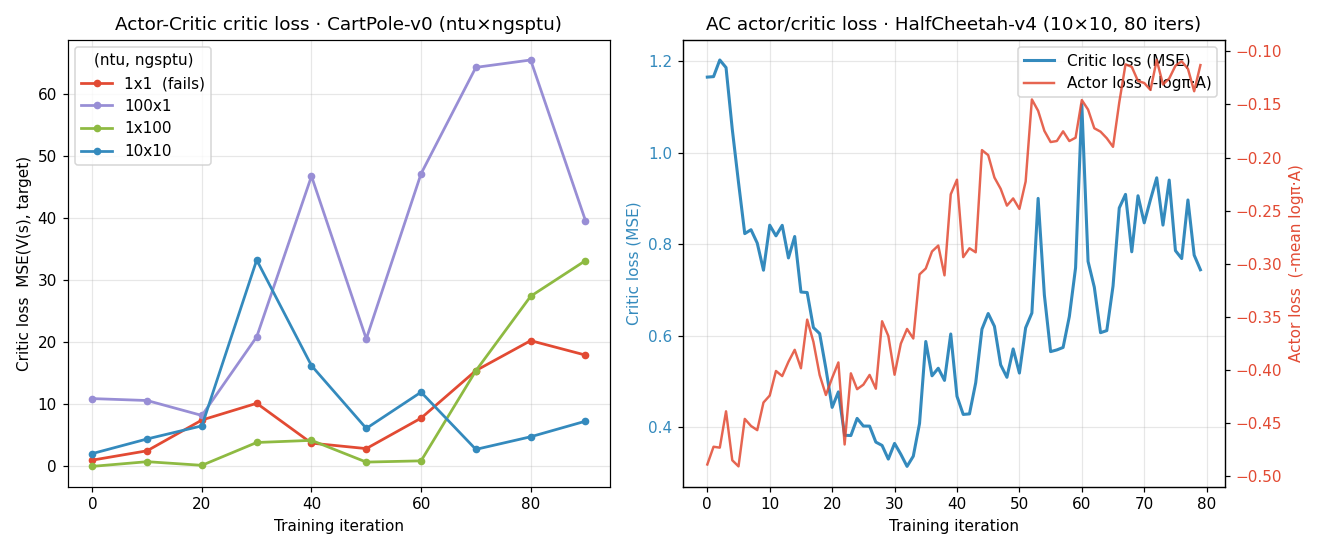
除回报/Q 曲线外,本节直接监控优化器实际最小化的损失。两侧记录的量并不对称:DQN 侧只有 critic 的 Bellman 回归损失(TensorBoard 标量 Training_Loss,即 )——DQN 的“actor”是对 Q 取 argmax 的确定性策略,没有独立的 actor 损失可记;Actor-Critic 侧则同时记录 critic 损失(Critic_Loss,)与 actor 损失(Actor_Loss,)。以下数字全部来自上述 data/*/ 的 tfevents,用 tbparse/event_accumulator 提取后绘制。
图 6:DQN 侧损失监控(LunarLander-v3,2 种子均值)。左:critic Huber 损失(细线为原始、粗线为 5 点滑动平均,对数纵轴)——两法都没有随训练下降,而是在约 0.1–1 之间持续抖动(vanilla 末端≈0.75、Double 末端≈0.32)。右:同一时间轴上平均 Q 却从 0 一路爬到约 40。“损失小而平”与“Q 不断上行”并存,正是 bootstrap 目标随 online 网络一起移动的特征:损失衡量的是“对当前移动靶的瞬时拟合”,并不等于价值已收敛。
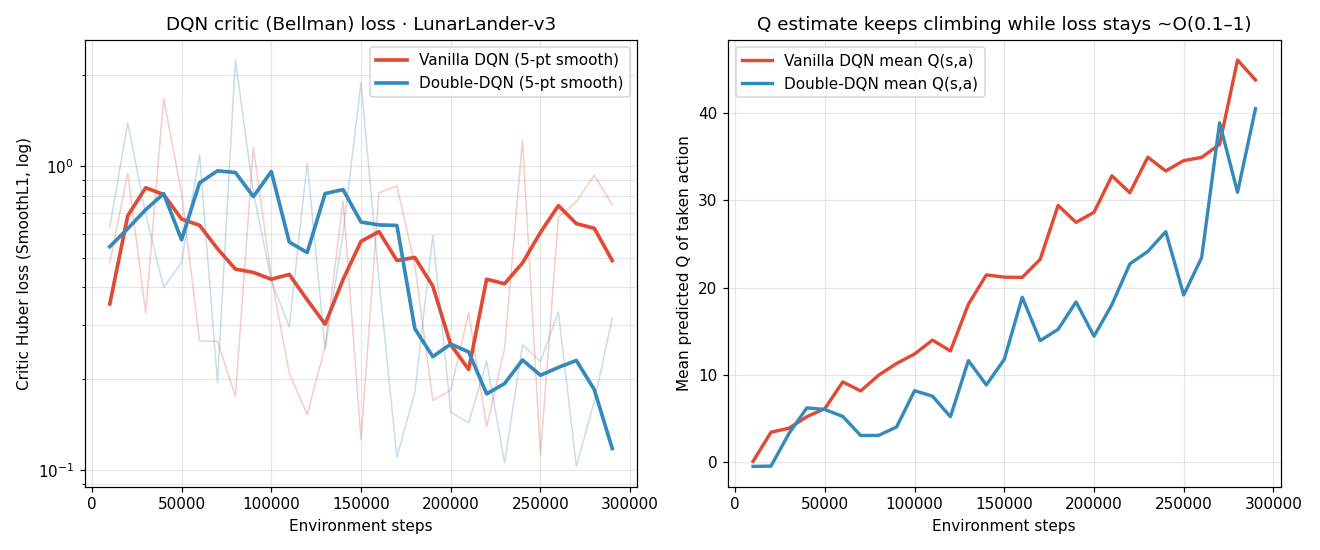
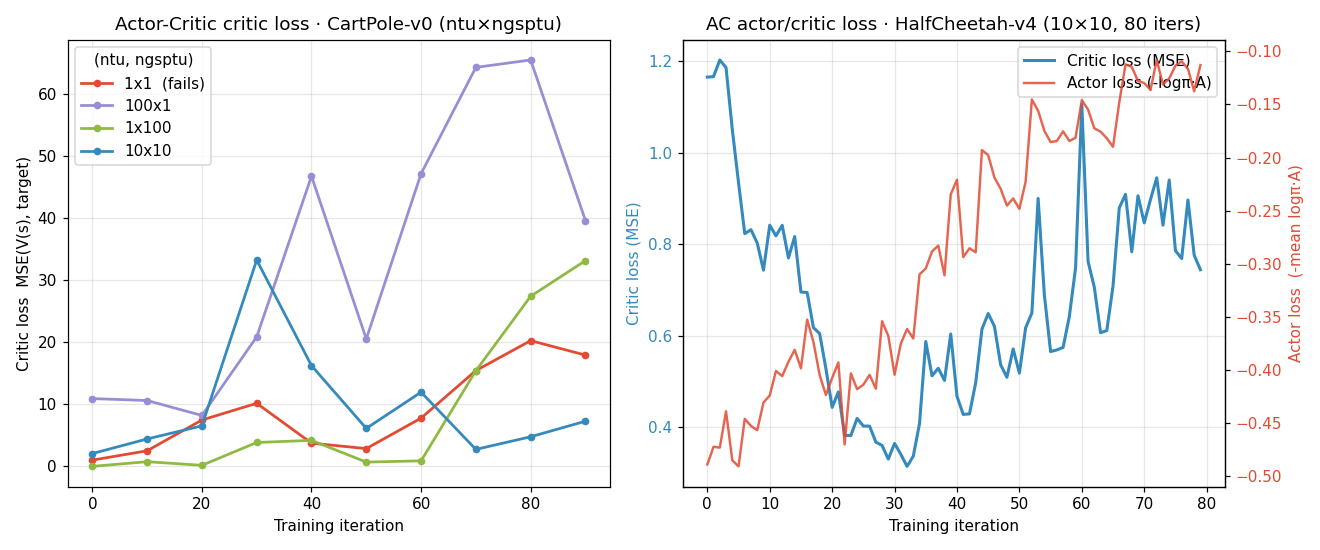
图 7:Actor-Critic 侧损失监控。左:CartPole 四组 ntu×ngsptu 消融的 critic 损失(MSE)——100×1(紫)因每步都换一张新 target 去追,损失最高(峰值≈65);10×10(蓝)折中,末端最低(≈7.3)。注意 1×1(红)损失看似不高(末端≈18),但这恰恰是“假的低”:每次只走 1 步、target 几乎没动,瞬时残差自然小,可 根本没拟合到真值(对应图 4 回报贴底)。右:HalfCheetah 的 critic 损失(蓝,随策略变强目标回报量级增大而缓升到约 1.2 后回落到 0.74)与 actor 损失(红,从约 −0.49 抬向 −0.11)。
读损失的三条结论
- Q/critic 损失 ≠ 回报: DQN 的 Bellman 损失全程在
O(0.1–1)抖动、并不单调下降,但回报与 Q 却在上行(图 6)。因为自举目标 是移动靶——损失只反映“追上当前靶”的程度,价值是否收敛要看 Q/回报曲线,不能只看 loss。- DQN vs Double-DQN 的 loss/Q 行为: 两者 critic 损失量级相当(Double 末端更低、≈0.32 vs 0.75),但差异主要体现在 Q 上而非 loss 上——图 6 右 vanilla 的 Q 全程更高(见 6.3 的过估计)。这说明 Double-DQN 的收益是“降低目标偏差”,并不会让回归损失显著变大或变小。
- AC 的 critic 拟合难度写在 loss 上: 连续控制里 critic 要回归的是真·标量回报(不像 CartPole 每步 +1 那样平凡),HalfCheetah 的 critic 损失量级与形态(先升后稳)直接反映“拟合一个随策略变化的价值函数”的难度;而 CartPole 消融更揭示了一个反直觉点——损失的绝对值不能单独判断 critic 好坏,必须结合
ntu×ngsptu(target 新鲜度 × 每靶拟合步数)一起看,这正是 6.4 / 现象 4 的损失侧佐证。
6.7 结果可视化(视频 · 真实 rollout)
为把”曲线上的回报”变成”看得见的行为”,本节给出各子实验最终/最好策略的真实 rollout 视频。因 HW3 的训练只落盘了 TensorBoard 标量、没有保存策略参数,这里复用 hw2 试点的同一套管线:按报告口径重训一段代表性 run,在评测回报刷新最好时 torch.save(state_dict) 存一个 best-eval checkpoint,再把最好 checkpoint 载回渲染(渲染脚本属于代码,不随本站发布)。全部 --no_gpu 纯 CPU、OMP_NUM_THREADS=1;MuJoCo 用 MUJOCO_GL=glfw 的 -v4 环境。视频均为真实 rollout 渲染,降规模处如实标注;checkpoint 选取过程与片段回报没有公开日志,本节只描述视频中可见的行为。
LunarLander 的渲染:自写 pygame renderer(Box2D)
定制版
LunarLander-v3只带一个老式_render,它依赖gym.envs.classic_control.rendering——该模块在本机 gym 0.25.2 已被移除(实测ImportError,env 只能返回 10×10 占位/”No display found”)。因此按任务提示”LunarLander 是 Box2D → 用 pygamergb_array”,我直接从 Box2D 刚体状态用 pygame 重画每一帧(着陆器/腿的多边形、着陆坪旗帜、地形与引擎粒子、底部计时条),再编码为 H.264。CartPole/InvertedPendulum/HalfCheetah 三者的render_mode='rgb_array'原生可用,直接采用。所有视频 H.264/yuv420p、宽 ≤480px、~25fps,均已解码校验。
图 0:视频 1:DQN(vanilla)on LunarLander-v3(Part 1;离散 6 动作、9 维观测;--no_gpu --num_timesteps 300000,降规模自官方 500k)。载入的是贪婪评测回报最好的 checkpoint,并从多个渲染种子中挑选了较好的一条:着陆器点火减速、放腿、落在两面黄旗之间的着陆坪。诚实说明:这是挑选出的较好片段,不代表平均性能——DQN 侧为 300k 步、纯 CPU 的显式降规模(见第 4 节),第 6 节曲线显示 vanilla DQN 的回报方差大、后段有回落。渲染器为自写 pygame(见上方说明)。
图 0:视频 2:Actor-Critic on CartPole-v0(Part 2;本报告选定的 ntu×ngsptu = 10×10,-n 100 -b 1000)。杆全程保持竖直、小车做微小左右修正,直到回合结束——与 6.4 表里 10×10 达到满分的曲线结论一致。
图 0:视频 3:Actor-Critic on InvertedPendulum-v4(Part 2,连续控制;10×10,--ep_len 1000 --discount 0.95 -b 5000 -lr 0.01,按官方规模)。倒立摆全程稳稳竖直、小车仅做微小水平修正,直到回合结束——与图 5 中 InvertedPendulum 达到满回报的曲线一致。
视频:inverted_pendulum_ac_rollout.mp4
图 0:视频 4:Actor-Critic on HalfCheetah-v4(Part 2,连续控制;10×10,--ep_len 150 --discount 0.90 -b 10000 -lr 0.02,降规模:batch 30000→10000、迭代 150→80)。“猎豹”已学会持续向前奔跑(伸腿蹬地、躯干前推,而非原地抽搐或翻倒),片段是从多个渲染种子中挑选的较好一条。诚实说明:因 batch/迭代砍到官方的 1/3–1/2,曲线上的绝对回报低于官方参考线 ≈150,但”向前跑”的定性步态已明确成形——对应 6.5 表中 HalfCheetah”趋势正确(缩规模下接近)“的结论。
四段视频与前文数字的对齐
四段视频只用于展示可见行为,回报数字以第 6 节的公开曲线为准:CartPole 与 InvertedPendulum 撑到回合结束、HalfCheetah 持续向前奔跑,与曲线结论方向一致;DQN-LunarLander 如第 4 节声明属显式降规模,视频是挑选出的一次成功着陆,不代表平均性能。四段均为真实 rollout,未做任何美化。
7. 现象分析
现象 1:max 算子的上偏倾向(与图 3 一致的机制)
DQN 的目标 里的 是”先用带噪估计选动作、再用同一份带噪估计给它打分”。由 Jensen 不等式,(非严格不等式)——当各动作的价值估计近似无偏、且噪声会影响动作选择时, 通常产生上偏;若噪声不改变选中的动作(例如各动作共享同一加性噪声),则未必出现严格上偏。图 3 里 vanilla 的批均值 Q 在训练中段更高,与该机制一致;但没有真值参照,不能由此单独确认偏差的绝对量。Double-DQN 用 online 选、target 评,把”选”与”评”的噪声解耦,从而压低这份偏差。
现象 2:较高批均值 Q 与回报波动同时出现(图 1、图 2 的联动)
这里只能说两类现象同时出现:vanilla 的批均值 Q 在训练中段更高(图 3),回报也出现”登顶后回落”——图 1 里 seed1 在 17万步登顶 65 后回落到 10;图 2 里 vanilla 因 seed2 的回落被拖出一个约 50 的平台。Double-DQN 两种子总体上升、种子间 std 更小(17.8 vs 32.9),方向上与 README 那句”没有 double-Q 时均值到 150 后常回落”一致。“偏高的 target 会把 bootstrap 误差沿时间放大”是与这些现象一致的机制解释;本实验既没有测量绝对过估计,也没有隔离其他不稳定来源,不能据此断定过估计导致了回落。
现象 3:末端 Q 收敛、噪声增大——诚实说明
图 3 末段两条线几乎缠在一起(甚至个别点 Double-DQN 略高)。原因有二:(1) 我记录的是整批(含 replay 里旧策略状态) 的平均 Q,不是”最优动作 Q”,本就比 eval 回报更”钝”;(2) 30 万步、单/双种子下末端本就抖动大。过估计最干净的证据在训练中段的持续 gap,而非末点——这也是我用图 2/图 1 的”稳定性”作为过估计后果的佐证,而不是只盯末端 Q 数字。
现象 4:本次
1×1Actor-Critic 运行表现较差(图 4)AC 是”critic 估 → 优势 → 推 actor”的串联。
ntu=1,ngsptu=1意味着每次 agent 更新,critic 只做 1 步梯度;本次曲线中该设置回报较低,而总更新量为 100 的三组设置明显更高。这与 critic 更新不足会削弱优势信号的解释一致,但该消融没有直接测量价值估计误差,也不能排除更新配比等因素。
现象 5:target-update 与 grad-step 的权衡(10×10 为何常被选中)
1×100:只算一次 target 就猛跑 100 步,可能过拟合到一组”已经过时”的 target;100×1:target 重算很勤但每次只走一步,收敛慢。10×10在”target 新鲜度”与”每组 target 的拟合充分度”间折中,图 4 里它与1×100一样早早到 200 且更平稳,故被选作连续控制默认。三者最终都能解 CartPole,说明关键是”总更新量”足够,其次才是二者的配比。
8. 理论 ↔ 实践对接
8.1 回扣模块 05:致命三要素与过估计
模块 05 指出 致命三要素(deadly triad):函数逼近 + 自举(bootstrapping)+ 离策略(off-policy)三者同时出现时,价值迭代可能发散。DQN 恰好三者齐备(神经网 + Bellman 自举 + replay 的离策略采样),所以才需要一整套稳定化补丁:
| 模块 05 概念 | 本作业中的对应实现 | 实测证据 |
|---|---|---|
| target 网络(缓解自举的移动靶) | q_net_target + 每 3000 步硬更新 | 本作业默认保留;未做“移除 target”消融,稳定作用来自算法机制而非本次因果对照 |
| max 过估计风险 | q_tp1 = max_a Q_target | 图 3 中 vanilla 的批均值 Q 在训练中段更高;因无 真值,只能作间接证据 |
| Double-DQN(缓解选择偏差) | online 选 argmax、target 评值 | 图 3 蓝线更低、图 2 方差更小;支持“减弱高估”的解释,但不单独证明绝对无偏 |
| 经验回放(打破相关性/复用样本) | MemoryOptimizedReplayBuffer | 能在 30 万步内学出正回报 |
| Huber loss + 梯度裁剪 | SmoothL1Loss + clip_grad_value_(·,10) | 抑制离群 TD 误差的爆炸梯度 |
8.2 回扣模块 04:优势、bootstrap 与偏差-方差
模块 04 的主线是用 critic 把 REINFORCE 的高方差回报换成低方差的 一步 TD 优势:
这是一次偏差换方差:在完整 on-policy episode、终止处理正确时,Monte-Carlo 回报是对应策略价值的无偏样本但方差大;一步 bootstrap 通常方差较小,却把 critic 近似误差带入目标。因此 critic 拟合得越准,优势通常越可信。1×1 表现差与“critic 更新不足”一致,但仅凭该消融不能把全部差距唯一归因于 critic 偏差。
推导:为什么终止步要把 bootstrap 截断为 0
关键点
episode 在 终止意味着 之后没有后续回报可拿。
估的是”从 起的期望回报”,但终止后这段回报恒为 0。若不乘 ,就会把一段不存在的未来回报错误地灌进 target,系统性抬高终止前的价值估计。故 target 与优势都写成 。DQN 的 Bellman 目标同理。
9. 反思
为什么这样:Double-DQN 只改”选动作用哪张网”,值得吗?
能不能不这样? 能——vanilla DQN 也能学出正回报(图 2 红线末端 83)。本设置中 Double-DQN 只多一次
argmax,并伴随更低的批均值 Q 与更小波动;但样本仅 2 个种子,不能据此宣称普遍降低方差或“免费午餐”。它的主要价值是以很小计算开销解耦动作选择与评估,从机制上缓解 max 选择偏差。
为什么这样:AC 为何不把
ngsptu直接开到很大?能不能一次 target 就狂跑 1000 步? 图 4 的
1×100已经暗示了风险:target 是用旧 critic 算的,跑太多步会把 过拟合到一组过时目标上,反而可能震荡。真正稳的是”及时重算 target、每次适度拟合”的交替(10×10)。这与 DQN 的 target 网络是同一个哲学:bootstrap 必须给目标留出”慢变”的稳定性。
为什么这样:LunarLander 用 ,会不会有问题?
LunarLander 是有限步 episode(着陆/坠毁即止),无折扣是合理的。但 让 Q 值本身量级偏大(≈几十),也让过估计的绝对数值更醒目(图 3 的 Q 到 40–50)。若换成 ,Q 量级会小很多、过估计的绝对 gap 也会缩小,但相对结论不变。这提醒:“Q 数值的绝对大小”依赖 ,跨设置比较要看趋势而非绝对值。
数据诚实性 / 本次实验的局限
- 降规模: DQN 500k→300k、种子 3→2;HalfCheetah batch 30000→10000、迭代 150→80。故 DQN 未跑到”稳定 150”、HalfCheetah 未到 150,均为预算所致的缩规模,本文只声称”趋势正确”。
- 过估计末端不明显: 如现象 3 所述,记录的是整批平均 Q,末端两法收敛;干净证据在训练中段的持续 gap 与稳定性差异,而非末点绝对值。
- 环境版本替换: 用
-v4代-v2(本机无mujoco_py);用 LunarLander 代 Atari(CPU 无法承受卷积 DQN 的百万步)。属兼容/降级,非算法改动。- InvertedPendulum 第 4 轮回撤到约 580: 单种子偶发,随即回到 1000;未做多种子平均,个别轮次含运气成分。
- 强制 CPU: 为规避 MPS 缺算子,全程
--no_gpu;与官方 GPU 结果在数值上不完全可比,但算法语义一致。
High-level insight
HW3 把两个看似无关的部分缝成了同一课:bootstrap 是把双刃剑。它让我们不必等到 episode 结束就能学习(DQN 的 Bellman、AC 的一步优势都是 bootstrap),代价是”用估计更新估计”会放大误差——在价值侧表现为 max 过估计与致命三要素的不稳定,在 Actor-Critic 侧表现为 critic 偏差污染优势。两部分给出的解药也同构:给目标一点”慢变的稳定性”(DQN 的 target 网络、AC 的多步拟合再重算 target),并把偏差显式压下去(Double-DQN 去过估计、AC 用足够梯度步降 critic 偏差)。理解了”如何驯服 bootstrap”,就理解了从 DQN 到 SAC、再到今天 RLHF 里 value/advantage 设计的一整条主线。
Claim–Evidence 对照
| 结论 | 状态 | 证据 | 升级条件 |
|---|---|---|---|
| 在本次两种子运行中,Double-DQN 的末轮平均回报高于 vanilla DQN,且种子间离散度更小。 | 已验证 | 图片 ↗ | — |
| 本次运行中,vanilla DQN 在训练中段的批均值 Q 高于 Double-DQN;该差异仅作为与过估计机制一致的间接证据。 | 已验证 | 图片 ↗ | — |
| CartPole 消融中,1×1 更新设置表现较差,而三组总更新量为 100 的设置达到或接近满分。 | 已验证 | 图片 ↗ | — |
| 本次连续控制运行中,InvertedPendulum 达到满回报,降规模 HalfCheetah 的评测回报随训练上升。 | 已验证 | 图片 ↗视频 ↗视频 ↗ | — |
| 本次运行中,DQN 的 Bellman 损失没有随回报上升而单调下降,因此训练损失不能单独替代策略回报判断。 | 已验证 | 图片 ↗图片 ↗图片 ↗ | — |
证据文件
11 个文件