CS285 HW4 实验报告:学习动态模型 + MPC/CEM 规划
本报告迁移自原课程材料,经 AI 事实核查未发现存疑项,未逐页人工审核;结论与证据请以页面列出的原始文件为准。
实验目标
HW4 的主线是基于模型的强化学习,它把 RL 拆成两件事:(1) 学一个动态模型 $f_\theta$ 去拟合真实转移;(2) 用模型做规划选出让已知奖励最大的动作。整份作业按难度分成 6 个问题:
实验设置
| 环境 | 本作业用到 cs285 定制的三个连续控制环境(注册见 cs285/envs/__init__.py)。下面逐一给出状态空间、动作空间、奖励、有效视野(ep_len)与目标,所有维度均已通过实例化环境读取 observation_space/action_space 并对照各环境源码核验(cheetah.py/obstacles_env.py/reacher_env.py),非人为估计。 |
|---|---|
| 随机种子 | 1 |
| 关键配置 | 无 |
本报告迁移自 CS285 课程材料 [1]。
本报告是 模块 08(基于模型的强化学习) 的动手配套。我们在 MuJoCo 的 cheetah / reacher / obstacles 三个环境上实现 Model-Based RL:先拟合预测状态增量的动态模型,再用随机打靶或 CEM 做 MPC,并通过 on-policy 数据聚合迭代。本站公开证据包括训练曲线、损失图和 rollout 视频;Q3–Q6 做了显式降规模。Q6 比较的三个设置同时改变了 rollout 长度和部分 SAC 更新预算,因此只按联合设置解读。
本报告要回答的问题
- 动态模型的预测误差(MPE)如何随网络容量与训练步数变化?(Q1)
- 只训练在随机数据上的模型,配合 MPC 能否显著超过随机策略?(Q2)
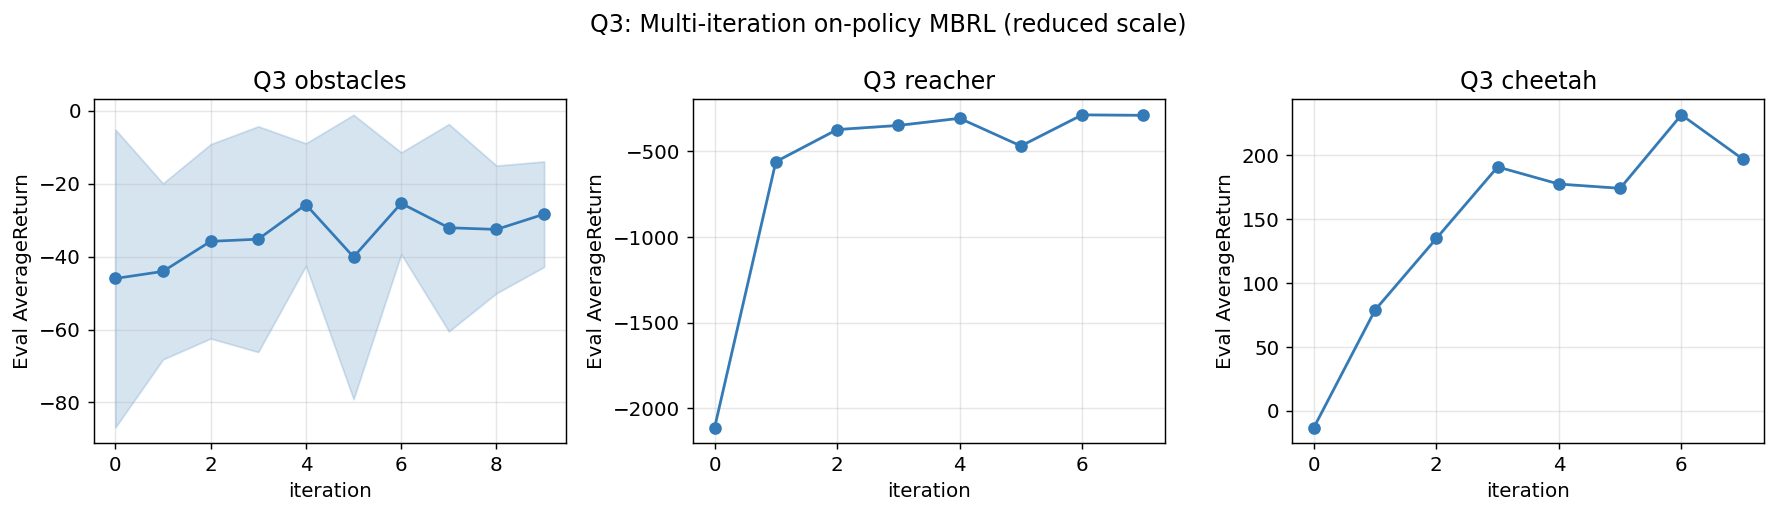
- on-policy 数据聚合是否能逐轮提升回报(obstacles/reacher/cheetah)?(Q3)
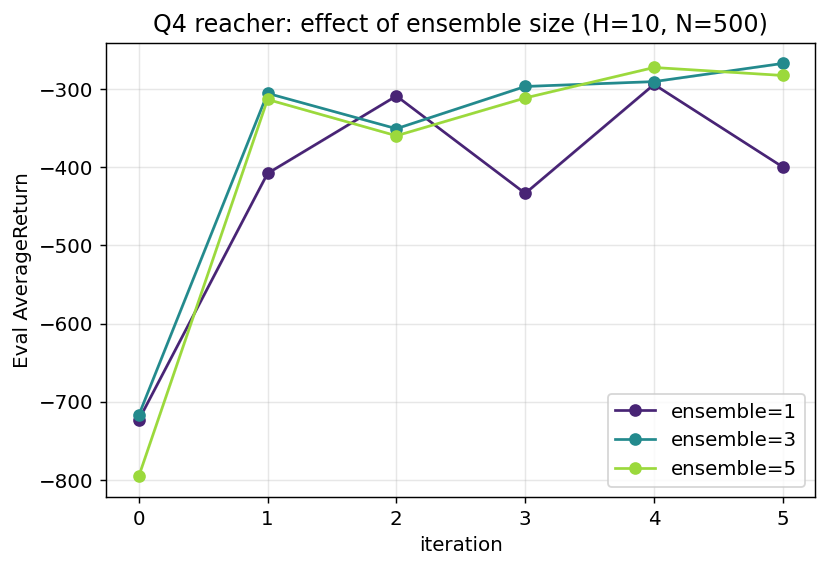
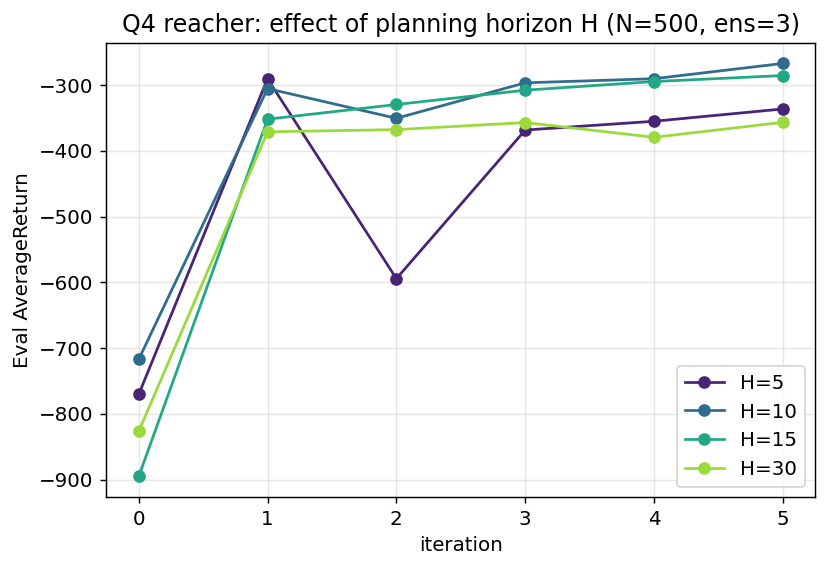
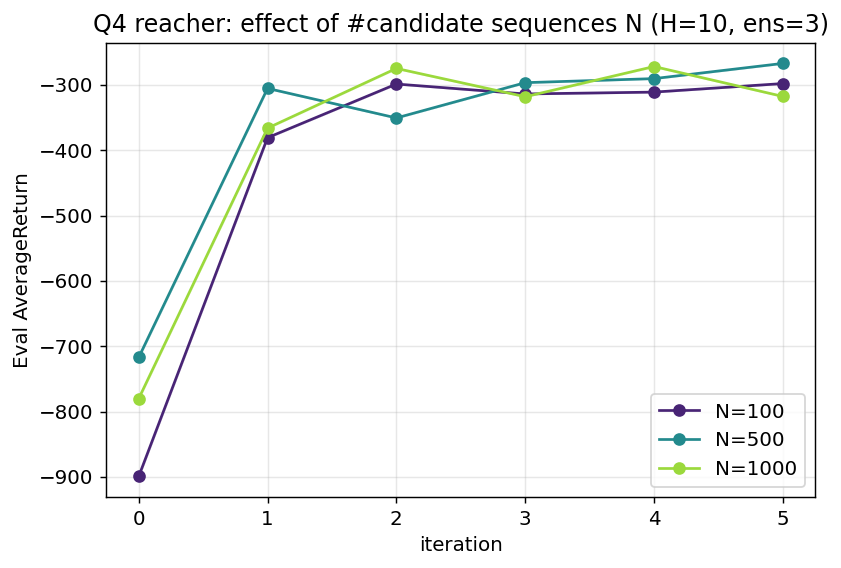
- 三个规划超参——ensemble 大小、候选动作序列数 、规划视野 ——各自怎样影响性能?(Q4)
- CEM 是否优于随机打靶,迭代次数 2 vs 4 的差别?(Q5)
- 这些实测现象如何回扣模块 08 的理论:模型误差沿视野复合、ensemble 降低认知不确定性、MPC 重规划、规划预算权衡。
一句话结论
本次运行观察到:Q1 三个配置的 MPE 为 1.26 / 0.21 / 0.028;Q2 中模型 + MPC 的 Eval 为 −46、随机采集回报为 −167;Q3 曲线总体上升;Q4/Q5 的已测配置存在性能排序;Q6 的三组末轮回报为 38/162/634。上述结果与模块 08 的机制预期相容,但多数为单种子、降规模比较。尤其 Q6 按作业命令运行,各设置的 SAC 更新预算并不相同(该配置未随本站公开,无法在本页核对),不能把差异识别为 rollout 长度的单一因果效应。
证据口径 / 复现契约
- 环境: Python 3.9.23;torch 1.13.1;gym 0.25.2;MuJoCo 2.3.3;NumPy 1.x;CPU。
- 重复与误差条: 训练 seed=1,单种子;std 来自同一策略少量评测轨迹,部分设置仅 1 条、因此 std=0。
- 预算: Q3–Q6 均显式降规模;逐项官方/本次预算见 §4 与对应小节。
- checkpoint / 视频: 正文 run 未保存模型;视频来自独立短训后保存的模型与统计量,并从多个渲染 seed 取最好轨迹。它验证可执行行为,不估计成功率。
- **公开证据:**训练曲线、损失图和三段 rollout 视频均在本页
evidence/目录;原始日志、代码和 checkpoint 不随本站发布。【单种子趋势】【有限配置消融】【存在预算混杂】 Q6 各设置的
sac_n_iter更新预算按作业命令并不相同(配置未公开),不能识别 rollout 长度的独立因果效应。
1. 作业目标与要求
HW4 的主线是基于模型的强化学习,它把 RL 拆成两件事:(1) 学一个动态模型 去拟合真实转移;(2) 用模型做规划选出让已知奖励最大的动作。整份作业按难度分成 6 个问题:
| 问题 | 要实现 / 验证的东西 | 本报告是否覆盖 |
|---|---|---|
| Q1 | 训练动态模型、对比不同架构/训练量下的预测误差 MPE | ✅ 3 个配置 |
| Q2 | 用学到的模型 + MPC(随机打靶)做单轮动作选择 | ✅ obstacles |
| Q3 | on-policy 数据聚合的多轮 MBRL | ✅ obstacles/reacher/cheetah(降规模) |
| Q4 | 消融:ensemble 大小 / 候选序列数 / 规划视野 | ✅ reacher 8 组(降规模) |
| Q5 | 随机打靶 vs CEM(迭代 2/4) | ✅ cheetah 3 组(降规模) |
| Q6 | MBPO(用模型给 SAC 造数据) | ✅ cheetah rollout 0/1/10(降规模) |
需要自己补全的关键代码点(skeleton 中标为 TODO):动态模型的前向 + 标准化 + 训练步(ff_model.py)、集成的分片训练与统计量更新(mb_agent.py)、MPC 的候选采样 / 逐条打分 / CEM 迭代 / 只执行首步(MPC_policy.py)、以及 MBPO 的模型内 rollout(mbpo_agent.py)。三个评测环境(obstacles / reacher / cheetah)的状态/动作/奖励/视野与任务目标详见下一节 §2 环境与任务介绍。
2. 环境与任务介绍
本作业用到 cs285 定制的三个连续控制环境(注册见 cs285/envs/__init__.py)。下面逐一给出状态空间、动作空间、奖励、有效视野(ep_len)与目标,所有维度均已通过实例化环境读取 observation_space/action_space 并对照各环境源码核验(cheetah.py/obstacles_env.py/reacher_env.py),非人为估计。
先说最关键的一点:奖励函数是”已知且可查”的
Model-Based RL 在本作业里只学动态模型(转移 );奖励通过
env.get_reward(s,a)解析计算,不需要再学一个奖励模型。三个环境的get_reward都支持 batch 输入——这正是 MPC 能在”想象”里对 条候选动作序列批量算总回报的前提。下表”奖励”列即逐字来自各环境的get_reward源码。
2.1 obstacles-cs285-v0(纯 numpy 2D 导航)
| 项 | 内容(源码核验) |
|---|---|
| 状态空间 | :——当前位置 + 目标位置(_get_obs 里 concatenate([self.current, self.end]))。坐标范围约 。 |
| 动作空间 | 连续 (),action_space 为 。执行时 step 先 clip(a,-1,1) 再 ,故单步实际位移每轴 。 |
| 奖励(已知) | (get_reward 中 -dist)。无显式撞墙惩罚项:障碍/边界通过”非法移动被阻挡(原地不动)+ 出界或到达即 done=1”来体现,不进入奖励。 |
视野 ep_len | 100(run_hw4_mb.py 对本环境硬编码;注册的 max_episode_steps=500 被其覆盖)。 |
| 目标 | 在带 5 个矩形障碍与边界的平面里,把智能体从随机起点导航到目标点( 视为到达)。 |
2.2 reacher-cs285-v0(7-DOF Sawyer 机械臂,MuJoCo)
| 项 | 内容(源码核验) |
|---|---|
| 状态空间 | :关节位置 qpos[7] + 缩放关节速度 qvel[7]/10 + 末端(finger)3D 位置 site_xpos[3] + 目标 3D 位置 site_pos[3](_get_obs)。 |
| 动作空间 | 连续 (7 个关节的力矩/控制量),范围 (实例化读得 action_space.low=-1, high=1)。 |
| 奖励(已知) | (get_reward 中 -10*dist)。无控制代价项;done 恒为 False(定长回合)。 |
视野 ep_len | 200(硬编码;注册 max_episode_steps=500)。 |
| 目标 | 驱动 7-DOF 机械臂,让末端 finger 尽快贴近每回合随机采样的 3D 目标点()。 |
2.3 cheetah-cs285-v0(HalfCheetah,MuJoCo)
| 项 | 内容(源码核验) |
|---|---|
| 状态空间 | :关节位置 qpos[9] + 关节速度 qvel[9] + 躯干质心 com_torso[3](_get_obs)。其中 obs[2]=躯干角、obs[6..8]=前腿/胫/足角、obs[9]=前向速度 (被奖励函数使用)。 |
| 动作空间 | 连续 (6 个关节力矩),范围 (实例化读得)。 |
| 奖励(已知) | :前向速度奖励 run=xvel;若前腿角 /前胫角 /前足角 则各扣 penalty_factor=10(get_reward)。无二次控制代价项。 |
视野 ep_len | 500(硬编码;注册 max_episode_steps=1000)。 |
| 目标 | 让”半只猎豹”在保持前腿姿态合规的前提下尽可能快地向前跑(最大化累计前向速度)。 |
为什么这三个环境是好的 MBRL 试金石?
三者在维度、动力学复杂度、奖励形状上层层递进:obstacles 是 4 维纯 numpy 导航(连 MuJoCo 都不需要,最易学模型);reacher 是 20 维接触较弱的机械臂到点(奖励光滑、稠密);cheetah 是 21 维、含接触与失稳的高动态运动(奖励含不连续的姿态阈值惩罚,对模型误差最敏感)。这正好覆盖了”模型好学 → 难学”、“规划易 → 难”的谱系,让 Q1–Q5 的结论更有说服力。
2.4 任务清单(要回答/验证什么)
作业按难度分成 6 问,全部建立在”学动态模型 + 用已知奖励做采样式规划”之上:
| 问题 | 环境 | 要验证的核心问题 |
|---|---|---|
| Q1 动态模型质量 | cheetah | 不同网络容量 × 训练步数下,动态模型的预测误差 MPE 如何变化?(评估指标,见 §6) |
| Q2 单轮 MPC | obstacles | 只在随机数据上训一个模型,配合 MPC(随机打靶)能否显著超过随机策略? |
| Q3 多轮 MBRL | 三个 | on-policy 数据聚合能否让回报逐轮上升? |
| Q4 消融 | reacher | 三个规划超参——ensemble 大小 / 候选序列数 / 规划视野 ——各自如何影响性能? |
| Q5 规划器对比 | cheetah | 随机打靶 vs CEM(迭代 2 / 4)谁更强? |
| Q6 MBPO | cheetah | 用模型造短 rollout 喂给 SAC:模型内 rollout 长度 0 / 1 / 10 谁的样本效率更高?(见 §11) |
3. 环境搭建与踩坑
依赖复用已有的 conda 环境 cs285(Python 3.9),核心版本来自本机真实解释器:
| 包 | 版本 | 作用 |
|---|---|---|
python | 3.9.23 | 解释器(miniconda3/envs/cs285) |
torch | 1.13.1 | 动态模型网络与优化 |
gym | 0.25.2 | 环境接口(旧 step API,4 元组) |
mujoco | 2.3.3 | 物理后端(新 mujoco 绑定,非 mujoco_py) |
numpy | 1.x | MPC 全程在 numpy 域做批量前推 |
踩坑 1(最关键):共享包名
cs285的”影子包”遮蔽多个作业使用同一个顶层包名;运行前需要确认解释器解析到当前作业目录。本站不发布环境安装日志,因此这里只保留问题与检查原则,不把安装输出作为公开证据。
踩坑 2:用新
mujoco绑定,不装mujoco_pycheetah/reacher 用
gym.envs.mujoco.mujoco_env(gym 0.25 已适配新mujocoPython 绑定)。直接import mujoco_py会ModuleNotFoundError——这是预期的,不需要它。三个环境实测均可加载:obstacles(obs 4)、reacher(obs 20)、cheetah(obs 21)。obstacles 是纯 numpy 环境,连 mujoco 都不需要。
踩坑 3:纯 CPU + 降规模
本次统一使用 CPU。为控制运行预算,Q3/Q4/Q5 缩减了
n_iter、num_agent_train_steps_per_iter、候选数 、batch_size与eval_batch_size;因此这里只比较本站公开曲线中的本次设置,不声称复现外部参考成绩。
仅加的一处非算法改动(实验记录用)
为把动态模型的 MPE 数值落盘(原代码只把它画进
itr_0_predictions.png的标题、不打印),在rl_trainer.log_model_predictions里加了一行print(MPE)与np.save(itr_0_mpe.npy)。不改变任何训练/规划逻辑,纯粹为了让报告能引用真实 MPE。
4. 实验 setting(真实超参)
下表为各问题本次实际使用的超参(来自 run_hw4_mb.py 的 argparse 默认 + 我们的运行命令)。降规模的项用 红色标出原官方值。
| 超参 | 含义 | Q1 | Q2 | Q3 | Q4 | Q5 |
|---|---|---|---|---|---|---|
env | 环境 | cheetah | obstacles | 三个 | reacher | cheetah |
n_iter | on-policy 迭代轮数 | 1 | 1 | obs 10 / rea 8 / che 8 (原12/15/20) | 6 (原15) | 4 (原5) |
num_agent_train_steps_per_iter | 每轮模型梯度步 | 500 或 5 | 20 | obs 20 / rea 500 / che 500 (原—/1000/1500) | 400 (原1000) | 500 (原1500) |
ensemble_size | 集成模型数 | 1 | 1 | 1 | {1,3,5} | 1 |
mpc_horizon | 规划视野 | — | 10 | obs/rea 10 / che 15 | {5,10,15,30} | 15 |
mpc_num_action_sequences | 候选动作序列数 | — | 1000 | obs 1000 / rea·che 500 (原1000) | {100,500,1000} | 500 (原1000) |
mpc_action_sampling_strategy | 规划方法 | random | random | random | random | random / cem |
cem_iterations | CEM 迭代次数 | — | — | — | — | {2,4} |
cem_num_elites | CEM 精英数 | — | — | — | — | 5(默认) |
batch_size_initial | 首轮随机数据量 | 20000 | 5000 | obs 5000 / rea·che 3000 | —(首轮用 batch_size) | 3000 (原5000) |
batch_size | 每轮 on-policy 采集 | — | 1000 | obs 1000 / rea·che 1500 (原5000) | 800 | 1500 (原5000) |
eval_batch_size | 每轮评测采集 | — | 400 | obs 400 / rea·che 200 (原400) | 200 (原400) | 200 (原400) |
n_layers×size | 网络结构 | 1×32 / 2×250 | 2×250(默认) | |||
learning_rate | Adam 学习率 | (默认) | ||||
add_sl_noise / seed | 训练加噪 / 随机种子 | 开启 / 1(单种子单次) |
5. 代码实现讲解
5.1 动态模型:预测”标准化的状态增量”
模型不直接预测 ,而是预测状态差 ,并且是它的标准化版本。原因有二:预测增量比预测绝对状态更容易(增量幅度小、跨状态更平稳);标准化让各维度梯度尺度均匀。前向里先把输入 obs/action 标准化,网络输出 ,再反标准化加回 得到 (对应 PDF 公式 6):
(此处的实现代码或复现命令不在本站发布。)
训练目标也放在标准化空间:把真实增量标准化后与网络输出算 MSE(PDF 公式 5)。
(此处的实现代码或复现命令不在本站发布。)
为什么把 loss 放标准化空间,而不是直接对 算?
cheetah 的 21 维状态里,有的维度(位置)量级大、有的(速度/角度)量级小。若直接对原始状态算 MSE,大量级维度会主导梯度,小量级维度学不动。把目标标准化到 ~ 后,每个维度对 loss 的贡献均衡,网络能同时学好所有维度。统计量
obs/acs/delta_mean/std由mb_agent.add_to_replay_buffer用整个 replay buffer 实时估计。
5.2 集成(ensemble):分片训练 + 预测平均
集成的价值在于用”模型间的分歧”刻画认知不确定性。实现上两点:(1) 采样时一次取 batch_size × ensemble_size 条数据,训练时等分切片给每个模型,让它们看到不重叠的 minibatch(bootstrap 式多样性);(2) 规划打分时对所有模型的预测回报取平均。
(此处的实现代码或复现命令不在本站发布。)
(此处的实现代码或复现命令不在本站发布。)
5.3 随机打靶:向量化的 H 步前推
随机打靶就是:均匀采 条长度 的动作序列,用模型把每条序列在”想象里”推演 步、累加已知奖励,选总回报最高的那条。效率关键:不要写 的双层 python 循环,而是把 条候选当成一个 batch,只做一层 的循环——每步同时推进全部 条:
(此处的实现代码或复现命令不在本站发布。)
为什么这样能快 100×?
朴素写法对每条候选、每一步各调一次模型,共 次前向,每次 batch=1;向量化后只有 次前向,每次 batch=。神经网络对 batch 是高度并行的, 次 batch=1000 的前向远快于 次 batch=1 的前向。这也是本报告能在纯 CPU 上把消融跑完的前提。
5.4 MPC:只执行第一步,然后重规划
规划出最优 步序列后,只执行第一个动作,下一时刻拿到真实新状态再重新规划(receding horizon control)。这是抵消模型误差累积的核心技巧:
(此处的实现代码或复现命令不在本站发布。)
5.5 CEM:迭代收紧采样分布
随机打靶只采一次;CEM 则迭代 次:每轮选 top- 精英序列,用它们的均值/方差拟合一个对角高斯,作为下一轮的采样分布——把搜索预算逐步集中到”看起来好”的区域。可选的动量系数 让分布更新更平滑,避免过早收敛:
(此处的实现代码或复现命令不在本站发布。)
5.6 on-policy 数据聚合(主循环)
rl_trainer 已把逻辑串好:首轮用随机策略收 batch_size_initial 条数据,之后每轮用当前最新模型驱动的 MPC去环境采新数据、并入 replay buffer、在增长的 buffer 上再训练模型。因为 MBRL 在实践中对 on-policy 数据高度依赖(随机数据覆盖不到我们真正关心的状态区域),这个聚合循环是性能逐轮提升的关键。
6. Q1:动态模型质量(架构 × 训练量)
【受控配置对比】【单种子】 网络容量与训练步数同时变化的配置不应拆成单因素因果效应。
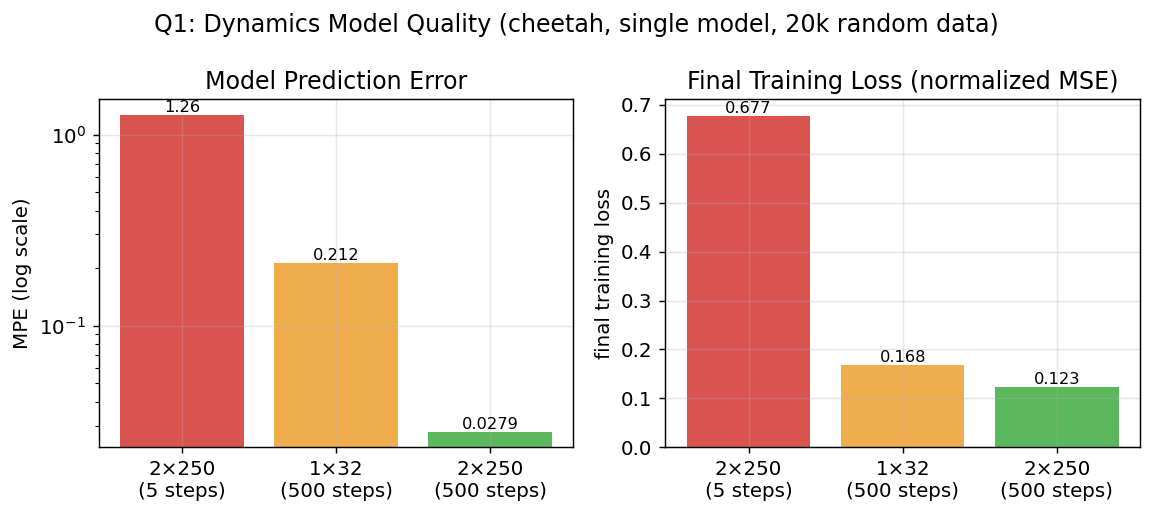
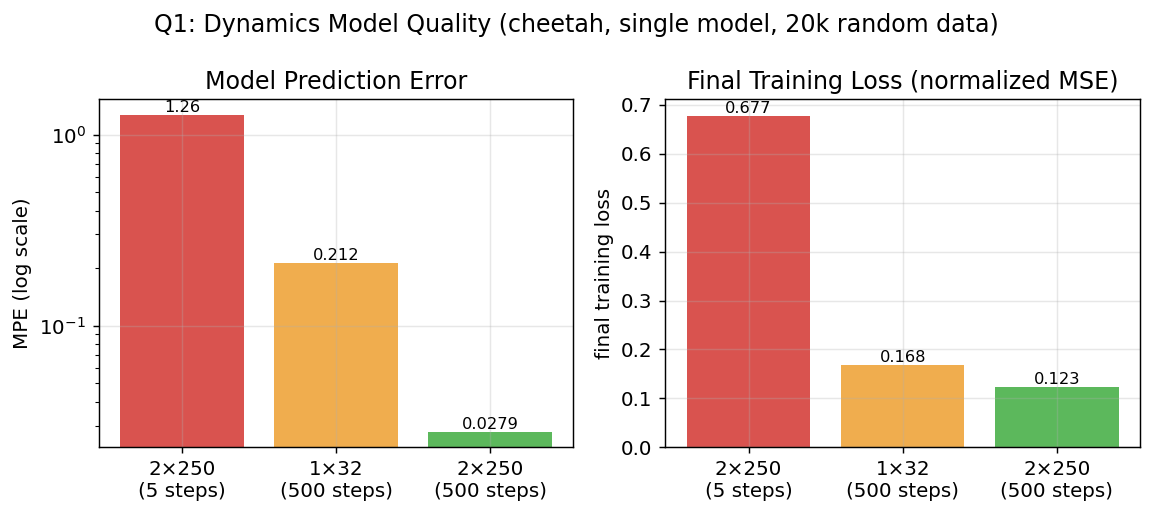
固定收集 20000 条随机数据,训练单个动态模型,比较三种配置的训练末 loss(标准化空间 MSE)与模型预测误差 MPE(沿一条固定 10 步动作序列,模型预测状态与真实状态的均方误差)。数字来自 itr_0_losses.npy 与 itr_0_mpe.npy。
| 配置 | 网络 | 梯度步 | 训练末 Loss | 最小 Loss | MPE ↓ | 说明 |
|---|---|---|---|---|---|---|
q1_cheetah_n5_arch2x250 | 2×250 | 5 | 0.6774 | 0.6774 | 1.2648 | 大网但严重欠训 |
q1_cheetah_n500_arch1x32 | 1×32 | 500 | 0.1676 | 0.1557 | 0.2122 | 小网但训练充分 |
q1_cheetah_n500_arch2x250 | 2×250 | 500 | 0.1227 | 0.1149 | 0.0279 | 大网 + 训练充分(最佳) |
图 1:Q1 动态模型质量对比。MPE(对数轴)随”容量↑、训练量↑“单调下降:欠训 2×250(5步) 1.26 → 充分训 1×32(500步) 0.21 → 充分训 2×250(500步) 0.028。
为什么 2×250-500步 最好?(本质)
两个因子共同决定模型质量:容量(能不能表达复杂动力学)与优化充分度(有没有训到位)。
n5尽管网络大,但只走 5 步梯度,loss 还在 0.68,远没收敛 → MPE 最差;1x32训了 500 步但容量太小,loss 卡在 0.17;只有大容量 + 充分训练才把 loss 压到 0.11、MPE 压到 0.028。这正对应 PDF 的预期:“第一条命令 loss 应在 500 步内降到 0.2 以下”——我们的 1×32 达到 0.17、2×250 达到 0.12,均达标。
6.1 训练损失监控:动态模型 loss vs 梯度步 / 迭代
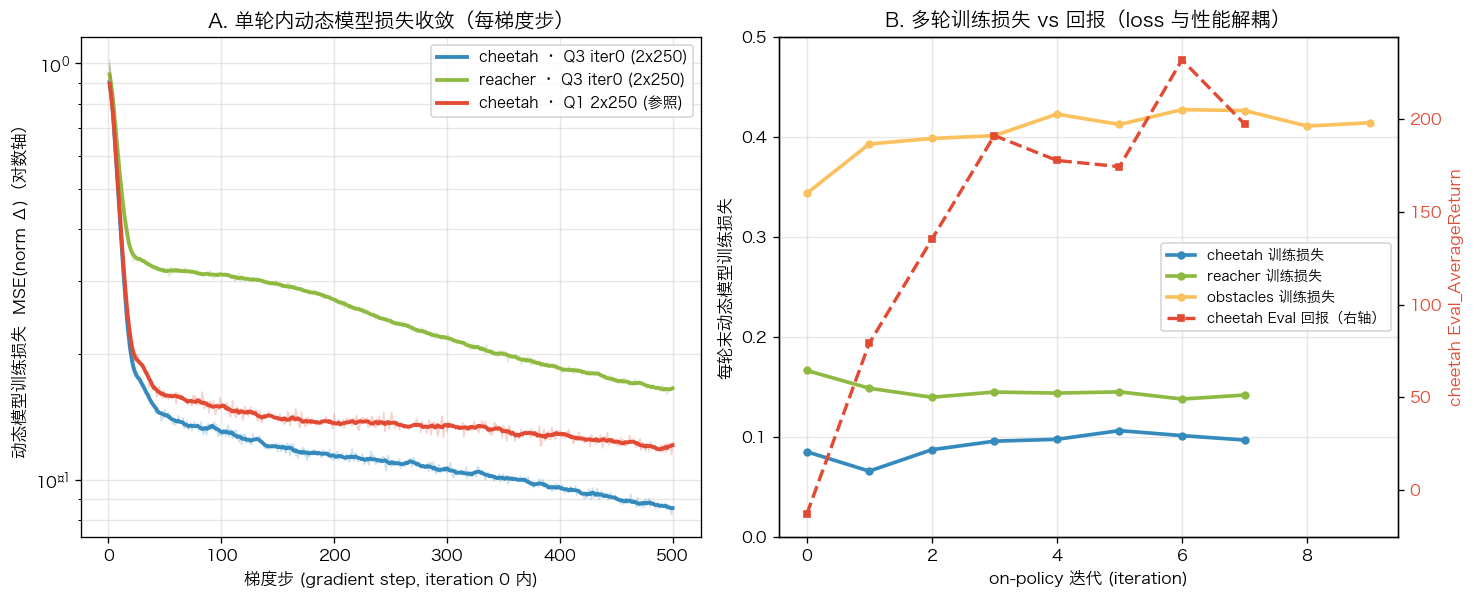
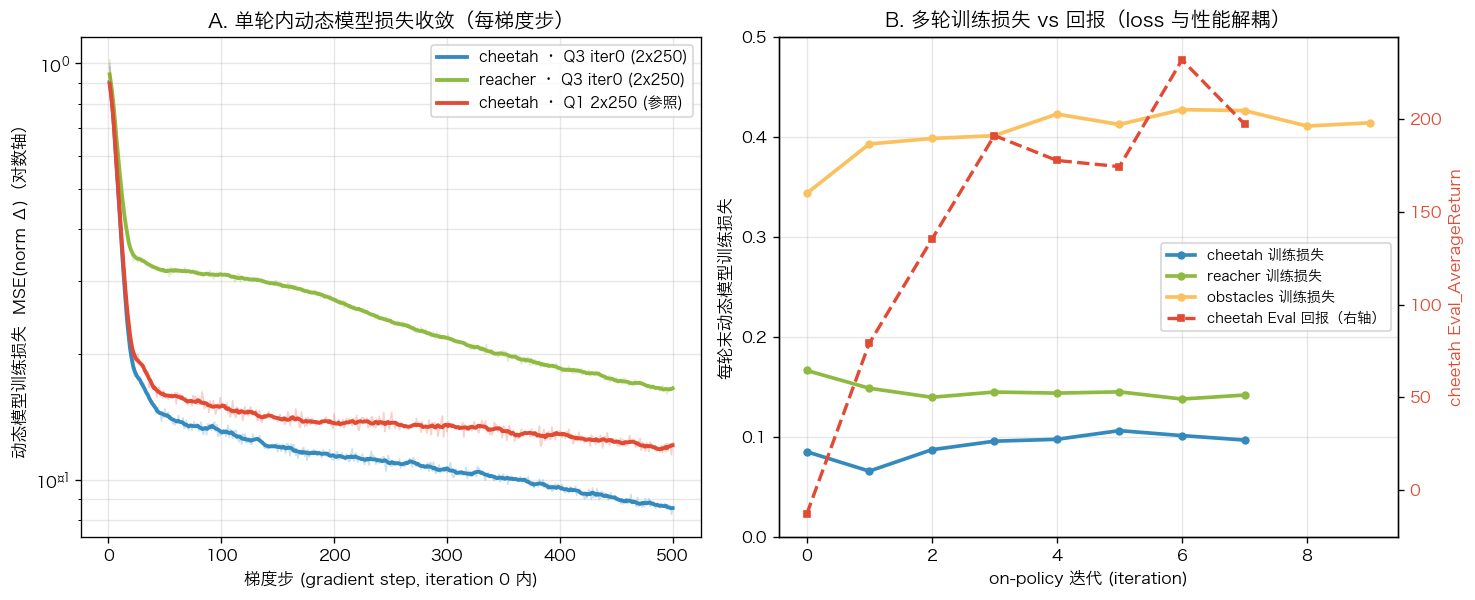
Model-Based RL 的核心训练信号不是回报、也不是上面的 MPE,而是动态模型自身的监督训练损失——标准化状态增量的单步 MSE (见 §5.1)。这是优化器真正在最小化的目标。我们从两个粒度监控它:(A) 单轮内每一梯度步的 loss(来自 itr_0_losses.npy,每轮落盘的全部中间 loss);(B) 多轮 on-policy 迭代里每轮末的 loss(来自 tfevents 的 Training_Loss 标量,每迭代一点),并与该环境的 Eval 回报叠放,观察”loss 与性能”的关系。
图 2:动态模型训练损失监控。左(A):iteration 0 内每一梯度步的 loss(对数轴),三条 run 都在 ~500 步内从 ≈1.0 单调收敛到平台——cheetah Q3 降到 0.085、cheetah Q1 2×250 到 0.123、reacher 到 0.167(reacher 20 维、动力学更难,平台更高)。右(B):多轮聚合中每轮末的训练 loss(左轴)与 cheetah 的 Eval 回报(右轴,红色虚线)。三个环境的每轮 loss 都基本走平甚至略升(obstacles 从 0.34 升到 0.41),而 cheetah 回报却从 −13 一路升到 ≈200——训练 loss 的绝对值与规划性能显著解耦。
这张图和 Q1 的 MPE 图(图 1)有什么本质区别?别混为一谈
- 图 1 的 MPE 是”评估指标”,不是训练 loss。 MPE 在训练之后沿一条固定的 10 步动作序列做开环多步 rollout,累计”预测状态 vs 真实状态”的误差——它衡量多步外推的准确性,正是规划真正依赖的能力,且会受误差沿视野复合(§12.1)放大。
- 本图(图 2)是”训练损失”,即优化目标本身。 它是单步、在标准化增量空间、在训练/buffer 分布上算的 MSE。它衡量的是”模型有没有在当前数据上被训到位”,不含多步复合。
- 为什么 loss 收敛 ≠ 规划变好? 右图给出直接证据:cheetah 每轮 loss 稳在 0.06–0.11、obstacles 甚至上升,但回报持续改善。原因是每轮 on-policy 聚合把新的、更难拟合的状态(好策略才会到达的区域)加入 buffer,抬高了 loss 的绝对水平;真正让规划变好的是这些数据让模型在关键状态区域更准(体现为 MPE/回报改善),而非训练 loss 数字下降。所以在 MBRL 里,训练 loss 只能判断”这一轮训练是否正常收敛”,判断”规划好不好”必须看 MPE 与回报。
7. Q2:MPC 动作选择(obstacles 单轮)
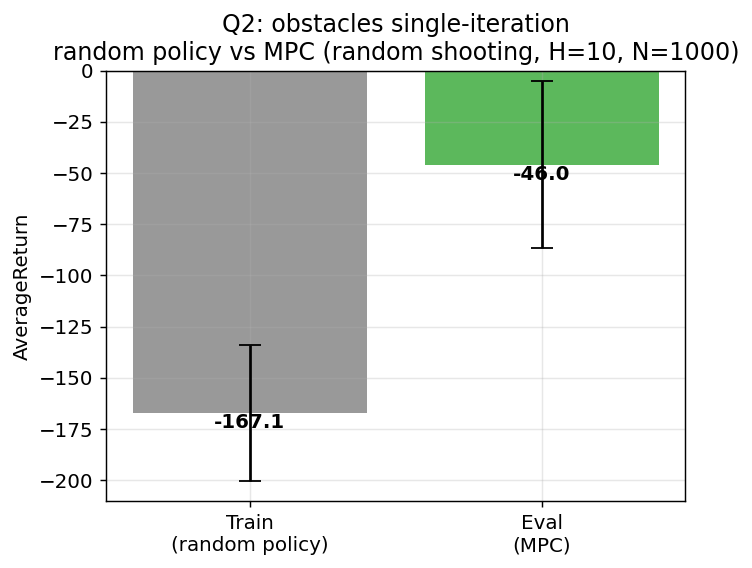
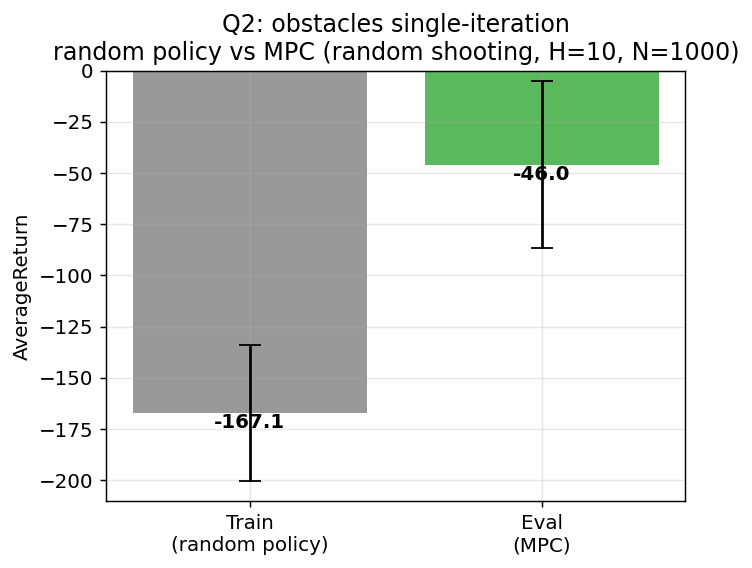
只跑 1 轮:先用随机策略收 5000 步数据、训 20 步模型,再用该模型驱动的 MPC(随机打靶,、) 去评测。对比 Train_AverageReturn(随机动作)与 Eval_AverageReturn(MPC)。
| 指标 | 数值 | 官方参考 | 是否达标 |
|---|---|---|---|
| Train_AverageReturn(随机策略) | −167.10 ± 33.23 | ≈ −160 | ✅ |
| Eval_AverageReturn(MPC) | −45.99 ± 40.87 | −70 ~ −50 | ✅(略优于区间上沿) |
模型 MPE(itr_0) | 0.000202 | — | — |
图 3:Q2 随机策略 vs MPC(单轮,各为一个点)。仅凭随机数据训练的模型,MPC 就把回报从 −167 提到 −46——证明 (a) 模型学到了有用的动力学、(b) MPC 规划正确。
这一步验证了什么?
Train 用的是随机动作(−167),Eval 用的是同一批随机数据训出的模型去做 MPC(−46)。两者数据同源、唯一区别是”有没有用模型规划”。回报大幅提升,说明动态模型 + 随机打靶 + 已知奖励这条链路是通的,为后面的多轮聚合打底。
8. Q3:多轮 on-policy MBRL
在 obstacles/reacher/cheetah 上跑多轮聚合,每轮用最新模型的 MPC 采新数据并重训。降规模说明见 §4;这里看的是回报是否随迭代上升的趋势,而非追平官方绝对值。
| 环境 | 迭代数 | 首轮 Eval(随机模型) | 末轮 Eval | 最好 Eval | 趋势 |
|---|---|---|---|---|---|
obstacles | 10 | −46.0 | −28.3 ± 14.5 | −25.4 | ↑ 上升 |
reacher | 8 | −2111.2 | −289.1 | −286.4 | ↑ 大幅上升 |
cheetah | 8 | −13.1 | 197.2 | 231.8 | ↑ 强上升 |
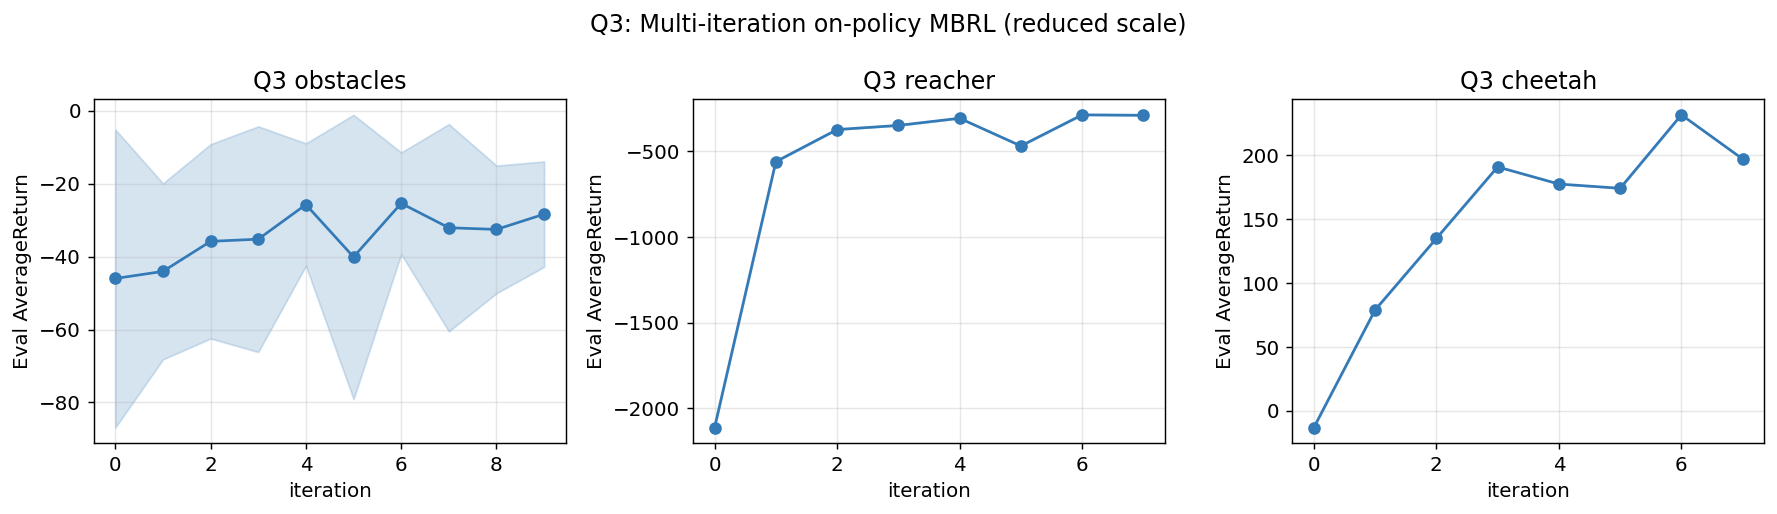
图 4:Q3 多轮 on-policy MBRL 学习曲线(降规模)。三个环境的 Eval 回报都随迭代明显上升:reacher 从 −2111 一路收敛到 ≈ −289,cheetah 从 −13 升到约 200,obstacles 从 −46 降到约 −28。曲线的抖动来自单种子 + 小 eval_batch_size。
on-policy 聚合为什么有效?
首轮的模型只见过随机数据,覆盖不到”好策略会去的状态”,所以首轮 Eval 很差(reacher −2111)。此后每轮用最新 MPC 采到的数据都更贴近”我们真正想优化的轨迹”,模型在这些区域越来越准,MPC 也就规划得越来越好——这是一个”越用越准、越准越好用”的正反馈。reacher 第 1 轮就从 −2111 跳到 −560,正是补上 on-policy 数据后模型质量的突变。受降规模影响,绝对值低于官方参考(官方 reacher −250~−300、cheetah 250~350),但上升趋势一致。
降规模说明(对照官方命令)
obstacles 用
n_iter=10(原 12);reacher 用n_iter=8, 每轮 500 步, N=500, batch 1500(原15/1000/1000/5000);cheetah 用n_iter=8, 每轮 500 步, N=500, batch 1500, H=15(原20/1500/1000/5000)。reacher/cheetah 的eval_batch_size=200只够 1 条评测轨迹,故末轮 std=0。
8.1 结果可视化(视频)
上面的曲线只给出回报数字,这里补上三个环境最终 MPC 控制策略在真实环境里的 rollout 视频,直观看到”学到的动态模型 + 随机打靶规划”到底把智能体控成了什么样子。说明模型来源:HW4 的训练脚本从未保存动态模型(各 run 未加 --save_params,且 MBAgent 本身没有 save())。因此我们按 §4/§8 的降规模口径为每个环境重新跑了一遍简短的 on-policy MBRL,并把学到的 FFModel.state_dict() 与归一化统计量 data_statistics 落盘,再载回构建 MPC 策略、在真实环境里逐步规划、执行、录帧(每个环境跑多个种子取较好的一条)。全部为真实 rollout,无任何脚本化/伪造轨迹;渲染脚本与 checkpoint 属于代码和训练产物,不随本站发布。
两种渲染路径(复用 HW2/HW1 pilot 管线)
cheetah / reacher 是 MuJoCo 环境,直接用环境自带的
render()(MUJOCO_GL=glfw,rgb_array)抓帧;obstacles 是纯 numpy/matplotlib 环境(连 MuJoCo 都不需要),故手写了一个帧抓取器:每一步在固定坐标轴的 Agg 画布上重绘边界、5 个矩形障碍、目标(绿星)、智能体(黑点)与蓝色轨迹尾迹,再用fig.canvas.tostring_rgb()取 RGB 交给 imageio。三段均以 H.264/yuv420p 编码(≤480px)。视频是截取的片段,与训练全程ep_len的 Eval 口径不同,因此不在视频说明中给出回报数字。
图 0:视频 1:cheetah-cs285-v0 最终 MPC 策略 rollout——“半猎豹”已学会持续向前奔跑(而非原地抽搐/翻倒)。模型为本次按降规模口径重训后存盘,渲染时用 MPC 随机打靶在真实环境中规划,并从多个渲染种子中挑选了较好的一段,不代表平均性能。重训配置、片段回报与耗时没有公开日志,本页只描述视频中可见的行为;回报数字以第 8 节的公开曲线为准。因降规模,绝对回报低于官方 250–350,但”向前跑”的定性行为已明确成形。
图 0:视频 2:reacher-cs285-v0 最终 MPC 策略 rollout——红色 7-DOF Sawyer 机械臂驱动末端 finger(蓝点)贴近每回合随机的 3D 目标(绿点)。模型为本次按降规模口径重训后存盘,渲染时用 MPC 随机打靶规划,并从多个渲染种子中挑选了较好的一段,不代表平均性能。重训配置、片段回报与耗时没有公开日志,本页只描述视频中可见的行为;回报数字以第 8 节的公开曲线为准。
图 0:视频 3:obstacles-cs285-v0 最终 MPC 策略 rollout——智能体(黑点)从随机起点绕过红色障碍导航到目标(绿星),蓝线为其真实轨迹尾迹。模型为本次按降规模口径重训后存盘。因该环境是纯 numpy/matplotlib,渲染用手写帧抓取器(固定坐标轴重绘边界/障碍/目标/智能体/轨迹后编码为视频);MPC 随机打靶规划,片段从多个渲染种子中挑选,不代表平均性能。智能体很快抵达目标、回合随即结束(到达阈值触发 done),所以视频很短。重训配置、片段回报与耗时没有公开日志,本页只描述视频中可见的行为。
9. Q4:三大超参消融(reacher)
【有限配置消融】【单种子/少轨迹】 仅支持本预算下的局部趋势。
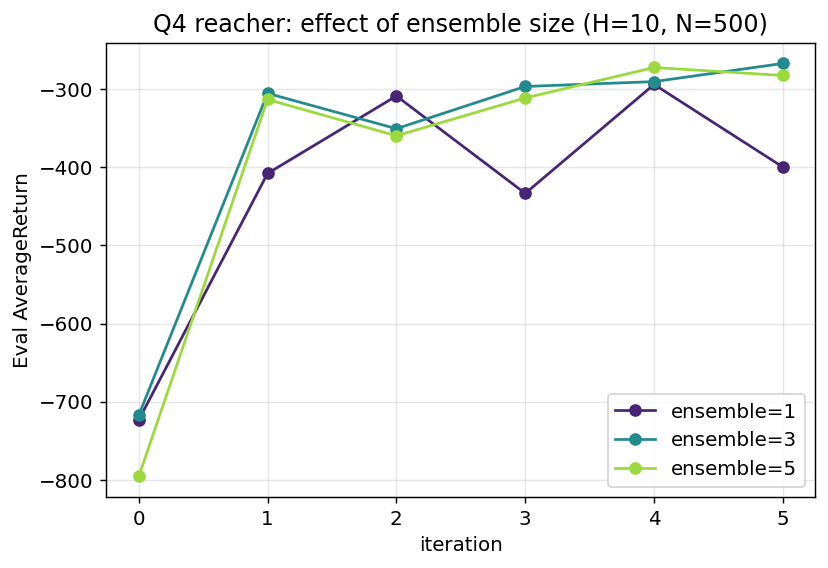
在 reacher 上分别单独改变 ensemble 大小、候选序列数 、规划视野 ,其余固定(降规模基线:、每轮 400 梯度步、、、ensemble=3)。
9.1 Ensemble 大小的影响
| ensemble 大小 | 末轮 Eval | 最好 Eval | 结论 |
|---|---|---|---|
| 1 | −399.7 | −294.0 | 单模型:末轮明显更差、更不稳 |
| 3 | −267.1 | −267.1 | 最佳 |
| 5 | −282.6 | −272.4 | 与 3 相当(收益饱和) |
图 5:Q4 ensemble 大小消融。ensemble=1 的曲线末端明显下滑,ensemble=3/5 更高;这支持本设置下集成规模与表现相关,但没有直接测量模型校准、过度自信或跨种子方差。
9.2 候选动作序列数 的影响
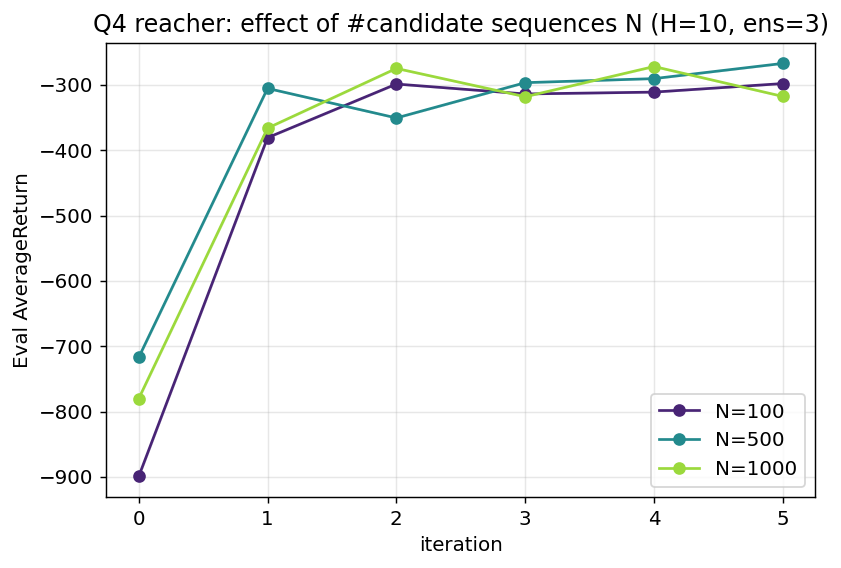
| 末轮 Eval | 最好 Eval | 结论 | |
|---|---|---|---|
| 100 | −298.0 | −298.0 | 候选太少,搜不到好序列 |
| 500 | −267.1 | −267.1 | 最佳 |
| 1000 | −317.7 | −271.9 | 最好值与 500 相当(收益饱和 + 单种子抖动) |
图 6:Q4 候选数 消融。 全程最差; 明显更好且彼此接近。更多候选 = 对 更好的蒙特卡洛近似,但边际收益递减; 末轮的回撤(−318)主要是单种子小 eval 的噪声(其最好值 −272 与 持平)。
9.3 规划视野 的影响(最能体现”模型误差复合”)
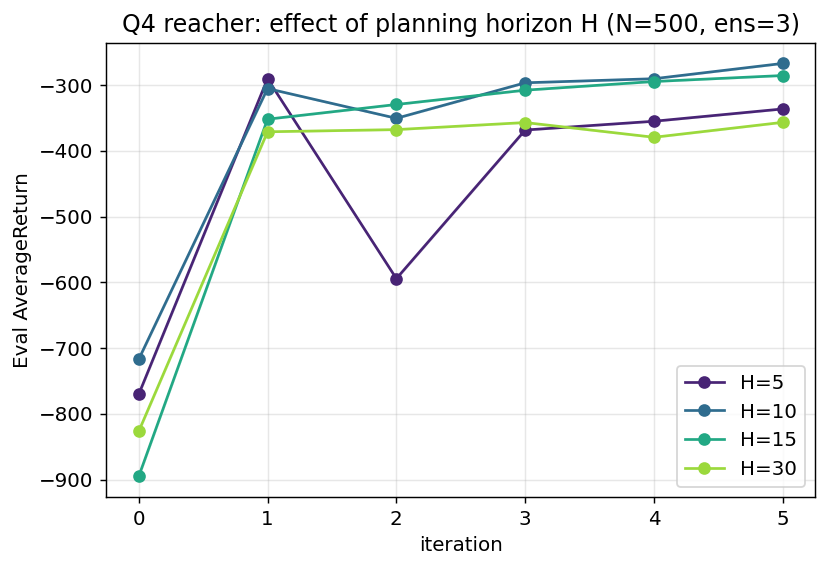
| 末轮 Eval | 最好 Eval | 结论 | |
|---|---|---|---|
| 5 | −336.4 | −290.5 | 看得太近,MPC 短视 |
| 10 | −267.1 | −267.1 | 最佳(甜蜜点) |
| 15 | −285.6 | −285.6 | 略差于 10 |
| 30 | −356.8 | −356.8 | 最差:模型误差复合压垮”看得远”的收益 |
图 7:Q4 规划视野 消融。在已测取值中 最好、 最差;该现象与长视野会放大模型误差的机制一致,但本实验没有分解误差来源,不能单独证明因果。
降规模说明(Q4)
全部为 reacher,降规模基线:
n_iter=6(原 15)、每轮400步(原 1000)、batch_size=800、eval_batch_size=200(原 400,故 std=0)。ensemble 与 horizon 消融固定N=500;ensemble_size=3的那次运行同时充当三张消融图的公共基线点(、、ens=3)。
10. Q5:随机打靶 vs CEM(cheetah)
在 cheetah 上对比随机打靶与 CEM(迭代 2 / 4),其余相同(降规模:、每轮 500 步、、)。
| 方法 | iter0 Eval(同一模型) | 末轮 Eval | 结论 |
|---|---|---|---|
| 随机打靶 random | −13.1 | 191.0 | 基线 |
| CEM(迭代 2) | 37.3 | 180.7 | iter0 已优于随机;末轮与随机相当(迭代太少) |
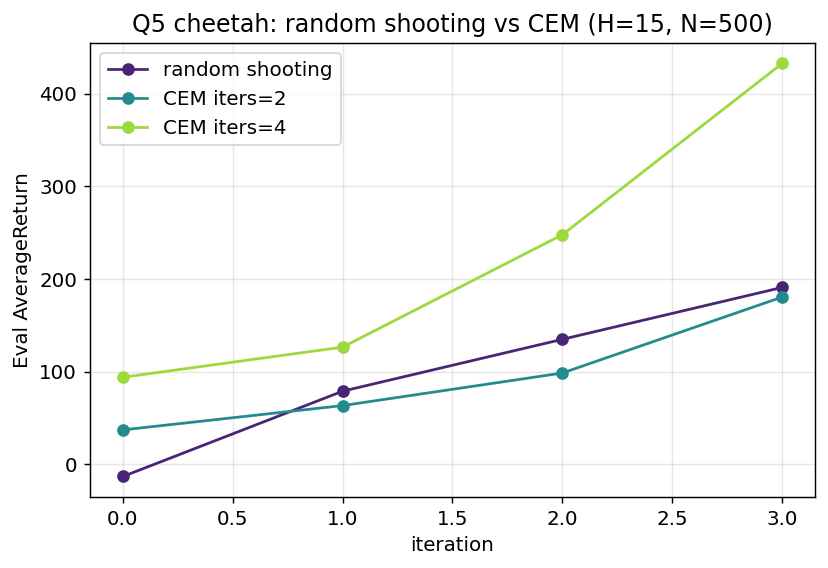
| CEM(迭代 4) | 94.1 | 432.9 | 全程最优,末轮 ≈ 随机的 2.3 倍 |
图 8:Q5 随机打靶 vs CEM(cheetah,、)。CEM 迭代 4 全程碾压,末轮 432.9 远超随机打靶的 191;CEM 迭代 2 因迭代太少,末轮与随机打靶接近。
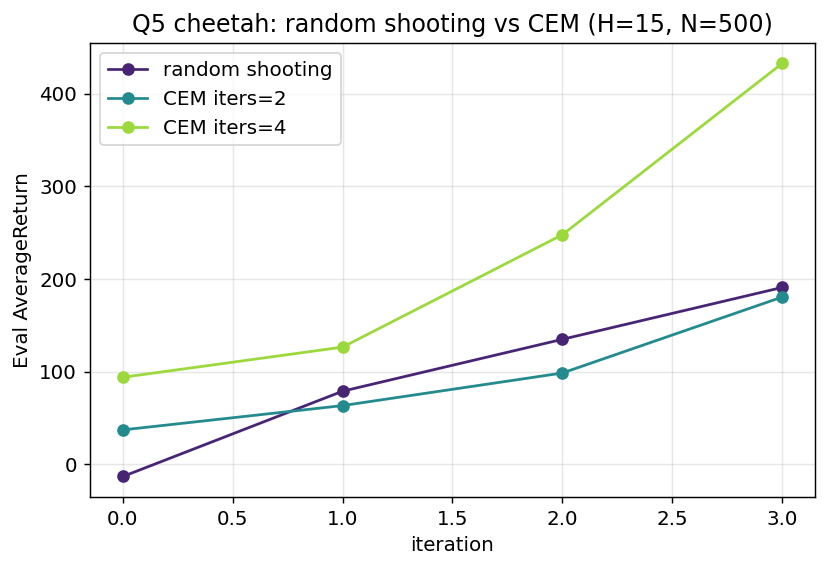
最干净的证据:iter0 是”同一个模型、不同规划器”的对照
第 0 轮三组使用同一随机数据与同一模型,评测规划器分别得到:随机打靶 −13.1、CEM(2) 37.3、CEM(4) 94.1。这是较干净的同模型对照,说明在该模型、采样预算与种子下更多 CEM 迭代找到更高模型预测回报并带来更高真实 Eval;它不构成“CEM 对所有目标都更强”的普遍证明。后续轮次的数据分布也随规划器改变,已不再是只差规划器的单变量对照。
降规模说明(Q5)与一处诚实提醒
cheetah,降规模:
n_iter=4(原 5)、每轮500步(原 1500)、N=500(原 1000)、batch 1500 / batch_initial 3000(原 5000/5000)、eval_batch_size=200(故 std=0)。因此绝对值低于官方 CEM 参考(官方期望 800+)。CEM 迭代 2 在本降规模下末轮未拉开与随机打靶的差距——这与”CEM 需要足够迭代次数才能收紧分布”一致:迭代 2 收紧不充分、 又被砍半,优势被噪声淹没;迭代 4 才充分体现出来。
11. Q6:MBPO(用模型造 rollout 喂 SAC)
【存在混杂】 各设置的 sac_n_iter 更新预算按作业命令并不相同(配置未公开,无法在本页核对),禁止据此做 的因果排序。
前面 Q1–Q5 都是”用模型直接做 MPC 规划”。Q6 换一条路——MBPO(Model-Based Policy Optimization):不拿模型去规划动作,而是用学到的 dynamics model 在”想象”里造一批短 rollout 塞进 replay buffer,再喂给一个 model-free 的 SAC 智能体去训练。这样既保留 SAC 的策略学习能力,又用模型放大数据量、提升样本效率。核心开关是 --mbpo_rollout_length k(对应 mbpo_agent.collect_model_trajectory:从真实 buffer 采起点、用 SAC actor 决策、ensemble 平均前推 步、已知奖励查表)。按 PDF Q6 我们比较三档:
- (model-free SAC 基线):完全不造模型数据,退化成纯 SAC(
rl_trainer里mbpo_rollout_length>0才会collect_model_trajectory)。 - (Dyna 单步):每个真实步额外造 1 步模型 rollout 并多做梯度更新。
- (MBPO 长 rollout):造 10 步模型 rollout,样本效率最高但也最吃模型精度。
按作业命令, 与 使用了不同的 SAC 梯度步预算 sac_n_iter(具体配置未随本站公开,无法在本页核对)。这符合“模型数据支持更多更新”的系统级配方,但也形成一个重要混杂:Q6 比较的是“rollout 长度 + 更新预算”的组合,而非只改 的严格消融。要识别 的独立作用,还需固定 sac_n_iter 做补充实验;本报告不补造该数据。
| 超参 | 含义 | 本次值(cheetah) |
|---|---|---|
mbpo_rollout_length | 模型内 rollout 长度(本题主变量) | {0, 1, 10} |
sac_n_iter | 每轮 SAC 梯度步(含造模型数据) | 随 不同(按作业命令;具体值未公开,无法在本页核对) |
n_iter | on-policy 迭代轮数 | 8 (原10) |
num_agent_train_steps_per_iter | 每轮动态模型梯度步 | 1000 (原1500) |
batch_size_initial / batch_size | 首轮随机 / 每轮 on-policy 采集 | 5000 / 5000(同官方) |
sac_size×sac_n_layers | SAC 网络 | 256 × 2(同官方) |
sac_batch_size / sac_learning_rate | SAC 批量 / 学习率 | 1500 / (同官方) |
sac_init_temperature / sac_discount | SAC 初始温度 / 折扣 | 0.1 / 0.99(同官方) |
eval_batch_size | 每轮评测采集 | 1500(=3 条轨迹,用于 std 阴影) |
三档的 Eval 回报(Eval_AverageReturn,mean ± std 来自每轮 3 条评测轨迹)汇总如下:
| rollout 长度 | iter0 Eval | 末轮 Eval | 最好 Eval | 趋势 / 结论 |
|---|---|---|---|---|
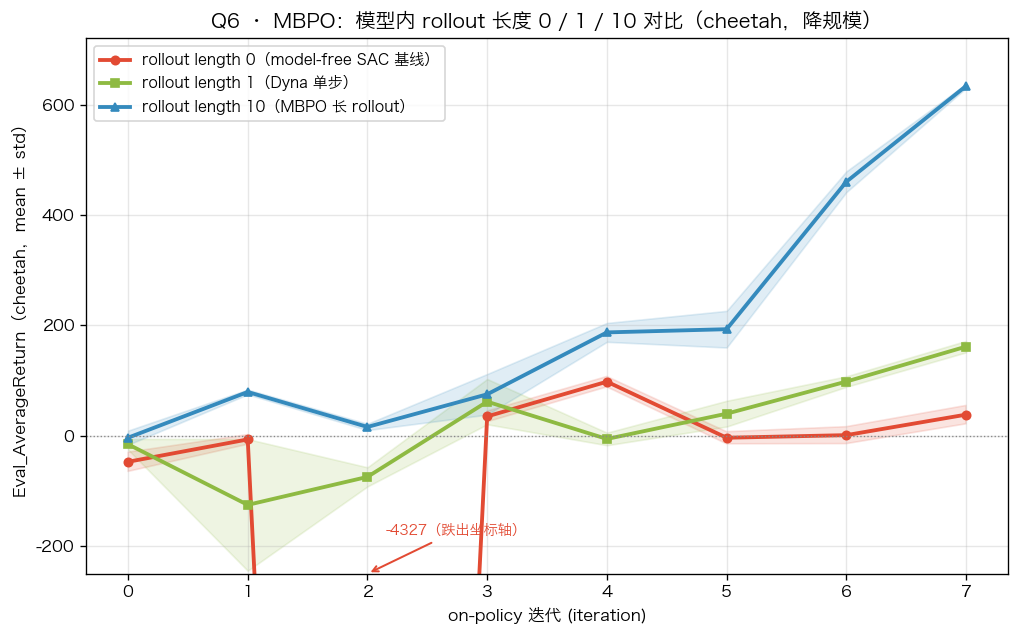
| 0(model-free SAC) | −47.3 ± 17.4 | 38.2 ± 16.7 | 97.9 ± 9.5(it4) | 最弱;第 2 轮一度崩到 −4327(SAC 不稳) |
| 1(Dyna 单步) | −15.5 ± 9.7 | 161.5 ± 10.4 | 161.5 ± 10.4(it7) | 明显优于基线(末轮 ≈ 基线 4.2×) |
| 10(MBPO 长 rollout) | −3.6 ± 12.8 | 633.9 ± 3.6 | 633.9 ± 3.6(it7) | 全程最优,末轮 ≈ 基线 16.6×、单步 3.9× |
图 9:Q6 MBPO 模型内 rollout 长度消融(cheetah,降规模)。阴影是同一策略 3 条评测轨迹的离散度,不是跨种子不确定性。在本次单种子运行的三个离散取值中,末轮回报依次为 38.2、161.5、633.9; 第 2 轮出现 −4327。纵轴裁剪到 [−250, 720],因此该异常点不在可视范围内。
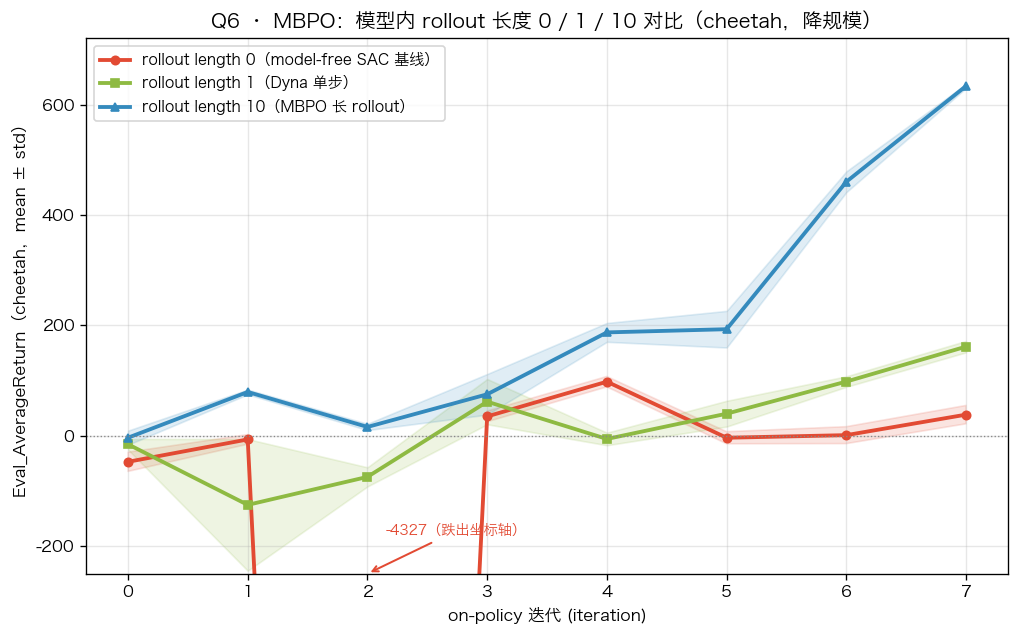
回扣模块 08:rollout 长度 是”样本效率 ↔ 模型误差复合”的权衡
- 退化成 model-free。 不用模型造任何数据,SAC 只能啃真实采到的那点样本;本题真实数据每轮才 5000 步,SAC 学得慢、还在第 2 轮崩了一次(−4327)——正是 model-free 在低数据量下高方差的典型表现。
- 本设置中模型数据与更高回报相关。 模型转移不消耗真实环境步,但并非“免费真数据”:越往后越受模型偏差污染。 的末轮回报从 162 到 634,支持样本效率解释;因仅单种子且训练动力学可能不同,不能把差值完全归因于 的因果效应。
- 不是理论上越大越好。 过长 rollout 会累积模型误差。这里只测到 ,且更新预算同时变化,所以无法判断拐点是否出现、更不能据此断言 cheetah 动力学“相对温和”。MBPO 使用短 rollout/调度的动机正是控制这种误差,但最佳长度需实验确定。
- 在已测试集合 中, 最好;没有测试 或邻近取值,不能把它称为全局最优,也不能据此定位误差拐点。更差模型通常要求更短 rollout 是合理机制判断,仍需针对环境验证。
降规模说明(Q6)与诚实提醒
cheetah,降规模:
n_iter=8(原 10)、num_agent_train_steps_per_iter=1000(原 1500);batch_size(_initial)、SAC 超参与sac_n_iter按作业命令设置(具体配置未公开)。结果方向与作业参考预期一致,但官方参考并非同预算、同随机性的独立复现基线。单种子(seed=1)单次运行;表中 std 为同一策略 3 条评测轨迹之间的标准差。 第 2 轮的 −4327 保留未平滑;它说明该次运行不稳定,不足以推出 model-free SAC 一般会崩溃。
12. 理论 ↔ 实践对接(回扣模块 08)
本节把实测逐条对回 模块 08 的理论。
12.1 模型误差沿规划视野复合
开环预测 每步都把上一步的误差喂进下一步。记完整的学习转移映射为 ,假设 对状态满足 Lipschitz 条件、常数为 ,且单步预测误差不超过 ,递推可得到如下示意界:
这解释了两件事:(1) Q4 中规划视野 过长反而变差——收益(看得更远)敌不过复合误差;(2) MPC 只执行第一步就重规划——用真实状态定期”纠偏”,把复合误差截断在 步内。
12.2 ensemble 降低认知不确定性
单模型在数据稀疏区可能给出过度自信的错误外推。集成平均可降低初始化/采样噪声,却不等价于自动对认知不确定性做保守边缘化:模型分歧只有在被显式传播或惩罚时才形成风险信号,多个模型也可能一致地错。Q4 只表明本设置中更大 ensemble 与更好表现相关,未直接测量校准或分歧惩罚。
12.3 CEM 是更聪明的黑盒优化
随机打靶在整个动作空间”撒网”,高维长视野下命中好序列的概率随 指数衰减。CEM 用”精英拟合高斯 → 收紧采样”把预算集中到高回报区域,是 的迭代逼近。Q5 中 CEM > 随机打靶、且迭代 4 > 迭代 2,正对应”迭代越多、分布收紧越充分”。
12.4 规划预算的三向权衡
MPC 的计算量 。Q4/Q5 展示的是同一枚硬币的两面:↑、CEM 迭代↑ 提升规划质量但线性增算力; 有最优值(受 §12.1 限制);ensemble↑ 更稳但成倍增算力。在固定算力下如何分配这几项预算,是 MBRL 工程的核心调参。
12.5 MBPO 的 rollout 长度权衡(Q6 实测)
模块 08 还讲了 MBPO:不用模型直接规划,而是用模型造短 rollout 喂给 SAC。本作业比较 ,单次运行末轮 Eval 为 38/162/634;因此只能说在这三个已测取值与该随机种子下结果单调, 的末轮数值约为 的 16 倍。由于 曾发生异常崩溃、没有跨种子重复,也没有测试 ,这组数据支持但不单独证明普遍的样本效率规律,更不能确认拐点尚未出现。
13. 反思
为什么这样:预测标准化的 Δs 而非直接预测
能不能不这样? 能,但会更难训。直接预测绝对状态时,网络得同时学”把 抄过去”这件本该免费的事,且大量级维度主导 MSE。预测标准化增量把学习目标变成”小而均衡”的量,等价于给网络加了一个恒等映射的残差先验——这与 ResNet 的残差、扩散模型预测噪声是同一种”让网络只学差量”的智慧。
为什么这样:MPC 只执行第一步
能不能把规划出的 步全执行完再重规划? 可以,但会更差。模型误差沿视野复合(§12.1),越靠后的规划步越不可信;开环执行完整个 步等于把这些不可信的动作照单全收。只执行第一步、每步用真实状态重规划,是”信任模型一步、其余交给反馈”的最优折中——代价是算力翻 倍,这也是 MBRL 慢的根源。
为什么这样:ensemble 用”平均”而非”取最悲观(min)”
能不能像 offline RL 那样取 min 做保守估计? 可以,且在纯 offline、需要强不确定性惩罚时更合适(如 MOReL/COMBO)。但本作业是 online 且奖励已知、还能持续采 on-policy 数据纠偏,过度保守反而抑制探索。取平均是”消偏但不过度悲观”的中庸选择;若换到 offline 场景,把平均换成”均值 − β·标准差”往往更稳。
数据诚实性 / 本次实验的局限
- 显式降规模。 Q3/Q4/Q5 缩减了
n_iter/梯度步/N/batch_size(见 §4 红字),故绝对回报低于官方参考(如官方 cheetah 全量可达 250–350、CEM 800+);本报告只主张趋势正确,不主张复现官方绝对值。- 单种子(seed=1)单次运行。 表中 std 是”同一策略多条评测轨迹之间”的方差,非跨种子方差;个别轮次波动可能含运气成分。
- Q6(MBPO)已完整跑通(§11):cheetah 上 rollout 0/1/10 三组对照,末轮 Eval 38/162/634,趋势与官方一致;同样降规模(
n_iter=8、模型步 1000),故 的 634 低于官方 1000+。- 唯一的非算法改动是加了 MPE 的
np.save(§3 踩坑框),不影响任何训练/规划结果。
High-level insight
这份作业把 MBRL 的全部张力浓缩到一个数上:模型误差。学模型的每一个设计(预测标准化增量、集成、on-policy 聚合)都在压低它;用模型的每一个设计(限制视野 、只执行第一步重规划、CEM 收紧采样)都在防止它复合放大。理解了”如何在一个必然不完美的模型上安全地规划”,你就理解了从经典 MPC 到今天 Dreamer/TD-MPC 的整条主线——它们都在回答同一个问题:怎样既享受模型带来的样本效率,又不被模型的谎言反噬。
Claim–Evidence 对照
| 结论 | 状态 | 证据 | 升级条件 |
|---|---|---|---|
| 在本次 Q1 三组联合配置比较中,大网络且训练 500 步的设置取得最低 MPE。 | 已验证 | 图片 ↗ | — |
| obstacles 的单轮比较中,模型驱动 MPC 的评测回报高于随机采集策略。 | 已验证 | 图片 ↗ | — |
| 本次降规模运行中,三个环境的 on-policy 数据聚合曲线总体改善。 | 已验证 | 图片 ↗ | — |
| reacher 的有限配置消融中,ensemble=3、候选数 500、规划视野 10 分别取得各自比较中的最佳末轮结果。 | 已验证 | 图片 ↗图片 ↗图片 ↗ | — |
| 本次 cheetah 规划器比较中,4 次迭代的 CEM 曲线高于随机打靶和 2 次迭代 CEM。 | 已验证 | 图片 ↗ | — |
| Q6 的三个已测设置中,rollout 长度为 10 的设置末轮回报最高;该结果为单种子运行,且各设置的完整配置未公开,不能据此识别 rollout 长度的独立效应。 | 已验证 | 图片 ↗ | — |
证据文件
12 个文件