PPO / SAC 与稳定性:从 surrogate 到诊断闭环
本报告迁移自原课程材料,经 AI 事实核查未发现存疑项,未逐页人工审核;结论与证据请以页面列出的原始文件为准。
实验目标
本作业不调用 Gym 算法封装:本地实现 CartPole 方程、连续点质量控制环境、PPO 与 SAC,并在 Mac CPU 上完成 8 组主实验配置(每组 3 个种子,共 24 个 run)及一个 100k-step 长预算演示。
实验设置
| 环境 | 两个环境都在作业目录内原创实现,避免第三方环境版本/API 差异。CartPole 使用经典质量、杆长、20ms Euler 方程;PointControl 有速度衰减与动作限幅。后者是快速机制验证,不代表 MuJoCo 复杂接触控制。 |
|---|---|
| 随机种子 | 0、1、2 |
| 关键配置 | default-config.json |
本报告迁移自 CS285 课程材料 [1]。
本作业不调用 Gym 算法封装:本地实现 CartPole 方程、连续点质量控制环境、PPO 与 SAC,并在 Mac CPU 上完成 8 组主实验配置(每组 3 个种子,共 24 个 run)及一个 100k-step 长预算演示。重点不是“跑出一个分数”,而是把 KL、clip fraction、entropy、Q/value loss 和梯度范数放回稳定性解释链。
项目入口
1. 摘要与证据口径
主要结果
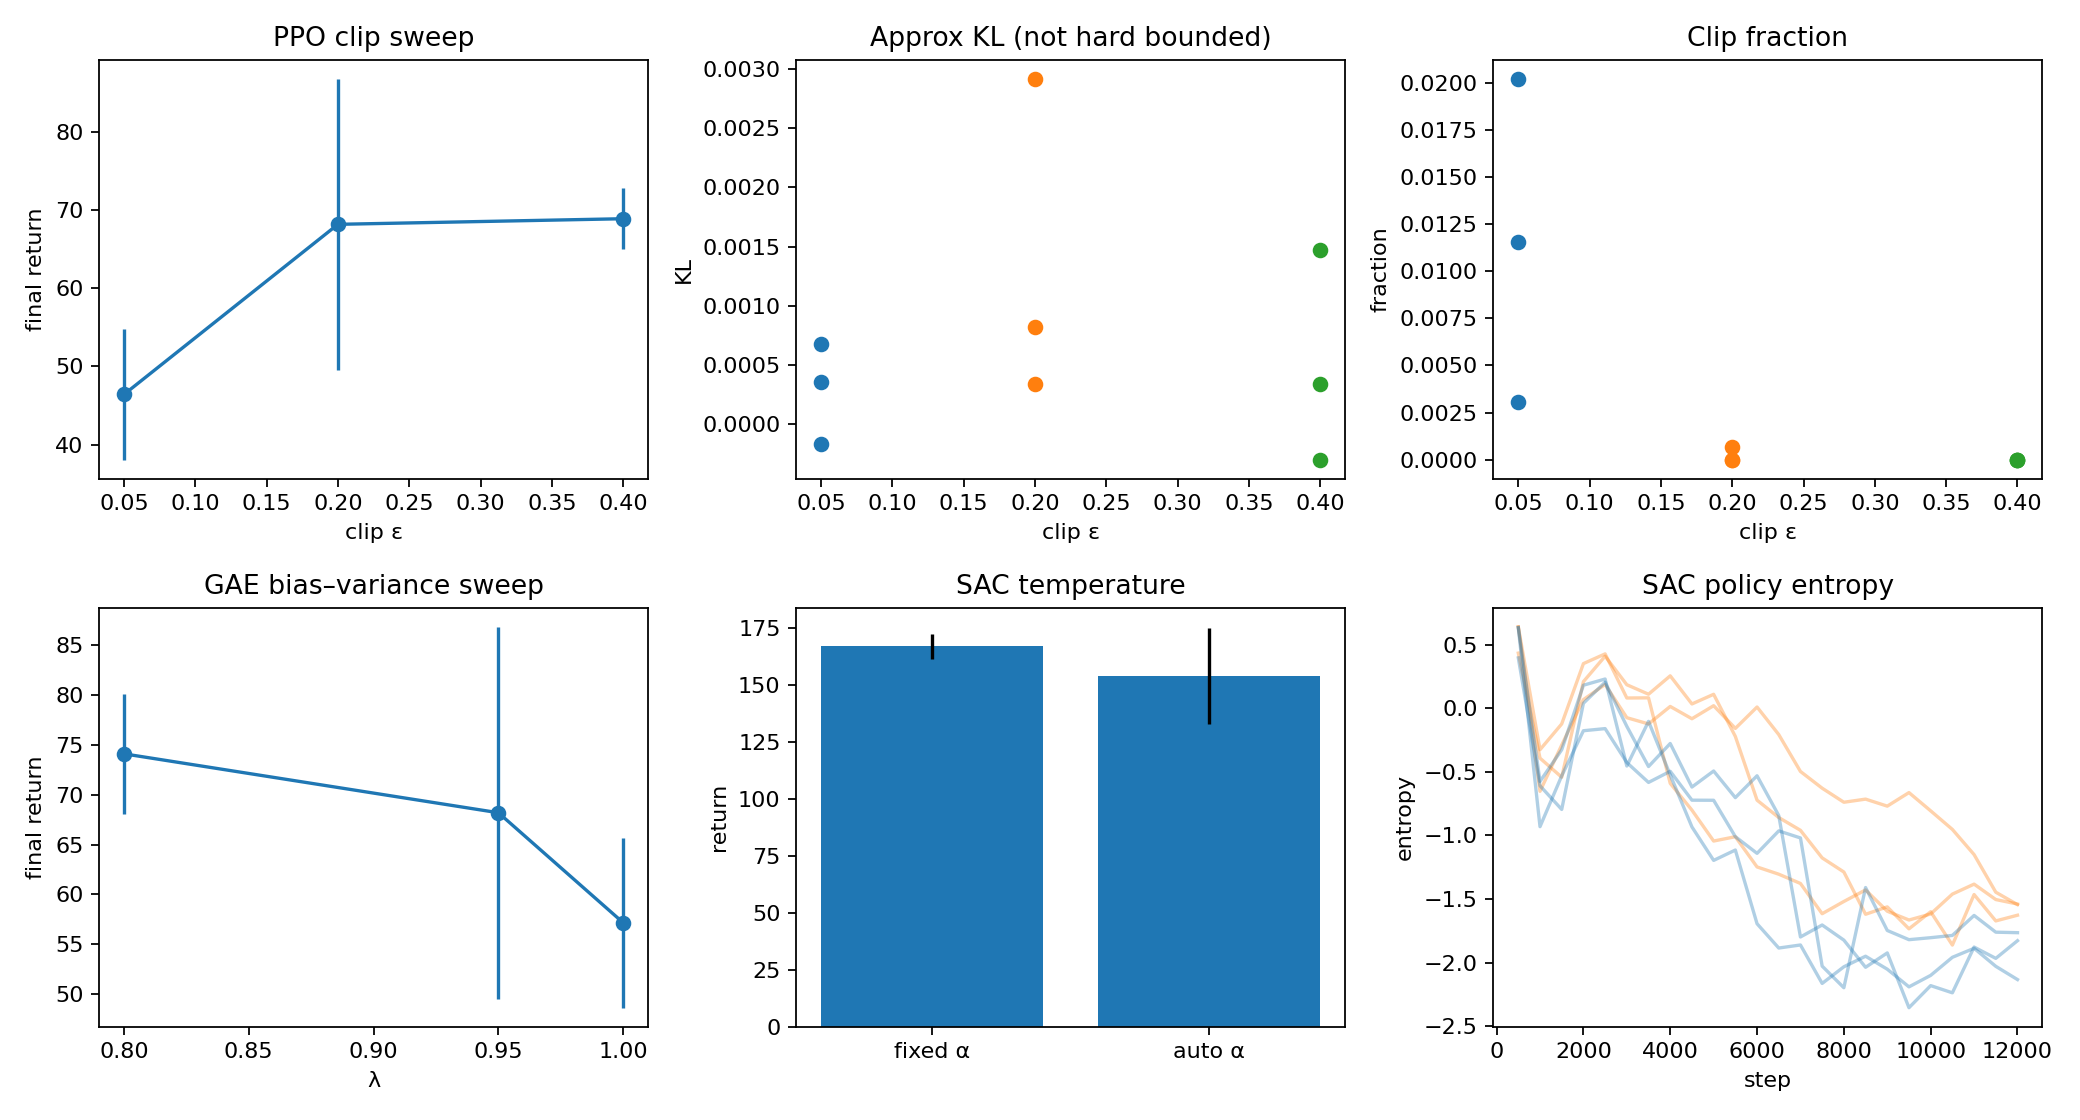
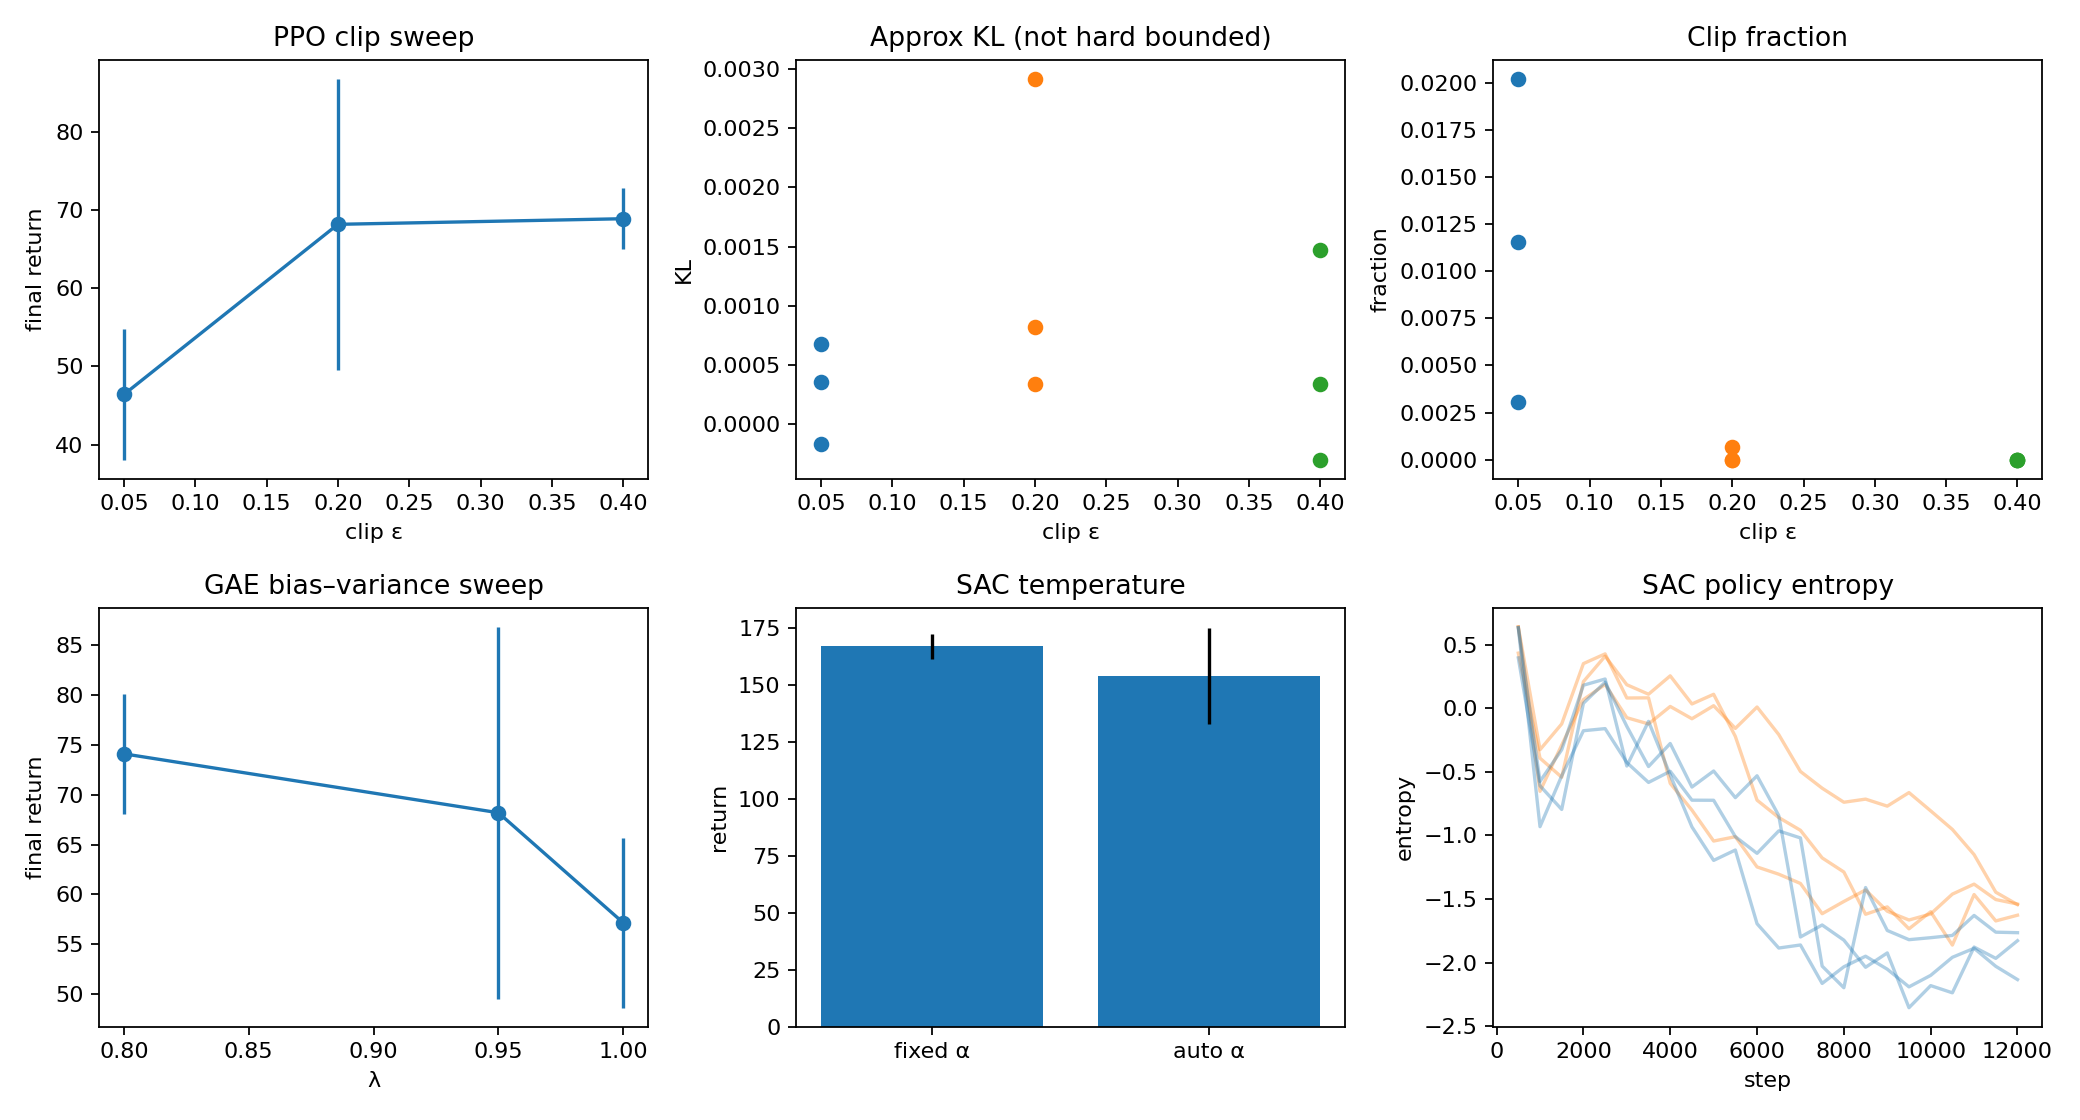
PPO 12k-step 的 clip 扫描最终回报为:ε=.05 46.42±8.35、.2 68.18±18.63、.4 68.90±3.91(mean±seed SD);GAE λ=.8 得到 74.08,优于 .95 的 68.18 和 1.0 的 57.17。SAC 固定 α=.2 为 166.86±5.62,自动温度为 154.00±21.08——自动温度在此预算下反而更差,是保留的负结果。
证据等级与复现契约
- 【B:受控小型实验】 每个主条件 seeds={0,1,2};误差条是跨 seed 样本 SD;JSON 同时给出对 seed 均值做 10,000 次 bootstrap 的 95% CI。n=3 时 CI 只能作描述,不能当高功效显著性检验。
- 平台:Python 3.13.5、PyTorch 2.9.0、CPU、OMP=1;PPO/SAC 各 12,000 environment steps。24 个 run 的训练合计约 3 分钟;首次导入与 H.264 渲染另有固定开销。
- 公开证据:本站保存的汇总数据、关键配置、汇总图与视频;正文只引用这些已发布材料。
- 100k-step 长预算演示与主比较分开:公开清单记录 last=263.35、best rolling return=396.8,仍未达到持续 500-step 的 solved 标准;它只展示较长平衡行为,不参与 12k 公平比较。
图 1:主实验汇总。柱/点为 3 seeds;曲线展示训练过程。
2. 环境与问题
| 环境 | 状态 / 动作 | 奖励与 horizon | 用途 |
|---|---|---|---|
| Local CartPole | / 左右二选一 | 存活每步 +1,最多 500 | PPO、clip/GAE 稳定性 |
| PointControl | / | ,到目标邻域 +2;100 步 | SAC 连续控制与温度 |
两个环境都在作业目录内原创实现,避免第三方环境版本/API 差异。CartPole 使用经典质量、杆长、20ms Euler 方程;PointControl 有速度衰减与动作限幅。后者是快速机制验证,不代表 MuJoCo 复杂接触控制。
3. PPO:目标、GAE 与实现
旧策略概率固定在采样时的 old_log_prob;更新阶段只改变新策略。比率 ,clipped surrogate 为
GAE 用 TD residual :
总 loss 是 。实现每 1024 步采样,8 epochs 全批更新,global grad norm clip=0.5,并记录 policy/value loss、entropy、approx-KL、clip fraction、grad norm。
(此处的实现代码或复现命令不在本站发布。)
4. SAC:双 Q、target 与温度
actor 是 tanh-squashed Gaussian,使用 reparameterization;log-prob 含 Jacobian 修正。两个独立 Q 用同一 Bellman target;target Q 以 τ=.01 Polyak 更新。自动温度的 target entropy=-1;固定组 α=.2。诊断记录 Q/actor/alpha loss、entropy、α 与两类梯度范数。
5. 实验设置与真实命令
(此处的实现代码或复现命令不在本站发布。)
| 项 | PPO | SAC |
|---|---|---|
| 预算 | 12k steps;长预算演示 100k | 12k steps;前 500 随机 |
| 网络 | actor/value 各 64×64 tanh | actor/Q 各 64×64 tanh |
| 优化器 | Adam 3e-4 | Adam 3e-4,batch 128 |
| 扫描 | ε={.05,.2,.4};λ={.8,.95,1} | fixed α=.2 vs auto α |
| 公平对照 | 共同协议 | 唯一变化 | demo 选择 |
|---|---|---|---|
| PPO clip .05/.2/.4 | 同 CartPole、12k steps、seeds 0/1/2、λ=.95 | clip ε | 三个 arm 均固定 seed 1,不按回报挑选 |
| SAC fixed/auto α | 同 PointControl、12k steps、seeds 0/1/2、replay/batch | temperature 更新 | 两个 arm 均固定 seed 1 |
| PPO 长预算能力演示 | 同实现,seed 11 | 100k 额外预算 | 展示较长平衡行为但未达到 solved 标准,不进入 12k 排名 |
禁止跨分支排名
PPO 与 SAC 使用不同状态、动作与 reward 尺度,只在各自任务内部比较。PPO 成功标准为 500-step horizon 内持续平衡,SAC 成功是接近目标并获得高 episode return;二者数字不可横比。
测试真实执行:4/4 passed,覆盖环境确定性、PPO ratio clipping、SAC 动作/log-prob 形状与 soft target update。
6. 实验 A:clip ε 与“非硬 trust region”
| ε | final return mean±SD | bootstrap 95% CI | Δ vs .05 | 证据 |
|---|---|---|---|---|
| .05 | 46.42±8.35 | [37.05, 53.10] | — | B;更新保守 |
| .20 | 68.18±18.63 | [50.60, 87.70] | +21.76 | B;seed 方差最大 |
| .40 | 68.90±3.91 | [64.40, 71.40] | +22.48 | B;本预算最稳定 |
为什么 clip 不是硬 trust region
目标只截断“能继续改善 surrogate 的样本贡献”,并不限制整个策略分布的 KL;同一 batch 多 epoch、共享参数和未被截断方向仍可移动概率。日志中 ε=.2 的 seed1 最终 approx-KL=0.00291,而 seed2 仅 0.00034;ε 并不映射到一个固定 KL 半径。TRPO 的约束优化才显式要求平均 KL≤δ。
7. 实验 B:GAE 的 bias–variance
| λ | 3-seed final returns | 均值 |
|---|---|---|
| .80 | 70.25 / 81.00 / 71.00 | 74.08 |
| .95 | 50.60 / 66.25 / 87.70 | 68.18 |
| 1.00 | 47.35 / 61.65 / 62.50 | 57.17 |
短预算和终止频繁的 CartPole 中,λ=.8 的 bootstrap bias 换来了较低方差,结果最好;λ=1 接近 Monte-Carlo,长轨迹噪声直接进入 actor。该结论依赖 horizon、value capacity 与训练预算,不应写成“λ 越小越好”。
8. 实验 C:SAC 自动温度 vs 固定 α
| 条件 | final return mean±SD | 95% bootstrap CI | Δ vs fixed | final α / 证据 |
|---|---|---|---|---|
| 固定 α=.2 | 166.86±5.62 | [161.73,172.87] | — | .200;B |
| 自动温度 | 154.00±21.08 | [133.79,175.84] | −12.86 | .088/.134/.120;B,负结果 |
自动 α 学到了更低温度,但 seed0 回报只有 133.79,拉高方差。解释是:简单单峰任务并不需要长期高熵,固定 .2 恰好给出足够探索;自动温度还多一个非平稳控制回路,12k 步未必收敛。不能据此否定 automatic entropy tuning,它在跨任务减少手调成本的价值没有被这个 toy task 测到。
9. 稳定性诊断面板怎么读
- return 与 loss 分开: policy loss 的绝对值不是 performance;value/Q loss 突增先查 target 尺度与终止 mask。
- KL + clip fraction: KL 持续抬升且 clip fraction 高,说明同一 batch 更新过猛;两者都接近 0 且 return 不动,更新可能过弱。
- entropy: PPO 过早塌缩会停止探索;SAC entropy 与 α 必须联读,α 下降是对 target entropy 的反馈,不等于训练失败。
- grad norm: 这里记录裁剪前 global norm;它能定位爆炸,却不能替代参数更新量或 optimizer state。
公开 PNG 只展示主比较;本页不引用未发布的诊断面板。
10. 方法对照 Demo:同 seed 行为差异
图 0:PPO clip 行为对照:三个视频均使用 seed 1;画面只用于展示可见行为,不用于核对 checkpoint、精确回报或成功率,数值比较以公开汇总数据和图 1 为准。
视频:ppo_clip0.05_seed1.mp4 视频:ppo_clip0.2_seed1.mp4 视频:ppo_clip0.4_seed1.mp4
图 0:SAC fixed α=.2(左)vs auto α(右)的行为对照:两个视频均使用 seed 1;画面只用于展示可见行为,三种子数值比较以公开汇总数据和图 1 为准。
视频:sac_fixed_seed1.mp4 视频:sac_auto_seed1.mp4
图 0:PPO 100k-step 长预算能力演示。视频展示较长平衡行为;公开清单记录 best rolling return=396.8、last=263.35,未达到持续 500-step 的 solved 标准,也不进入 12k clip 公平排名。
视频:ppo_cartpole_solved_seed11.mp4
11. 方法演进与适用边界
TRPO→PPO: TRPO 用二阶近似与 KL constraint 换可靠单调改进近似;PPO 用一阶 clipped surrogate 换实现简单和吞吐,但失去硬约束。在线、on-policy、动作维度中等且能并行采样时 PPO 是稳健基线,数据昂贵时样本复用弱。
MaxEnt RL→SAC: 最大熵目标把“高回报且多样”写入 Bellman backup;SAC 结合 off-policy replay、双 Q、stochastic actor 与 temperature。连续控制、数据复用重要时 SAC 合适;离散超大动作、强 model bias 或离线 distribution shift 需要别的设计。
12. 负结果、限制与反思
- 主 PPO 12k 与 100k-step 长预算演示均未达到持续 500-step 的 solved 标准;长预算演示只展示较长平衡行为,不把其数字混入消融。
- automatic α 没赢固定 α,且 CI 高度重叠;报告保留而非隐藏。
- n=3 足以暴露 seed 方差,不足以支持细小差异的显著性结论;bootstrap 不能凭空增加独立样本。
- CartPole 与 1-D PointControl 没有高维接触、延迟或部分可观测性;结论等级是“实现正确 + toy mechanism evidence”。
- 下一步应固定 wall-clock 扩到 10 seeds,并加入 target-KL early stop、observation normalization 与 Pendulum/MuJoCo 交叉环境。
Claim–Evidence 对照
| 结论 | 状态 | 证据 | 升级条件 |
|---|---|---|---|
| 在 12k-step、三种子 PPO clip 扫描中,clip ε=0.4 的最终回报均值高于 ε=0.05,且种子间标准差更小。 | 已验证 | 数据 ↗图片 ↗配置 ↗ | — |
| 在 12k-step、三种子 PPO GAE 扫描中,λ=0.8 的最终回报均值高于 λ=0.95 与 λ=1.0。 | 已验证 | 数据 ↗配置 ↗ | — |
| 在 12k-step、三种子 PointControl 实验中,固定 α=0.2 的 SAC 最终回报均值高于自动温度组。 | 已验证 | 数据 ↗图片 ↗配置 ↗ | — |
| PPO 与 SAC 的方法对照视频采用固定 seed 的对应实验轨迹,适合作为行为示例而非成功率估计。 | 已验证 | 视频 ↗视频 ↗视频 ↗视频 ↗视频 ↗数据 ↗ | — |
| 现有 12k-step PPO 主实验没有达到 500-step solved 标准;额外 100k-step 演示仅用于展示能力,不参与短预算排名。 | 已验证 | 数据 ↗视频 ↗数据 ↗ | — |
证据文件
10 个文件