Reward Model、Verifier、RLVR 与 Eval Science
本报告迁移自原课程材料,经 AI 事实核查未发现存疑项,未逐页人工审核;结论与证据请以页面列出的原始文件为准。
实验目标
一份真实运行的 CPU 缩放实验:把偏好拟合、可验证奖励、reward hacking、在线相对更新与统计评估放在同一条可审计证据链中。
实验设置
| 环境 | 见正文的环境与实验设置部分 |
|---|---|
| 随机种子 | 7、17、29 |
| 关键配置 | cpu.yamlqwen7b-not-run.yaml |
本报告迁移自 CS285 课程材料 [1]。
一份真实运行的 CPU 缩放实验:把偏好拟合、可验证奖励、reward hacking、在线相对更新与统计评估放在同一条可审计证据链中。
完成状态
3 seeds(7/17/29)的 CPU toy-policy 实验已有公开汇总结果;未下载或训练大模型。运行范围见 CPU 配置,汇总见 results.json。
项目入口
汇总结果 · CPU 配置 · demo 清单 · 扩展规划(NOT RUN)
1. 研究问题、声明边界与 evidence contract
目标不是证明 RLVR 提升了 LLM reasoning,而是隔离三个可验证机制:相对优势是否能把概率质量移向 verifier 接受的动作;proxy 与 truth 失配时是否出现 Goodhart;评估预算和统计协议如何改变结论。策略只有四个带语义动作:correct / hack / offby1 / zero。这种表示已经把“正确答案”编码进动作空间,因而完全不能衡量模型是否学会进位、组合泛化或自然语言推理。
禁止外推
本实验支持“优化器会利用奖励漏洞”,不支持“toy RLVR 可提升 7B 推理”。Tokenizer、长序列信用分配、模型容量、生成多样性、分布式 rollout、训练不稳定和真实代码 sandbox 均不存在。
Evidence contract:正文数值只使用本站公开的 汇总结果、配置、图和 demo 清单;运行状态只有 RUN_ON_CPU 或 NOT_RUN;BoN 单独记部署采样;hidden 不参与训练;报告不把点估计写成确定结论。
2. 可验证任务、偏好数据与拆分
每个任务是两位数加法,canonical 输出固定两位。公开配置记录每 seed 生成 80 train、40 hidden 和 16 contamination-audit task;汇总结果记录三种拆分互不重叠。偏好样本使用 strict correctness、weak acceptance 与固定长度三维特征,并比较干净标签和 15% label flip;本站未公开逐样本偏好数据,因此不报告其具体效用系数。
| 输入 / 动作 | 目标与 reward | 预算 / 成功标准 | scaled-task 边界 |
|---|---|---|---|
| 两位数加法 prompt;动作是 correct / hack / offby1 / zero 四类响应 | strict reward=canonical exact match;weak reward=错误首位规则 | 60 updates,group K=8;hidden strict pass@1 为成功指标 | 有限动作策略,无 tokenizer、CoT 或预训练 LLM |
污染控制
hidden 仅在最终评估读取;audit sentinel 不用于调参。这里只证明本地生成集合互斥,不代表完成了互联网语料去污染。
3. Bradley–Terry 偏好模型
BT 模型使用 ,最小化二元交叉熵。公开汇总结果显示:干净数据 loss 从 0.693 降至 0.235,agreement=1.000;15% 噪声下 loss 降至 0.513,agreement=0.849,正确特征权重从 4.03 缩至 1.98。
推导:为什么 reward 的加性尺度不可辨识?
对任意常数 ,
因此 pairwise likelihood 不能识别全局 offset。本实现的 constant feature 在差分 中恒为 0,实测 gradient norm=0;示例 score 加 7 后 pair probability 不变。若再允许 temperature 与 reward 同时缩放,还会出现乘性标定问题,必须用正则、anchor 或独立校准集约束。
4. Strict 与 intentionally weak verifier
Strict verifier 要求长度为 2、全数字且与 canonical answer 完全相等;weak verifier 则故意使用会接受错误响应的代理规则。逐条 hacking 轨迹未在本站公开,因此这里只报告 results.json 中的汇总负结果。
真实负例
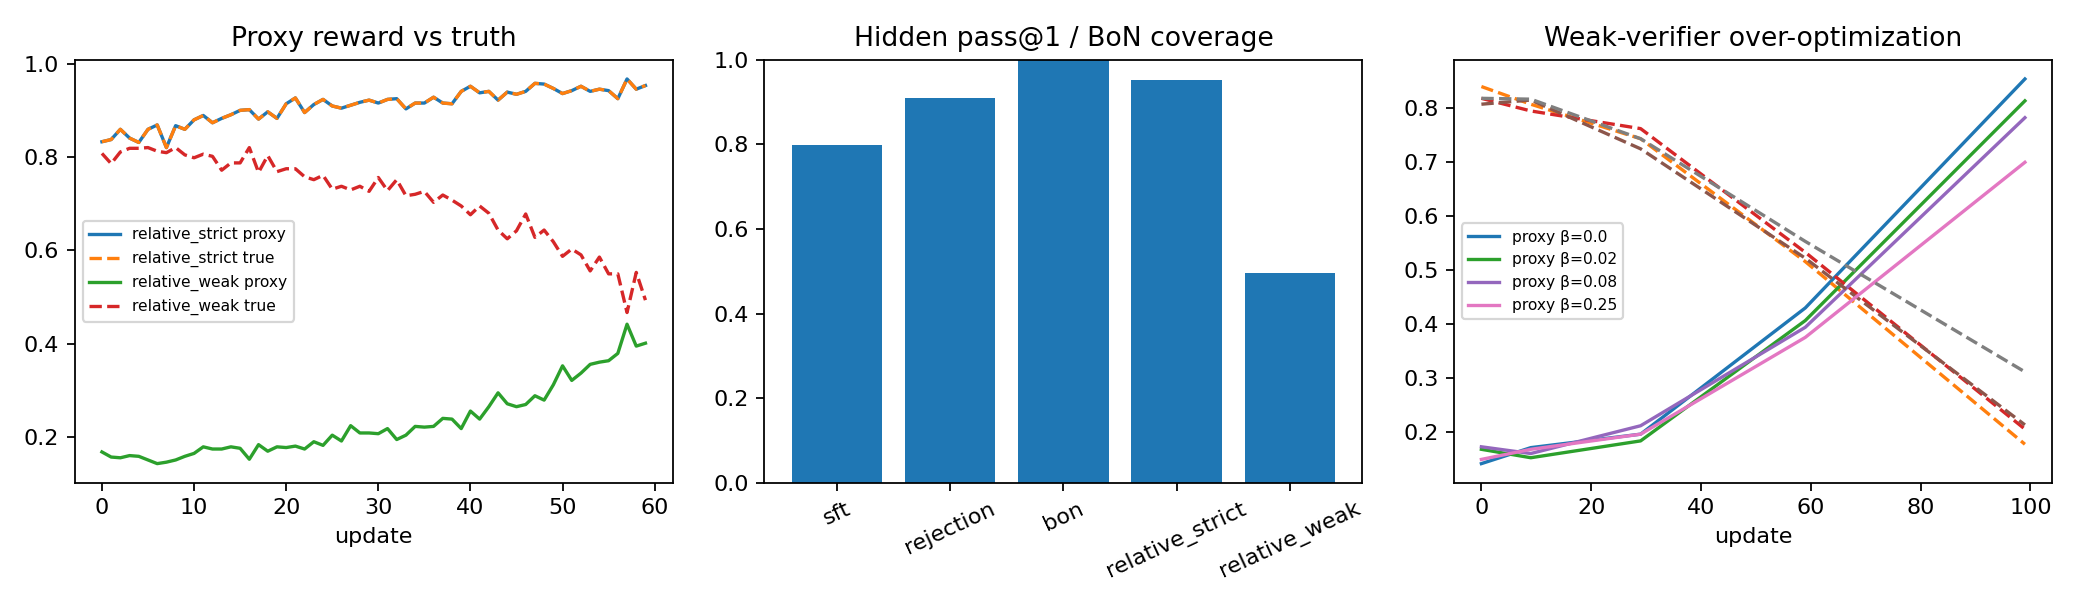
汇总结果中,weak-relative 的 hidden true pass@1 为 0.496;相对 SFT 的 paired delta 为 -0.303,95% bootstrap CI [-0.338,-0.269]。
5. SFT、Rejection、Best-of-N 与在线 relative RL
SFT 使用带噪动作标签做交叉熵;其具体噪声比例未在本站公开配置中登记,因此不作定量陈述。Rejection 每轮采样 ,仅用 strict accepted 样本再拟合。在线方法按 prompt 采样组,使用 GRPO-style 标准化优势:
Rejection 与每个 online run 均为 training rollouts。BoN 不训练,hidden 每题采 16 次并用 strict oracle 选择;它支付 16 倍部署采样,所以只能报告 coverage,不能与 pass@1 当作同预算能力比较。
| 方法 | 共同任务 / seed | 训练预算 | 唯一变化 / 混杂 |
|---|---|---|---|
| SFT | 同一生成器与 hidden split;7/17/29 | 80 supervised steps | 带噪动作标签,基线 |
| Strict rejection / RLVR | 同上 | 各 38,400 candidates | strict verifier;同采样预算 |
| Weak RLVR | 同上 | 38,400 candidates | 只替换 verifier,公平因果对照 |
| Best-of-16 | 同上 | 16×部署采样 | 不训练且读取 strict oracle;不与 pass@1 同成本排名 |
6. 真实运行结果
下表数值均来自公开的 results.json,实验预算见 cpu.yaml。
0.798SFT pass@1
CI [0.781,0.816]
0.910Rejection
CI [0.897,0.923]
0.953Strict relative
CI [0.943,0.962]
0.496Weak relative
CI [0.458,0.534]
| 方法 | pass@1 / coverage | paired Δ vs SFT | 95% CI | 成本 / 证据 |
|---|---|---|---|---|
| SFT | .798 | — | [.781,.816] | 1× sampling;B |
| Strict rejection | .910 | +.111 | [+.097,+.126] | 38,400 train candidates;B |
| Strict relative | .953 | +.154 | [+.137,+.171] | 38,400 train candidates;B |
| Weak relative | .496 | -.303 | [-.338,-.269] | 同 Strict RLVR 预算;B |
| BoN strict oracle coverage | 1.000 | 不比较 | [1,1] | 16×部署采样 + oracle;B |
图 1:由真实 CSV/JSON 生成的 proxy–truth、hidden 指标和 β 扫描。
7. Over-optimization:步数、β 与 proxy/true 分离
实验对 weak verifier 扫描更新步 1/10/30/60/100 与 。公开图与 demo 清单记录了固定 seed 7、 时 proxy 上升而 true accuracy 下降的趋势;其他扫描点未作为本站的逐点数据证据公开,因此不据此作更细的定量结论。
诊断原则
同时画 proxy、独立 truth、KL 和 entropy;只看训练 reward 无法区分能力提升、分布漂移和 verifier exploitation。
8. Pass@k、CI、paired comparison 与 grader agreement
pass@1 是全部 sampled strict correctness;pass@4/16 是每 task 前 k 个样本至少一个成功。配置记录 3 seeds、每 seed 40 个 hidden task 与 2,000 次 bootstrap;paired delta 对相同 seed/task 的方法结果先作差再重采样。样本量仍小,且当前 bootstrap 没有完整建模 seed 层级,结论应视作教学证据。
汇总结果记录 160 项 grader audit:strict–human agreement=0.975,weak–human=0.475,strict–weak=0.475。Human grader 由 seeded flip 模拟,只用于展示 agreement 流程,不能声称真实人类标注质量。
9. 方法对照 Demo:Strict 生成 vs Weak reward hacking
demo 清单保留了固定 seed、样本与扫描条件的选择规则,但本站未公开逐样本记录,因此删除迁移稿中的具体响应展示。可核实的总体结论是:该清单记录的 seed 7、 扫描中,proxy 从 0.141 上升至 0.855,而 strict truth 从 0.841 降至 0.177。
10. 复现、测试、artifact 与 CI
(此处的实现代码或复现命令不在本站发布。)
本站公开证据包括 results.json(汇总与区间)、cpu.yaml(预算与种子)、demo_manifest.json(demo 选择规则)和 PNG。这里“CI”指 confidence interval;本站没有公开仓库级 continuous integration 结果。
11. 局限、延伸与面试题
扩展规划明确标记为 NOT RUN;没有模型质量、吞吐、显存或 GPU 运行数字。真实扩展需 tokenizer-level generation、版本化 sandbox verifier、distributed rollout、prompt-cluster hierarchical CI 和严格去污染。
面试题
- 为什么 BT reward 不能识别 offset?如何校准跨模型 reward?
- BoN=1.0 为什么不等于 pass@1=1.0?
- GRPO 零方差组如何影响样本效率?
- 怎样设计隐藏 verifier 仍避免 reward hacking?
- paired bootstrap 的配对单位应是什么?
- 为什么 toy action semantics 构成强 inductive bias?
Claim–Evidence 对照
| 结论 | 状态 | 证据 | 升级条件 |
|---|---|---|---|
| 在该三种子 toy 实验中,干净偏好数据的 BT loss 从 0.693 降至 0.235,agreement 为 1.000;15% 标签翻转时最终 loss 为 0.513,agreement 为 0.849。 | 已验证 | 数据 ↗ | — |
| 在 60 次更新、每组 8 个样本的配置下,strict rejection 与 strict relative 的 hidden pass@1 均高于 SFT,三者分别为 0.910、0.953 与 0.798。 | 已验证 | 数据 ↗配置 ↗ | — |
| 相同 toy 任务中,weak relative 的 hidden true pass@1 为 0.496,相对 SFT 的 paired delta 为 -0.303,95% bootstrap CI 为 [-0.338, -0.269]。 | 已验证 | 数据 ↗ | — |
| 固定 seed 7、beta=0 的扫描中,proxy reward 随更新总体上升而 strict truth 下降,展示了该 weak verifier 下的优化失配。 | 已验证 | 数据 ↗图片 ↗ | — |
| 160 项模拟 grader audit 中,strict-human agreement 为 0.975,weak-human 与 strict-weak agreement 均为 0.475。 | 已验证 | 数据 ↗ | — |
| Qwen2.5-7B 规划未运行,不能据此给出模型质量、吞吐或资源结论。 | NOT RUN | 配置 ↗ | 按规划补齐 tokenizer 级生成、隔离 verifier 与分布式 rollout 后实际运行,并公开日志、指标和配置。 |
证据文件
5 个文件