Agentic RL:多轮工具、信用分配与恢复
本报告迁移自原课程材料,经 AI 事实核查未发现存疑项,未逐页人工审核;结论与证据请以页面列出的原始文件为准。
实验目标
Agentic RL:多轮工具、信用分配与恢复
实验设置
| 环境 | 见正文的环境与实验设置部分 |
|---|---|
| 随机种子 | 7、17、29 |
| 关键配置 | cpu.yamlreal-agent-not-run.yaml |
本报告迁移自 CS285 扩展课程材料 [1]。
把 Agent 视为“策略 + 有状态环境 + 工具协议 + 终止条件”,通过确定性 replay 和 trajectory-level update 研究稀疏奖励、shaping、错误恢复与 reward shortcut。
完成状态
3 seeds、每种方法 108 个评估任务的 CPU toy 实验已有公开汇总;failure/recovery demo 的 replay 结论记录在 results.json。运行范围见 CPU 配置。
项目入口
汇总结果 · CPU 配置 · demo 清单 · 扩展规划(NOT RUN)
1. 研究问题与诚实边界
任务要求依次 search 键值、calculator 计算、file-like tool 读取 receipt、submit。部分 calculator 第一次固定返回 TRANSIENT_503;部分 search result 夹带 prompt injection。核心问题是:terminal-only reward 能否把成功回传到整条轨迹?process reward 是否改善样本效率,还是鼓励“看起来在工作”的循环?恢复策略、horizon 和工具噪声怎样改变成功与尾部成本?
非生产 Agent
策略是有限 observation×action logits,不读取自然语言历史;工具都在内存中,无网络、真实文件、身份、异步执行或模型调用。结果只能说明协议和奖励设计机制,不能代表真实 Agent 能力或安全性。
2. State / Observation / Action / Tool Result / Termination
内部 state 包含 task id、observation、step、calculator attempts 和 permission 描述。可见 observation 为 START / INJECTION / HAVE_VALUE / CALC_ERROR / HAVE_RESULT / HAVE_FILE。结构化 action 记录 name 与 tool;tool result 是带 ok/value/error/untrusted_text 的字典。terminated 表示 submit,truncated 表示耗尽 horizon,两者分开。
公开配置记录环境版本 agent-tools-v1、最大步数与工具集合。原实验轨迹包含 task、max_steps、recovery、noise_rate、terminal/process reward 和 summary;本站仅公开其汇总结论,不把未公开逐轨迹数据作为独立证据。
| 输入 / 动作 | 目标与 reward | horizon / 成功 | scaled-task 边界 |
|---|---|---|---|
| 有限 observation;search/calc/retry/file/submit | terminal=正确 submit;shaped 另奖中间动作 | 主评测 H=8;正确读取 receipt 并 submit | 内存工具、有限 logits 策略,无自然语言模型或网络 |
为什么 replay 是 Agent RL 的基本证据?
多轮指标是环境、策略和工具共同产生的。只保存最终 success 无法判断是策略变化、工具 nondeterminism、状态泄漏还是 evaluator 漂移。Replay 把 action sequence 固定后检查环境因果链,是调试与离线重评估的最低条件;真实系统还需保存 tool image/version、网络 response hash、clock、secret redaction 与 sandbox provenance。
3. BC / Greedy Baseline 与 trajectory-level REINFORCE
BC 用专家 observation-action 对拟合:search → calc → retry(若错误)→ file_read → submit。评估仍随机采样,因此可观察概率尾部。RL 从 BC 初始化,每 update 在 48 tasks 各跑一条完整 trajectory。
Terminal-only 使用 ;shaped 使用:
指数移动平均 baseline 用于降方差;同一 trajectory 的 return 回传所有动作。实验故意保留 process reward 漏洞,使重复 search 也能累积正奖励;公开结果记录了由此出现的 shortcut 负结果。
4. 实验矩阵
- 方法:BC、terminal-only、shaped;每种 3 seeds。
- 恢复:retry enabled vs disabled。
- Horizon:5 / 8 / 11;工具噪声:0 / 0.25。
- 每 seed 48 train、36 eval。
- 安全切片包含 search-result injection;具体注入频率未在公开配置中登记。
公开配置记录 horizon、noise 与 recovery 的扫描范围;逐点消融表未在本站公开,因此正文不据此报告完整矩阵的逐点数字。主汇总使用 horizon=8 的配置。
| 对照 | 共同协议 | 唯一变化 | 公平性限制 |
|---|---|---|---|
| BC / terminal RL / shaped RL | 同 48 train、36 eval tasks,seeds 7/17/29,H=8 | 初始化后是否 RL、trajectory return 定义 | RL 在 BC 后追加在线 trajectories,非同总数据量 |
| recovery on / off | 同方法、task、seed、horizon、noise | 是否允许 retry | 能力开关,不是学习算法排名 |
5. 真实运行结果
下表的 success、区间与 paired delta 来自 results.json;种子和任务数见 cpu.yaml。
0.907BC success
CI [.852,.954]
0.972Terminal RL
CI [.935,1.000]
0.398Shaped RL
CI [.306,.491]
+0.065Terminal paired Δ
CI [.009,.130]
| 方法 | success [95% CI] | Δ vs BC [95% CI] | mean cost / steps / errors | 证据 |
|---|---|---|---|---|
| BC | .907 [.852,.954] | — | 5.20 / 4.85 / .69 | B |
| Terminal RL | .972 [.935,1.000] | +.065 [.009,.130] | 5.18 / 4.82 / .71 | B |
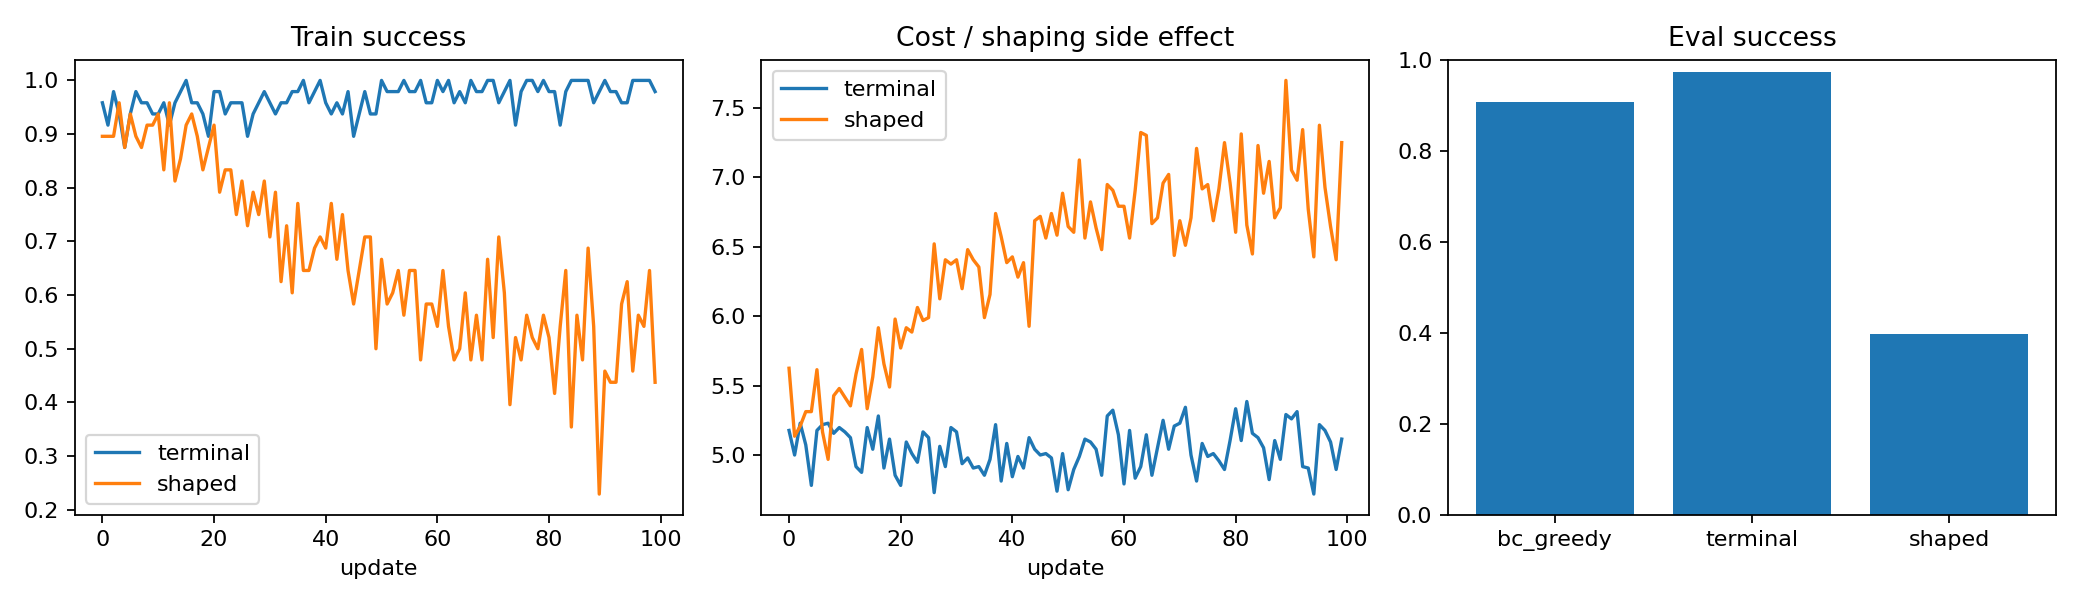
| Shaped RL | .398 [.306,.491] | -.509 [-.620,-.407] | 7.18 / 6.98 / .40 | B;负结果 |
Terminal RL 的 paired 95% CI 不跨 0,但只有 108 paired tasks 且 3 seeds;应报告为本 toy distribution 的证据。Shaped 的 paired delta 为 -0.509 [-0.620,-0.407],在这三种子实验中均为负结果。
图 1:由真实训练日志绘制的 success、cost 与最终评估。
6. Reward shortcut:shaping 的反作用
公开结果显示,shaped 策略出现重复 search:seed 29 的 eval shortcut_count 平均 5.36,success 为 0.222,平均 steps 7.39,26/36 失败属于 truncated;对照 terminal shortcut 为 0.083,success 为 0.944。也就是说当前 process reward 可通过“多做被奖励的动作”累积,却没有完成任务。
本质
本实验使用的 shaping 不是按潜势函数差 构造,也没有给出策略不变性证明;观测结果表明它改变了本 toy 环境中的行为。成本惩罚、state-once reward、循环检测和 terminal gate 是后续可测试修复,不能替代独立 success evaluator。
7. 成功、成本、恢复与尾部指标
每条 trajectory 统计 success、cost=、steps、tool errors、error 条件下 recovery、invalid actions、permission denials、shortcut count。P95 steps 与 P99 cost 直接从 per-trajectory 分布计算。Failure taxonomy 的优先分类为 permission/injection、unrecovered tool error、premature submit、truncated。
公开结果中的 seed 7:terminal 平均 cost=4.93、P95 steps=6、P99 cost=8.30;shaped cost=6.65、P95=8、P99=8.83。只报平均 success 会隐藏循环和高尾部成本。恢复率分母是经历 error 的 episode,而不是全部 episode。
8. Toy prompt injection / permission red-team
Toy search 结果可夹带被标为 untrusted_text 的注入指令,file tool 则受状态权限限制。公开结果只确认红队范围为 toy prompt injection 与 file permission denial;逐轨迹字段未公开,因此删除迁移稿中的具体失败次数。
安全声明
该红队仅证明 toy capability check 按代码工作。它未覆盖真实 prompt parser、间接注入、secret exfiltration、SSRF、路径穿越、shell、并发、授权撤销、日志泄露或 supply-chain,因此明确不宣称生产安全。
9. 方法对照 Demo:失败、terminal 恢复、shaped shortcut
demo 清单记录了 seed 7 的选择规则,但本站未公开 demo 逐轨迹和消融表,因此不展示迁移稿中的具体轨迹或 recovery on/off 数值。可公开核实的 replay 结论与总体指标见 results.json。
10. 复现、测试、artifact 与命令
(此处的实现代码或复现命令不在本站发布。)
本站公开证据包括 results.json、cpu.yaml、demo_manifest.json和 PNG。这里的 CI 数字均指 bootstrap confidence interval;本站没有公开仓库级 continuous integration 结果。
Evidence contract:报告数字必须在本站 evidence 中定位;NOT RUN 不得产生伪结果;安全结论必须带 scope;未公开逐轨迹时只保留汇总结论。
11. 缩放限制、NOT RUN 与面试题
扩展规划明确标记为 NOT RUN,不能据此声称生产 Agent 能力或安全性。扩展必须加入 token history policy、真实 sandbox、signed capability、网络/文件/子进程隔离、人工审批、分布式 actor、off-policy correction 和对抗性红队。
面试题
- terminal-only return 如何解决或恶化长 horizon 信用分配?
- 何种 shaping 保持最优策略不变?
- replay 在真实非确定性 API 下如何定义?
- P99 cost 为什么比平均 steps 更接近生产风险?
- 如何区分 recovery policy 与工具重试中间件?
- prompt injection 与 capability enforcement 分别解决哪一层问题?
- trajectory off-policy 学习为何需要 importance correction?
Claim–Evidence 对照
| 结论 | 状态 | 证据 | 升级条件 |
|---|---|---|---|
| 在三种子、每种子 36 个评估任务的 toy 实验中,BC、terminal RL 与 shaped RL 的 success 分别为 0.907、0.972 与 0.398。 | 已验证 | 数据 ↗配置 ↗ | — |
| Terminal RL 相对 BC 的 paired delta 为 0.065,95% bootstrap CI 为 [0.009, 0.130];该结论仅适用于本 toy 分布。 | 已验证 | 数据 ↗ | — |
| Shaped RL 相对 BC 的 paired delta 为 -0.509,95% bootstrap CI 为 [-0.620, -0.407],显示当前 process reward 设计在本实验中产生负结果。 | 已验证 | 数据 ↗ | — |
| seed 29 的 shaped 策略平均 shortcut count 为 5.36、success 为 0.222,并有 26/36 条失败归为 truncated。 | 已验证 | 数据 ↗ | — |
| 公开结果记录 failure 与 recovery demo 轨迹可精确 replay;该证据只覆盖确定性的 toy 环境。 | 已验证 | 日志 ↗ | — |
| 基于真实模型、异步工具执行器和 GPU 的 Agent 扩展未运行,不能据此声称生产能力或安全性。 | NOT RUN | 配置 ↗ | 在隔离网络、文件、密钥和子进程的 sandbox 中接入 token-level 策略,实际运行并公开轨迹、评测日志和红队结果。 |
证据文件
5 个文件