VLM Reasoning RL:答对、看对、以及 verifier 会不会被骗
本报告迁移自原课程材料,经 AI 事实核查未发现存疑项,未逐页人工审核;结论与证据请以页面列出的原始文件为准。
实验目标
本作业是独立于 portfolio lab 的完整五 Part 实现。
实验设置
| 环境 | 见正文的环境与实验设置部分 |
|---|---|
| 随机种子 | 0、1、2 |
| 关键配置 | cpu.jsoncounterfactual_protocol.jsonproduction_vlm_NOT_RUN.yaml |
本报告迁移自 CS285 扩展课程材料 [1]。
本作业是独立于 portfolio lab 的完整五 Part 实现。程序现场生成视觉题、训练带 answer/grounding 双头的小型视觉策略,再从同一 SFT checkpoint 出发执行三种 relative REINFORCE。核心不是把 toy CNN 包装成 VLM,而是用可控系统审计“答案奖励是否真的促成视觉依赖”。
项目入口
README / 代码目录 · tests · artifacts · demo manifest · 方法对照 demo
0. 结论与证据契约
一句话结论
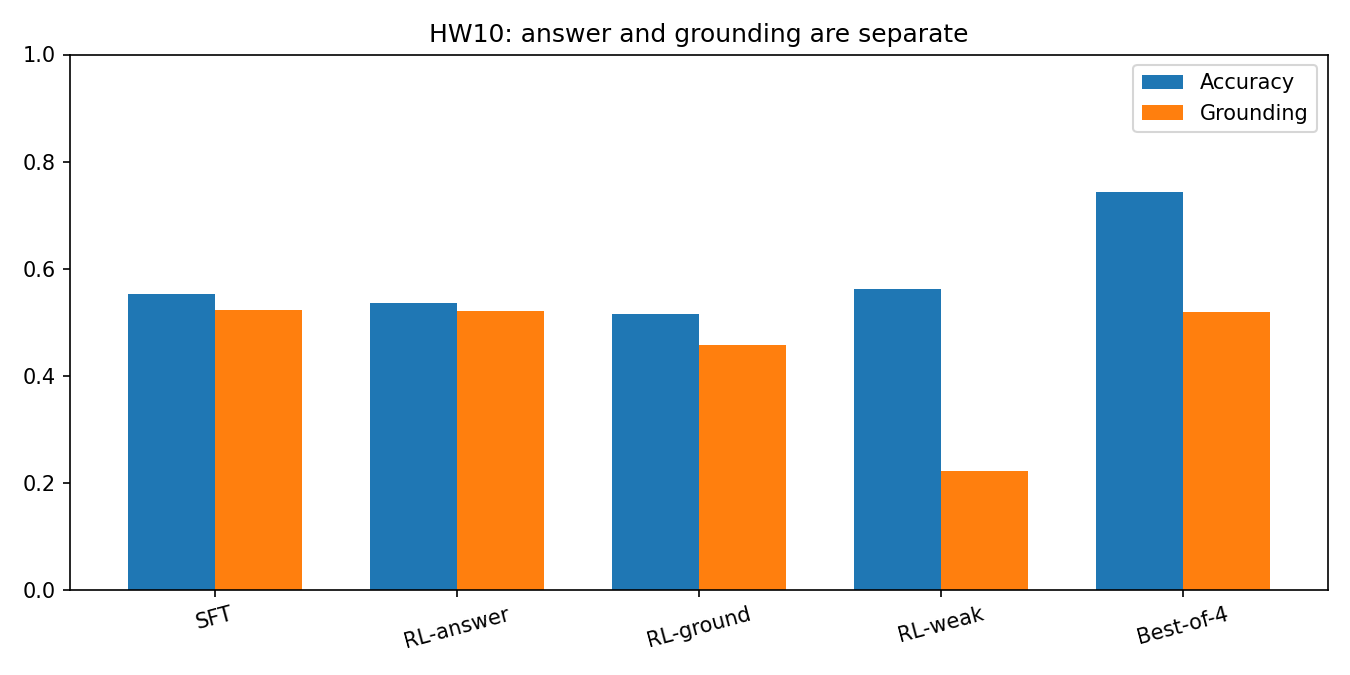
SFT 的隐藏集 accuracy / grounding accuracy 为 0.552 / 0.523;Best-of-4 把 accuracy 提到 0.743,但 grounding 几乎不变。故意弱 verifier 的 RL accuracy 为 0.563,grounding 却崩到 0.222,直接展示了“reward 上升不等于视觉证据更好”。
证据契约:哪些数字是真实运行,哪些不是
- 已执行: macOS arm64、Python 3.13.5、PyTorch 2.9.0、CPU;seed 0/1/2;训练 640 题,隐藏测试 192 题;当前公开 manifest 记录用时 14.62 s。
- 统计单位: 每个 seed 在同一 192-item hidden split 上评测;正文报三 seed 均值。raw summary 同时保存 df=2 的双侧 95% t-CI;小样本 CI 可能越过 [0,1],没有静默裁剪。
- 反事实: 同 item ID 配对,prompt、权重、解码固定;swap 使用固定 offset=17。visual dependency 是敏感性诊断,不是“已识别人类因果推理”的证明。
- 未执行: 7B VLM、ChartQA/DocVQA、8×H100、生产 GRPO;配方明确标为 NOT RUN。
- 可审计入口:逐 seed 结果、汇总与 CI、训练曲线、反事实协议、运行 manifest。
1. Part 1:合成多任务数据与双目标 SFT
数据生成器覆盖四种任务,每题都是 32×32 RGB,并保存答案、证据框与 4×4 grounding cell。训练集使用矩形和浅色纯背景;hidden split 改为椭圆/条纹和偏蓝背景,避免只测像素记忆。
| 任务 | 答案空间 | 视觉证据 | grounding target |
|---|---|---|---|
| 颜色 | 红/绿/蓝/黄 → 0..3 | 单个着色物体 | 物体所在 cell + bbox |
| 位置 | 第 0..3 行 | 物体纵向位置 | 物体 cell |
| 计数 | 1..4 个编码为 0..3 | 多个散布圆点 | 第一个标注实例 |
| 简单图表 | 最高柱列 0..3 | 四列高度 | 最高柱顶部 cell + 整柱 bbox |
模型输入还含 question type one-hot,以及训练阶段与答案相关、hidden 阶段相关性降低的 shortcut token。这个有意的数据缺陷用于验证冲突标签测试能否暴露语言捷径。SFT 同时优化答案与 grounding 两个交叉熵目标:
构念限制
计数题只为一个实例提供 grounding,图表 cell 也只是整柱 bbox 的离散近似;因此 grounding accuracy 和 mean IoU 必须并列,不能把 cell 命中误称为完整实例级解释。
| 输入 / 动作 | 目标与 reward | horizon / 成功 | scaled-task 边界 |
|---|---|---|---|
| 32×32 RGB + task/shortcut token;动作是 4 类答案 + 16-cell grounding | answer-only / answer+ground / weak center-cell reward | SFT 10 epochs,RL 5 epochs×G=4;hidden answer 与 grounding 分开判定 | 小型 CNN 分类器,无 OCR、token generation 或预训练 VLM |
2. Part 2:answer-only、grounding-aware 与故意弱 verifier
| verifier | 奖励 | 刻意保留的漏洞 |
|---|---|---|
| answer-only | 答案猜对时,错误定位仍得满分 | |
| grounding-aware | 答案奖励与 grounding 奖励加权 | 离散 cell 不能完全代表 bbox 质量 |
| weak | 答案奖励加固定中心 cell 奖励 | 输出固定中心 cell 可套利 |
三种 verifier 在训练前定义:answer-only 忽略定位质量,weak verifier 奖励固定中心区域,grounding-aware 同时检查答案与定位。公开结果显示 weak 分支的答案与定位指标明显分离;本站未公开测试日志,因此不声称具体测试通过数量。
3. Part 3:SFT → 组内相对 REINFORCE
每个 从 answer 与 grounding 两个 Categorical head 各采样 个候选,用组均值作 baseline:
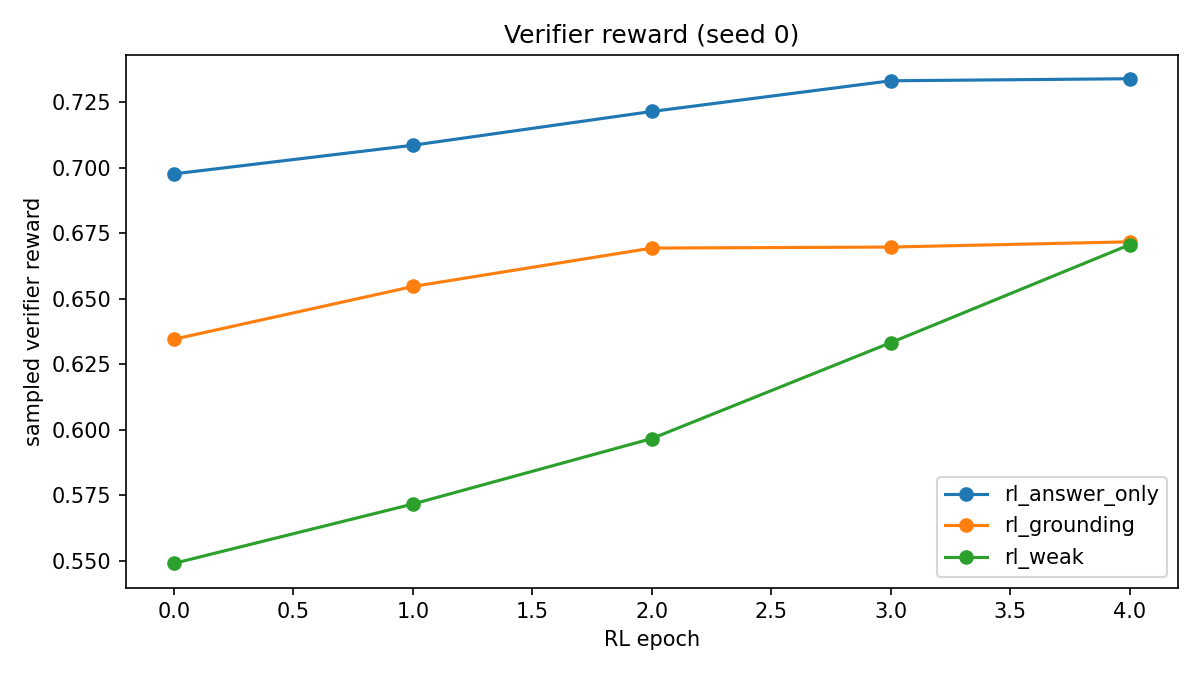
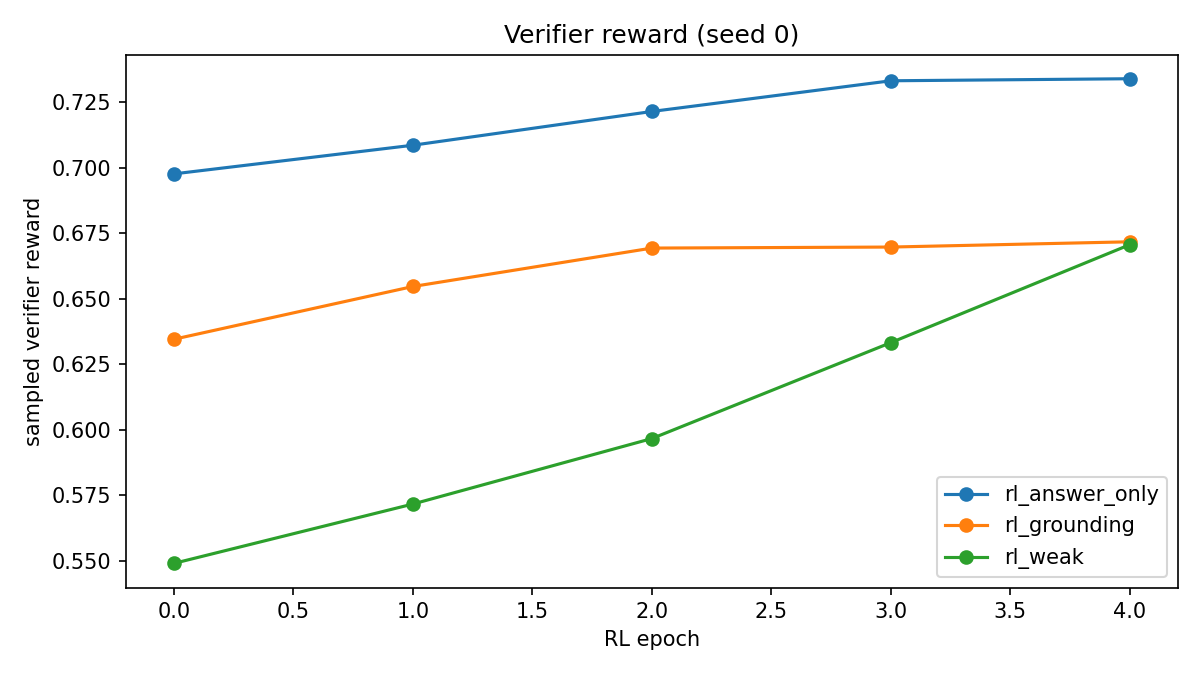
公开训练曲线记录每 epoch 的 sampled reward、answer+ground entropy、KL 和非零方差 effective-group rate。三种 verifier 使用相同的训练轮数、batch=64 与 group=4;未公开的优化细节不作为结论依据。
| 方法 | 共同数据 / seed / 预算 | 唯一变化 | 公平性限制 |
|---|---|---|---|
| SFT | 640 train / 192 hidden;seeds 0/1/2;相同 architecture | 双头监督基线 | 无 RL rollout |
| RL grounding-aware | 同 SFT checkpoint;5 epochs、G=4 | answer+ground reward | 与 weak RL 公平 |
| RL weak | 同上 | 固定中心 cell 可获额外奖励 | 预先定义漏洞 |
| Best-of-4 | 4×推理采样 | 真值 verifier 选样 | 部署成本和 oracle 信息不公平,不归因于训练 |
图 1:seed 0 的 sampled verifier reward;reward 只对对应 verifier 有意义,不能跨 verifier 直接排名。
Relative RL 的零梯度边界
若一个组全对或全错,组内优势全为 0;effective-group rate 因而比平均 reward 更能解释为什么某些题没有更新。高 reward 也可能只是 verifier 变得容易被固定输出攻击。
4. Part 4:五联反事实与 visual dependency score
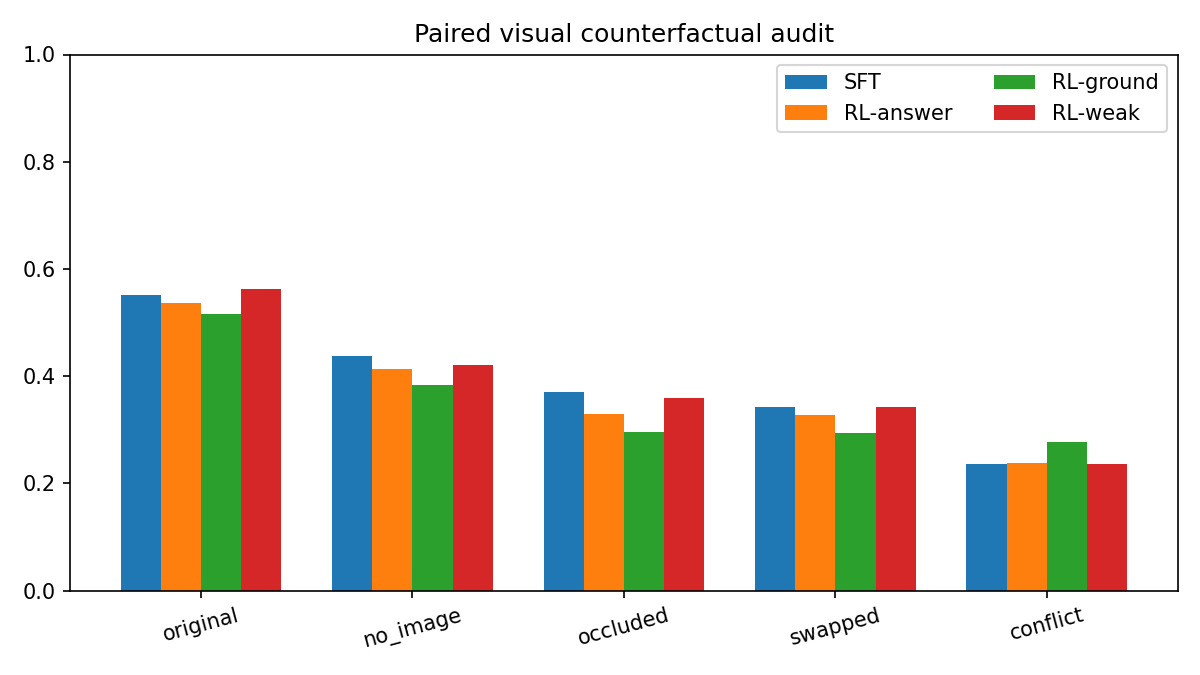
每个隐藏样本运行五个配对条件:原图、图像均值化、遮挡标注 bbox、换成固定配对的另一张图、保留图像但把 shortcut token 改成冲突答案;配对与交换偏移见公开协议。定义:
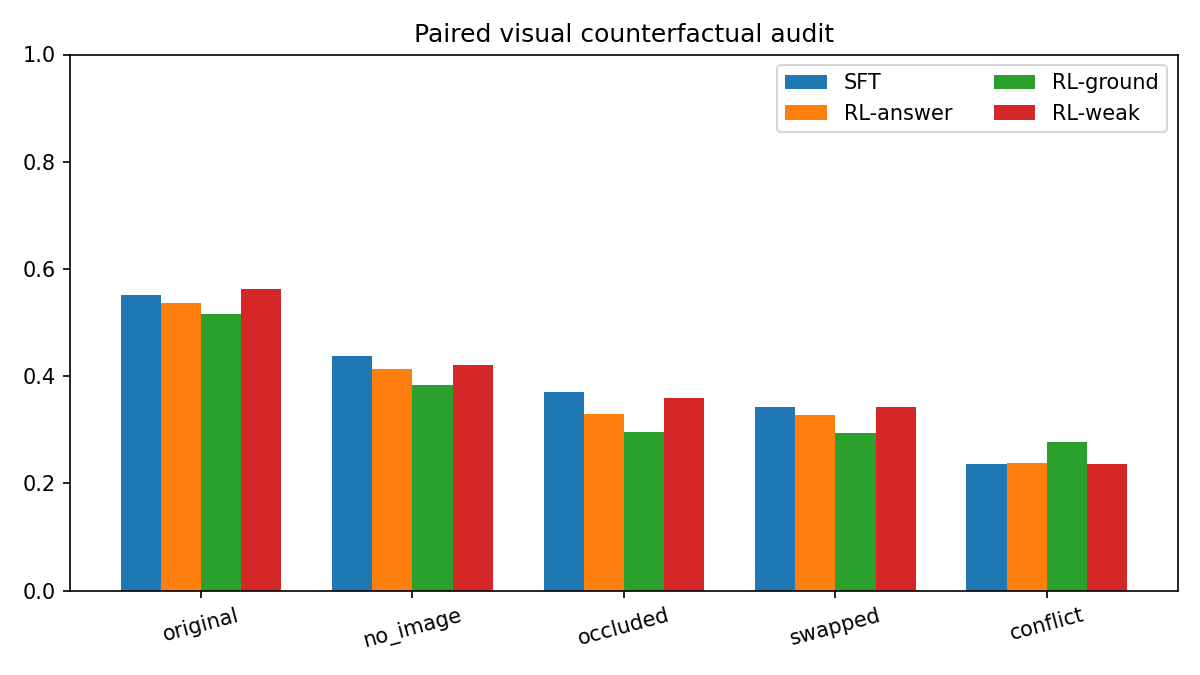
SFT 的五臂 accuracy 依次为 0.552 / 0.438 / 0.370 / 0.342 / 0.236,。冲突标签下降最大,说明模型确实学习了 shortcut;但原图相对去图和换图仍有明显增益,也说明它没有完全忽略像素。
图 2:反事实必须配对看。单独原图 accuracy 无法区分视觉读取与问题先验。
不能过度解释
遮挡会改变纹理,swap 也改变题型适配性,因而这些差值只是在既定 intervention 下的敏感性。它们是 shortcut audit,不是无条件的因果识别。
5. Part 5:Best-of-N 与同组采样预算
Best-of-4 从 SFT 分布采四组 answer/ground 候选,用 grounding-aware 真值 verifier 选择最高分;其采样数与 RL 的 group size 都为 4。它把 hidden accuracy 从 0.552 提到 0.743,但这是知道真值的 oracle selection,不能宣称与训练期 RL 在总算力、延迟或部署可用性上严格公平。正确用法是回答:“当前分布里是否已经有可被 verifier 找到的好样本?”
6. 三种子主结果与置信区间
| 方法 | Accuracy / Δ vs SFT | Ground acc. / Δ | Mean IoU | 证据 / 成本 | |
|---|---|---|---|---|---|
| SFT | 0.552 / — | 0.523 / — | 0.232 | 0.214 | B;1×推理 |
| RL answer-only | 0.536 / −.016 | 0.521 / −.002 | 0.231 | 0.210 | B;G=4 train |
| RL grounding-aware | 0.516 / −.036 | 0.457 / −.066 | 0.197 | 0.197 | B;G=4 train,负结果 |
| RL weak | 0.563 / +.011 | 0.222 / −.301 | 0.081 | 0.229 | B;同 RL 预算,hacking |
| Best-of-4 oracle | 0.743 / +.191 | 0.519 / −.004 | 0.227 | — | B;4×推理+oracle |
图 3:答案与 grounding 是两个指标;弱 verifier 正好展示二者可以反向变化。
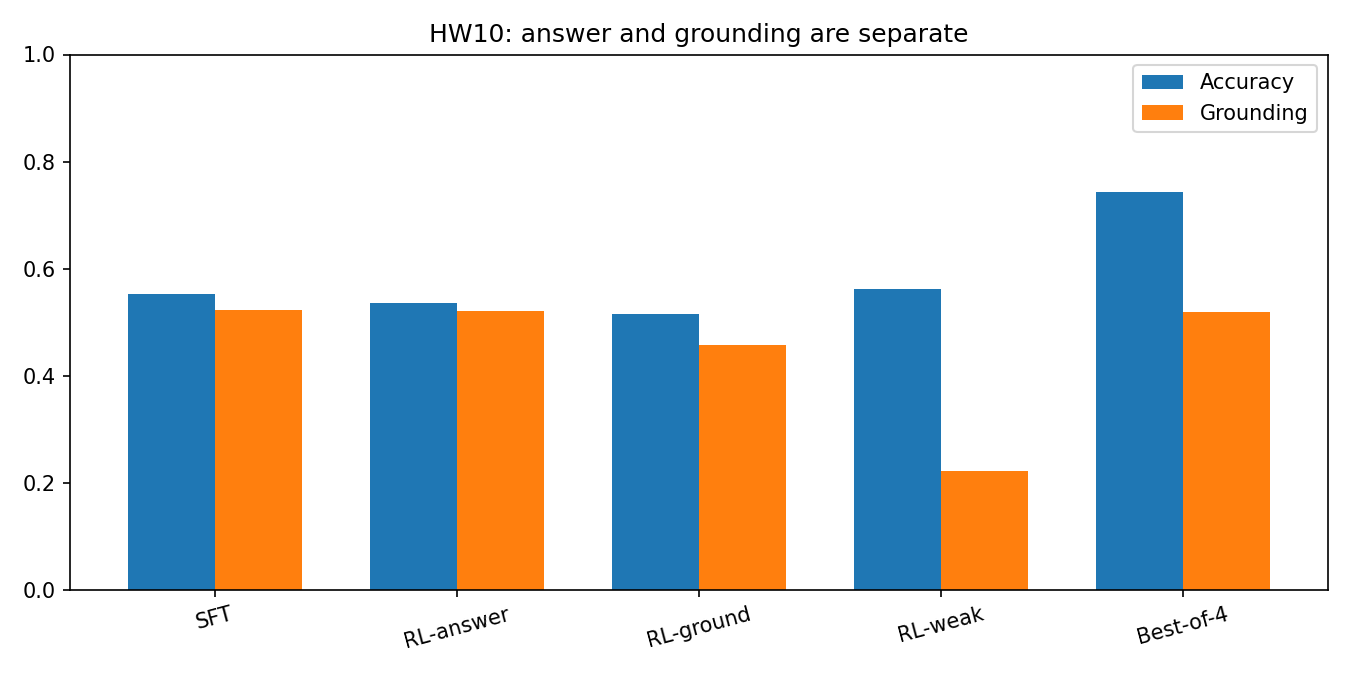
df=2 的 accuracy 95% t-CI:SFT [.500,.604]、answer-only [.389,.683]、grounding-aware [.258,.773]、weak [.540,.585]、Best-of-4 [.682,.804]。Grounding CI 更宽,SFT 的未截断区间甚至越过概率边界。这不是绘图错误,而是提醒:三个 seed 足以暴露方差,却不足以得到很窄的区间;所有区间保留在 summary.json,正文不把点估计差异写成显著性定理。
7. 方法对照 Demo:反事实、预测 grounding 与 weak 崩塌
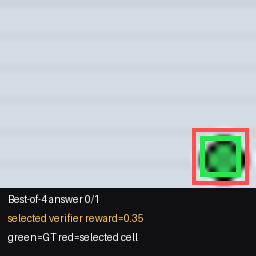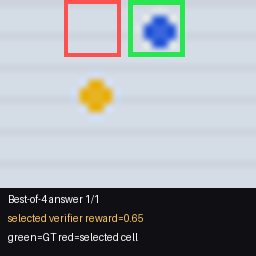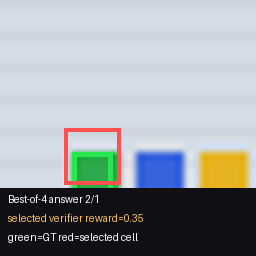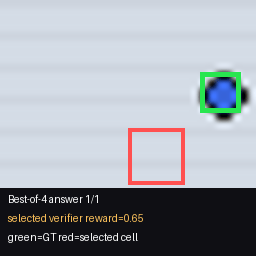
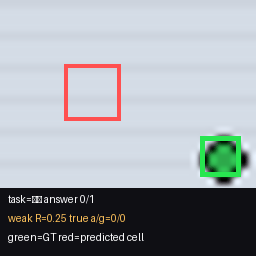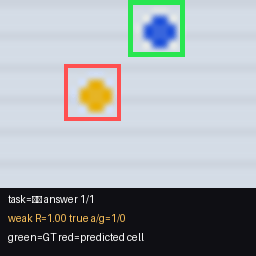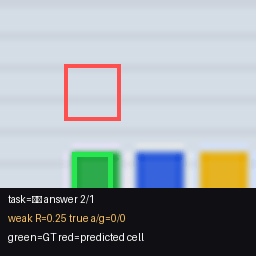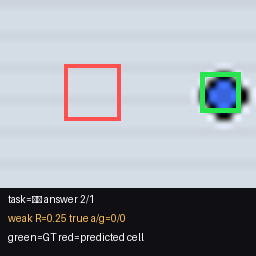
图 0:SFT baseline:seed 2 checkpoint,answer/grounding argmax。
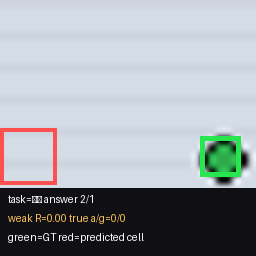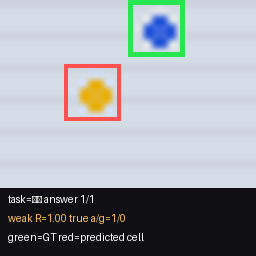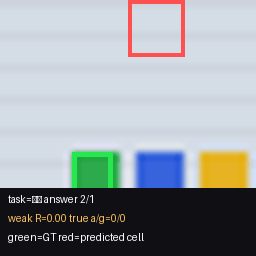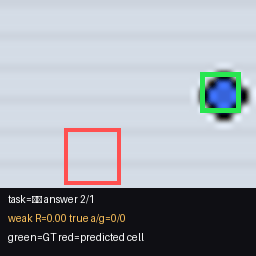
图 0:Grounding-aware RL:同 seed 2 / hidden items;真实 reward 与 answer/ground truth 叠加。
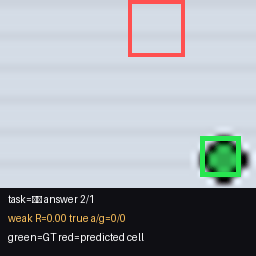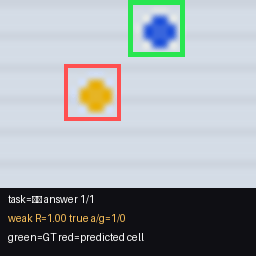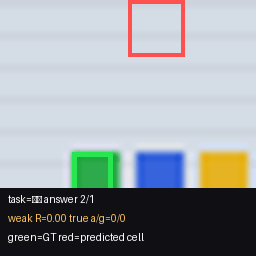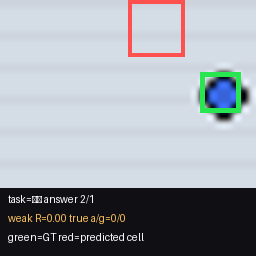
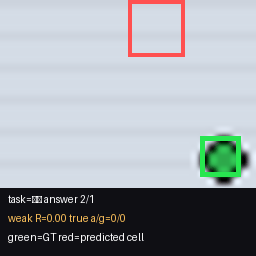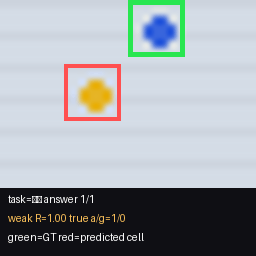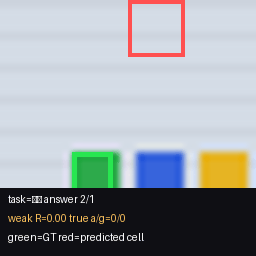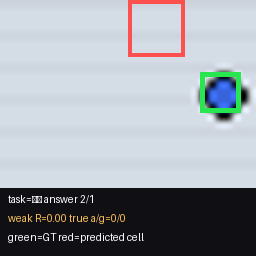
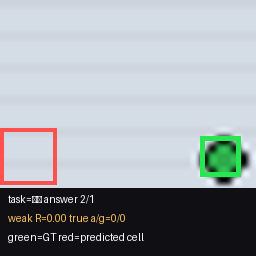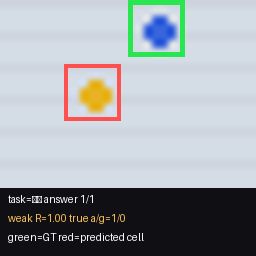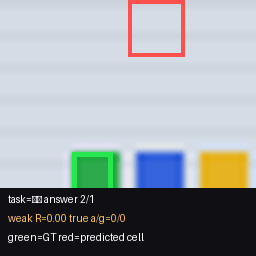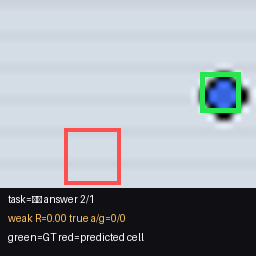
图 0:Weak RL:显示 weak reward 与 true answer/ground;总体 grounding=0.222、IoU=0.081。
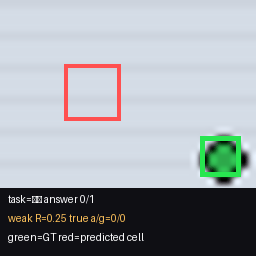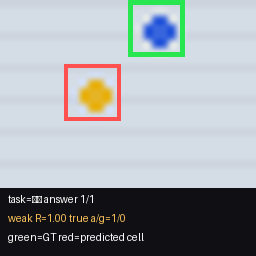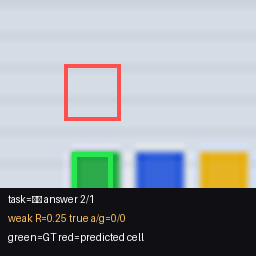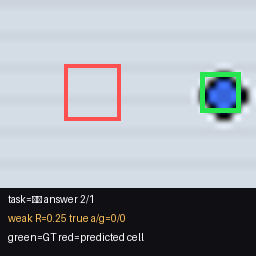
图 0:Best-of-4:seed 2 SFT 分布采四组,以 grounding-aware 真值 verifier 选样;显示额外采样成本。
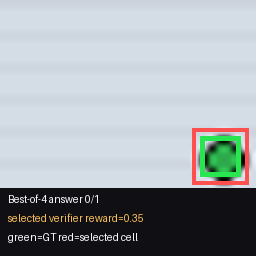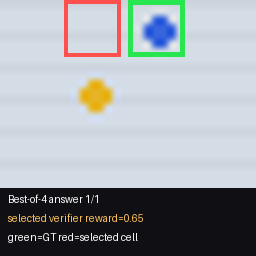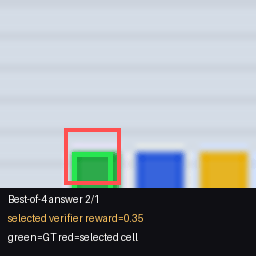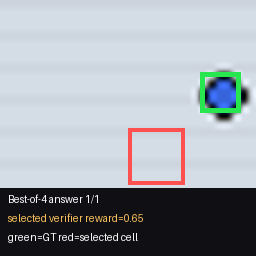
Demo 1:四臂都固定 seed 2 与 hidden item IDs 0/1/2/3/8/9,不按成功挑题;绿色为数据 bbox,红色为预测/选中 4×4 cell。Best-of-4 的抽样 RNG 固定为 seed 902。
图 0:Demo 2:同一 item ID 的 original / no-image / occluded / swapped / conflict 五臂真实评测,覆盖 SFT、answer-only、grounding-aware 与 weak RL;三 seed 汇总。
图 0:Demo 3:真实生成图片保持像素不变,只把 prompt shortcut 改成错误答案;SFT accuracy 0.552→0.236。行为差异说明模型依赖 shortcut,但 intervention 仍只是敏感性证据,不是一般因果定理。
保留的负结果
grounding-aware RL 没有超过 SFT;weak RL 甚至用轻微 accuracy 增益换来 grounding 大幅下降。报告不挑 seed、不删除失败方法,也不把 Best-of-4 的 oracle 收益归因于训练改进。
8. 工程结构、测试与复现
(此处的实现代码或复现命令不在本站发布。)
- 测试: 本站未公开测试日志,不据此声称测试通过数量。
- 配置:CPU config;生产 VLM NOT RUN。
- 公开证据: 逐 seed 结果、汇总、训练曲线、反事实协议、manifest、图与 GIF;模型 checkpoint 不在本站发布。
9. 与真实 VLM 的断裂
生产配方 · NOT RUN
生产实验需要预训练 7B VLM、动态分辨率、真实 ChartQA/DocVQA/grounded OCR、隐藏 verifier、8×H100、bf16 和至少三 seed。这里只保存了配置,不存在 checkpoint、日志或结果,因而不作任何生产性能声称。
- toy CNN 没有语言生成、视觉 token、OCR、长 CoT、工具调用或 pretrained prior。
- 四分类 answer head 与真实开放词表解码的 entropy/KL 不同。
- cell grounding 比 bbox/mask 简单,无法测试大框套利、多个实例和坐标格式攻击。
- 本实验能证伪“reward 提高必然代表看得更好”,不能证明某个大 VLM 配方会复现相同幅度。
10. 面试题与参考要点
Q1:为什么原图 accuracy 高不能证明模型看图?
因为问题模板、答案频率和 prompt token 可能足以预测答案;至少需要去图、换图、证据遮挡和冲突线索的配对干预。
Q2:为什么 grounding-aware reward 也会失败?
ground label 可能粗糙,权重可能失衡,组内样本可能零方差,策略还可能找到固定区域或格式漏洞;必须在隐藏反事实上审计。
Q3:Best-of-4 为什么不是免费性能提升?
它需要额外四倍采样和可在线使用的 verifier;本作业 verifier 读取真值,因此只是 oracle 上界。
Q4:三 seed CI 越过 [0,1] 怎么办?
线性 t-CI 没有概率边界。可同时保留原始区间并增加 bootstrap/logit interval;不能静默裁剪后假装不确定性更小。
Claim–Evidence 对照
| 结论 | 状态 | 证据 | 升级条件 |
|---|---|---|---|
| SFT 在隐藏集上的三种子平均答案准确率为 0.552,grounding accuracy 为 0.523。 | 已验证 | 数据 ↗数据 ↗ | — |
| 弱 verifier 训练后的答案准确率为 0.563,但 grounding accuracy 降至 0.222、mean IoU 降至 0.081。 | 已验证 | 数据 ↗图片 ↗ | — |
| 使用真值 verifier 的 Best-of-4 将答案准确率提高到 0.743,但这是 oracle 选择结果,不代表可部署训练收益。 | 已验证 | 数据 ↗视频 ↗ | — |
| 五臂配对反事实显示 SFT 对图像移除、遮挡、交换和冲突 shortcut 均有敏感性;该结果只支持既定干预下的敏感性解释。 | 已验证 | 配置 ↗数据 ↗图片 ↗ | — |
| grounding-aware RL 在本次三种子实验中没有超过 SFT,属于保留的负结果。 | 已验证 | 数据 ↗ | — |
| 7B VLM、公开 VQA/OCR 基准与多 GPU 生产配方尚未运行。 | NOT RUN | 配置 ↗ | 按公开配置准备预训练 VLM、公开数据集与多 GPU 环境,完成至少三个种子的训练和独立评测,并公开日志与汇总结果。 |
证据文件
16 个文件