CS285 HW2 实验报告:策略梯度、reward-to-go、baseline 与 GAE
本报告迁移自原课程材料,经 AI 事实核查未发现存疑项,未逐页人工审核;结论与证据请以页面列出的原始文件为准。
实验目标
HW2 的主线是策略梯度(policy gradient, PG):不再像 HW1 那样模仿专家,而是直接对期望回报 $J(\theta)=\mathbb{E}_{\tau\sim\pi_\theta}[\sum_t r_t]$ 求梯度并做梯度上升。核心公式就是模块 03 反复推导的那一条:
实验设置
| 环境 | 本作业在四个 Gym/MuJoCo 环境上验证策略梯度的各种降方差手段:一个离散控制的"玩具"环境 CartPole-v0,以及三个连续控制的 MuJoCo 环境 InvertedPendulum-v4、HalfCheetah-v4、Hopper-v4。下表逐环境列出状态空间、动作空间、奖励结构、时域上限(horizon)与任务目标——环境结构按所述 Gym/MuJoCo 版本说明;本机实测记录未公开。 |
|---|---|
| 随机种子 | 1 |
| 关键配置 | 无 |
本报告迁移自 CS285 课程材料 [1]。
本报告是模块 03(策略梯度)的动手配套:从 REINFORCE 出发,比较 reward-to-go、优势标准化、神经网络 baseline 与 GAE-λ。本站公开证据包括学习曲线与 rollout 视频;原始训练日志未随迁移公开,因此下文数字仅以这些公开证据为核查依据。
本报告要回答的问题
- batch size 到底如何影响策略梯度的方差与收敛?小批量为什么会”时好时坏”?
- reward-to-go 去掉与当前动作无关的过去奖励后,小批量 CartPole 曲线如何变化?
- 神经网络 baseline 什么时候帮忙、什么时候反而添乱?(HalfCheetah 上”只加 baseline 不加 RTG”为何最差?)
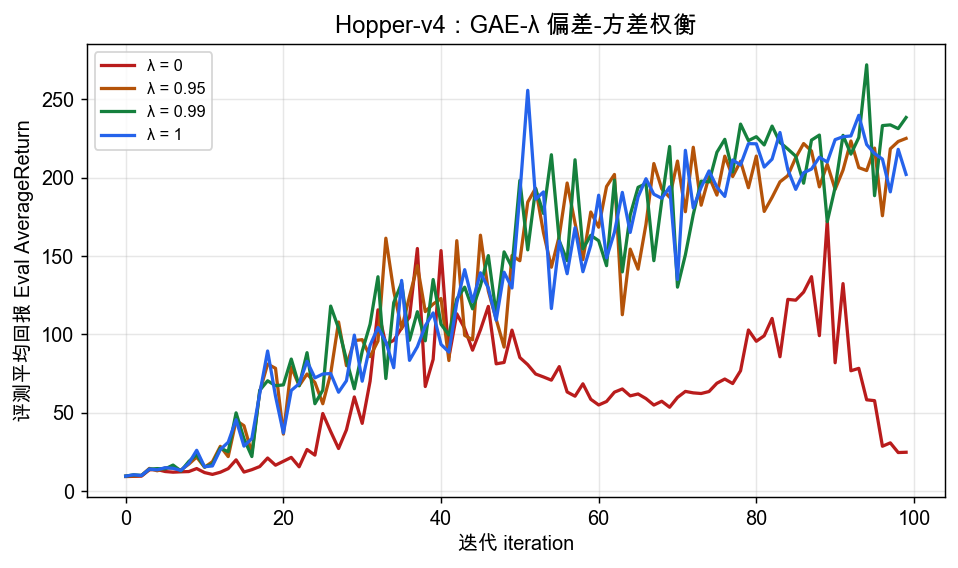
- GAE 的 从 0(纯自举)扫到 1(纯蒙特卡洛),偏差-方差权衡在 Hopper 上长什么样?
一句话结论
在 seed=1 的这些运行中,大批量 CartPole 的三条曲线均达到满分附近;小批量时 reward-to-go 曲线后期高于无 reward-to-go 曲线;HalfCheetah 中含 reward-to-go 的两条曲线后期更高;Hopper 中 的后期回报高于 。这些是单种子、缩减预算下的配置观察,不应外推为普遍排序。
证据口径 / 复现契约
- 环境: Python 3.9;gym 0.25.2;MuJoCo 2.2.0。
- 重复: 报告明确记录 seed=1,属于单种子观察。
- 预算: HalfCheetah 与 Hopper 使用缩减预算;完整配置未作为公开证据发布。
- 视频: 公开视频只用于核对可见行为,不用于支撑步数、回报、候选数量、checkpoint 时点或训练峰值。
【单种子趋势】【配置消融】【不可作普遍因果规律】
1. 作业目标与要求
HW2 的主线是策略梯度(policy gradient, PG):不再像 HW1 那样模仿专家,而是直接对期望回报 求梯度并做梯度上升。核心公式就是模块 03 反复推导的那一条:
其中 是对优势 的某种估计。整份作业就是在不断改进 的估计质量(降方差、控偏差),并观察它对训练的影响。需要自己补全的关键代码点:
| 文件 | 补全内容 | 标记 |
|---|---|---|
policies/MLP_policy.py | 策略前向分布、get_action 采样、PG loss()、baseline 回归 | TODO / from hw1 |
agents/pg_agent.py | Monte Carlo 的 Q 估计(轨迹回报 / reward-to-go)、优势估计(减 baseline / GAE / 标准化)、两个折扣求和 helper | TODO |
infrastructure/utils.py | 轨迹采样 sample_trajectory(ies)(从 hw1 迁移) | from hw1 |
infrastructure/rl_trainer.py | 训练主循环里的采样与 train_agent | from hw1 |
课程作业用多组实验考察各设计决策。本报告按公开曲线组织为四大块:
| 实验 | 环境 | 考察点 | 本次口径 |
|---|---|---|---|
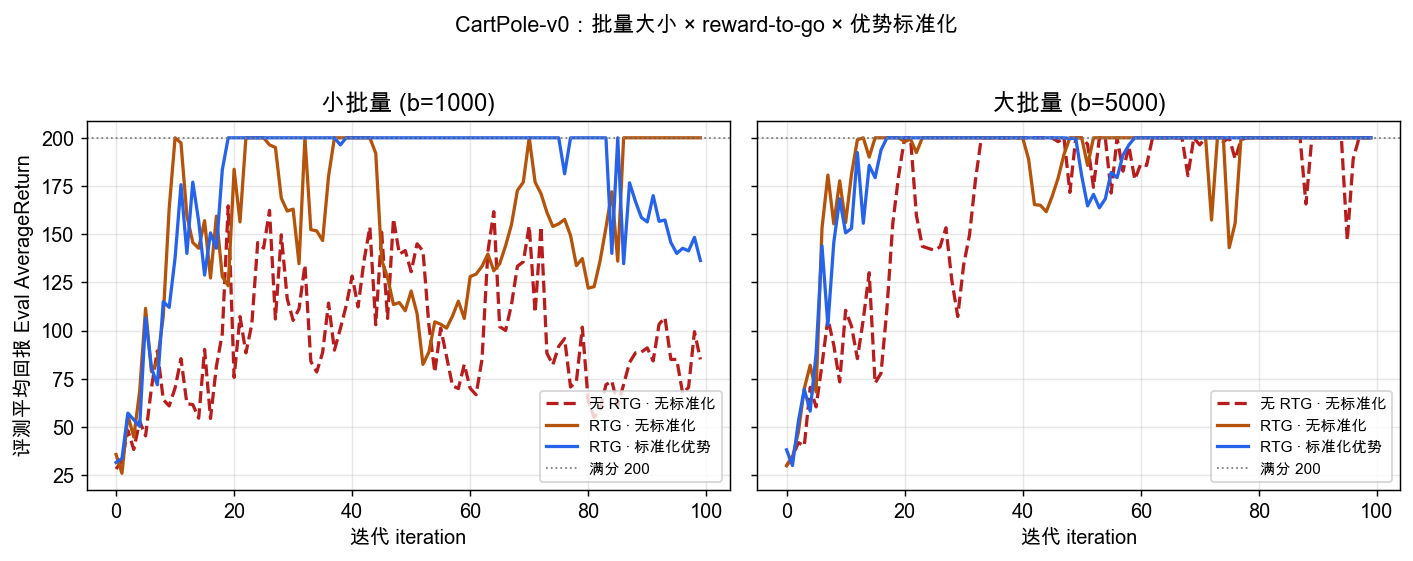
| Exp 1 | CartPole-v0(离散) | batch size × reward-to-go × 优势标准化 | 小批量与大批量配置比较 |
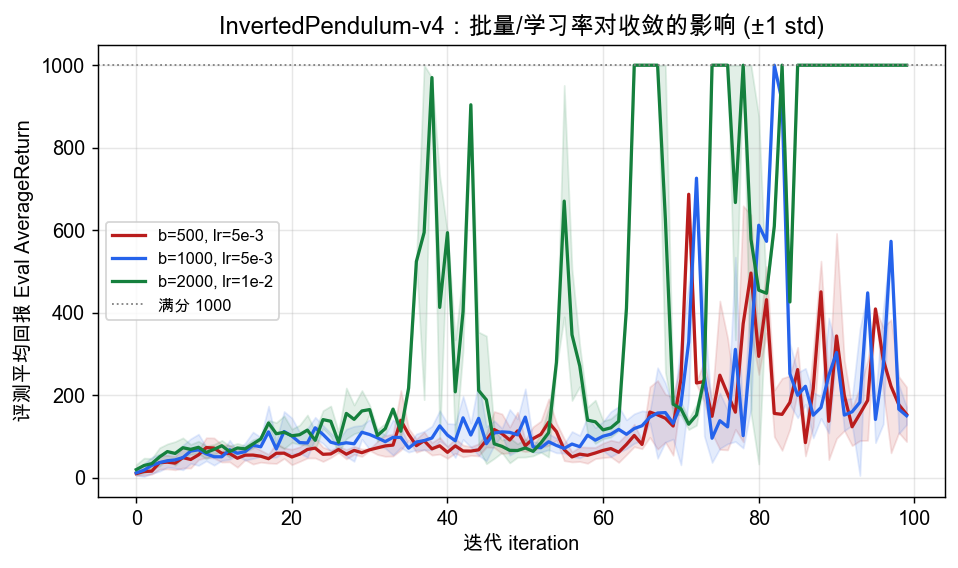
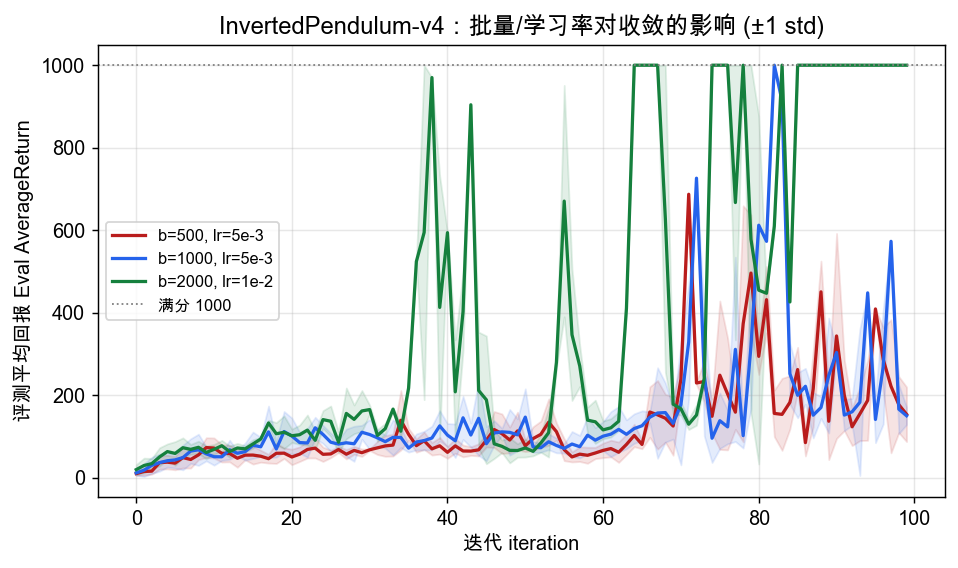
| Exp 2 | InvertedPendulum-v4(连续) | batch/lr 联合配置 | 三组联合配置比较 |
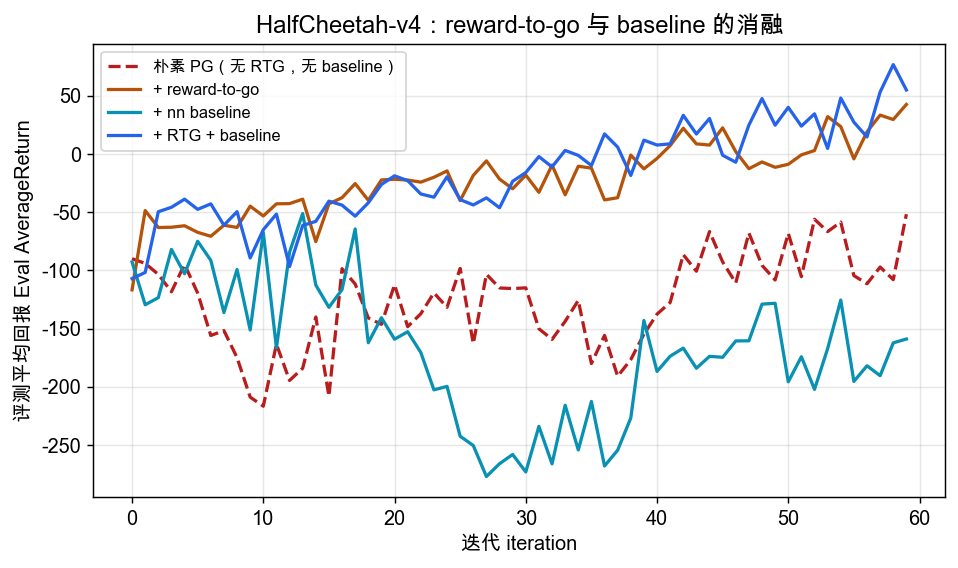
| Exp 3/4 | HalfCheetah-v4(连续) | reward-to-go × baseline 消融 | 缩减预算 |
| Exp 5 | Hopper-v4(连续) | GAE-λ 配置扫描 | 缩减预算 |
与课程实验的差异(诚实说明)
本次跳过 LunarLander,改用 HalfCheetah 的四配置比较观察 baseline;HalfCheetah 与 Hopper 使用缩减预算。完整配置和外部参考分数未作为公开证据发布,因此本页只对公开曲线中的相对趋势作单种子描述。
2. 环境与任务介绍
本作业在四个 Gym/MuJoCo 环境上验证策略梯度的各种降方差手段:一个离散控制的”玩具”环境 CartPole-v0,以及三个连续控制的 MuJoCo 环境 InvertedPendulum-v4、HalfCheetah-v4、Hopper-v4。下表逐环境列出状态空间、动作空间、奖励结构、时域上限(horizon)与任务目标;环境结构按所述 Gym/MuJoCo 版本说明,本机实测记录未公开。
| 环境 | 类型 | 状态空间 | 动作空间 | 奖励 | Horizon | 任务目标 |
|---|---|---|---|---|---|---|
CartPole-v0 | 离散 | 连续 小车位置/速度、杆角度/角速度 | 离散 2 类 Discrete(2):左推 / 右推 | 每步存活 +1 | 200 | 让杆尽量长时间保持竖直(满分 200) |
InvertedPendulum-v4 | 连续 | 连续 小车位置/速度、杆角度/角速度 | 连续 1 维 Box([-3,3]):水平推力 | 杆在阈值内每步 +1 | 1000 | 用力矩把倒立摆稳在竖直位(满分 1000) |
HalfCheetah-v4 | 连续 | 连续 关节角/角速度等(v4 默认不含 x 坐标) | 连续 6 维 Box([-1,1]^6):6 个关节力矩 | 前进速度奖励 − 控制(能耗)代价 | 1000 | 让”猎豹”尽快向前奔跑,跑得越快回报越高 |
Hopper-v4 | 连续 | 连续 关节角/角速度等(v4 默认不含 x 坐标) | 连续 3 维 Box([-1,1]^3):3 个关节力矩 | 存活奖励 + 前进奖励 − 控制代价 | 1000 | 单腿跳跃保持平衡并向前,不摔倒地跳得越远越好 |
读表要点:为什么选这四个环境?
- 难度递进: 从 4 维状态、2 类离散动作、200 步的
CartPole(几乎必解),到 17 维状态、6 维连续力矩、1000 步的HalfCheetah(高维连续控制)——状态/动作维度与 horizon 一路抬升,正好检验各降方差手段在不同难度下的表现。- 离散 vs 连续:
CartPole用Categorical策略,其余三个 MuJoCo 环境用对角高斯MultivariateNormal策略(见 §5.1),覆盖策略梯度的两种典型动作分布。- 奖励尺度差异大:
CartPole/InvertedPendulum是”每步 +1”的存活型稀疏奖励(回报 = 存活步数),而HalfCheetah/Hopper是”速度 − 能耗”的连续稠密奖励(可正可负)。这一尺度差异正是 §5.4 里”baseline 回归目标要先标准化”的现实动因。
在这四个环境上,本作业围绕如何改进优势估计 递进地考察五个技术点。§1 已按”环境 / 算力口径”组织过实验清单,这里换一个视角——按技术点说明每个实验各自”隔离”了什么变量、想回答什么问题:
| 技术点 | 做了什么 | 由哪个实验隔离考察 | 核心问题 |
|---|---|---|---|
| REINFORCE(朴素 PG) | 用全轨迹折扣回报当 ,梯度上升 | Exp1「无 RTG」基线、Exp4「朴素 PG」配置 | 不加任何降方差手段时能有多不稳? |
| reward-to-go | 只累加 时刻之后的奖励(因果性剪枝) | Exp1(CartPole 小/大批量对照)、Exp4(HC 有/无 RTG) | 删掉因果无关项能降多少方差?小批量下是否决定成败? |
| 优势标准化 | 把 归一化到零均值单位方差 | Exp1(-dsa vs 默认标准化) | 标准化对收敛与训练稳定性的影响? |
| neural baseline | 训练值网络 ,用 降方差 | Exp4(HalfCheetah 四配置 2×2 消融) | baseline 何时帮忙、何时添乱?与 RTG 的依赖关系? |
| GAE-λ | 用 在一步 TD 与蒙特卡洛间插值 | Exp5(Hopper 扫 ) | 偏差-方差权衡长什么样?甜点在哪? |
3. 环境搭建与踩坑
原型报告记录运行环境为 Python 3.9、Gym 0.25.2 与 MuJoCo 2.2.0;安装日志和本地代码路径未公开,因此不在本站列出具体报错、安装状态或修复命令。
4. 实验 setting
公开证据未包含完整训练配置或原始日志,因此本页不逐项列出无法公开核对的评测批量、训练预算和超参数。可核对的设置是所有实验使用 seed=1;曲线中的配置名称与 取值以公开图片图例为准。
5. 代码实现讲解
下面按数据流顺序讲解自己补全的关键代码(均为原创实现,未拷贝任何 solution repo)。
5.1 策略前向与训练采样
离散动作返回 Categorical(logits),连续动作返回 MultivariateNormal(mean_net(obs), diag(exp(logstd)))。在 on-policy 训练数据采集中按当前随机策略采样动作,保证数据来自用于梯度估计的策略分布;单独评测时既可采用随机协议,也可采用均值/众数等确定性协议,但必须明确并保持一致:
(此处的实现代码或复现命令不在本站发布。)
5.2 策略梯度损失(PG 核心一行)
要最大化 ,等价于最小化其相反数。优势 在上游已算好(减 baseline / GAE / 标准化都做完了),到这里就是一个 张量;用 mean 而非 sum,相当于把 batch size 折进学习率,训练更稳:
(此处的实现代码或复现命令不在本站发布。)
5.3 Monte Carlo 的 Q 估计:轨迹回报 vs reward-to-go
calculate_q_vals 有两种估计:不开 RTG 时,整条轨迹的每个时刻都填同一个”全轨迹折扣回报”;开 RTG 时,第 步只累加”从 到结束”的折扣回报(利用因果性,剪掉与 无关的过去奖励):
(此处的实现代码或复现命令不在本站发布。)
为何两种梯度写法都可无偏、但 RTG 更干净?
reward-to-go 是 的 MC 估计;含过去奖励的整轨总回报并不是该时刻 的数值估计,但过去项与当前 score 相乘后期望为零,因此仍可构成无偏的 score-function 梯度估计。区别在于:全轨迹回报把 之前的奖励也塞进了 ,而那些奖励与当前动作 因果无关,期望上贡献为零、方差上却是纯噪声。RTG 直接删掉这些项,估计更”干净”,方差更小——这就是模块 03 第 4 节”因果性 → reward-to-go”的落地。
5.4 优势估计:baseline、GAE-λ、标准化
estimate_advantage 按开关逐层处理。开了 nn_baseline 就查值网络 ;注意 baseline 是用”标准化后的 q_values”作回归目标训练的,所以它的预测处在零均值单位方差尺度,用作 baseline 前要”反标准化”回当前 batch 的 q 尺度:
(此处的实现代码或复现命令不在本站发布。)
GAE 的递推是 、。terminals[i]=1(该步是某条轨迹的最后一步)时用 nonterminal=0 同时”切断” 与 的跨轨迹累加——这是逐条轨迹独立做 GAE 的关键,也是把 rewards_list 保持”不拼接”传进来的原因。
为什么 baseline 目标要标准化?
直接让 回归原始 q(CartPole 里可能是 0~200,HalfCheetah 里几十到几百)会让回归目标量级漂移、不稳定。把目标标准化成零均值单位方差后, 只需拟合一个稳定尺度的信号;用时再反标准化对齐回来。这是工程稳定化。状态 baseline 的逼近误差通常不直接改变 score-function 梯度期望;但这里若使用 TD/GAE 自举或有限 batch 归一化,仍可能引入偏差。严格边界见 模块 03 权威表。
6. 结果(表格 + 曲线 + 视频)
【单种子趋势】【配置扫描】 这些曲线支持机制一致性,不证明 GAE/baseline 的普遍因果规律。
最终策略 rollout 视频
四段公开视频分别展示四个环境中的代表性策略行为。视频只用于定性观察,不公开或推断训练预算、选择过程、checkpoint 时点和精确回报。
6.1 Exp1 · CartPole:批量 × RTG × 标准化
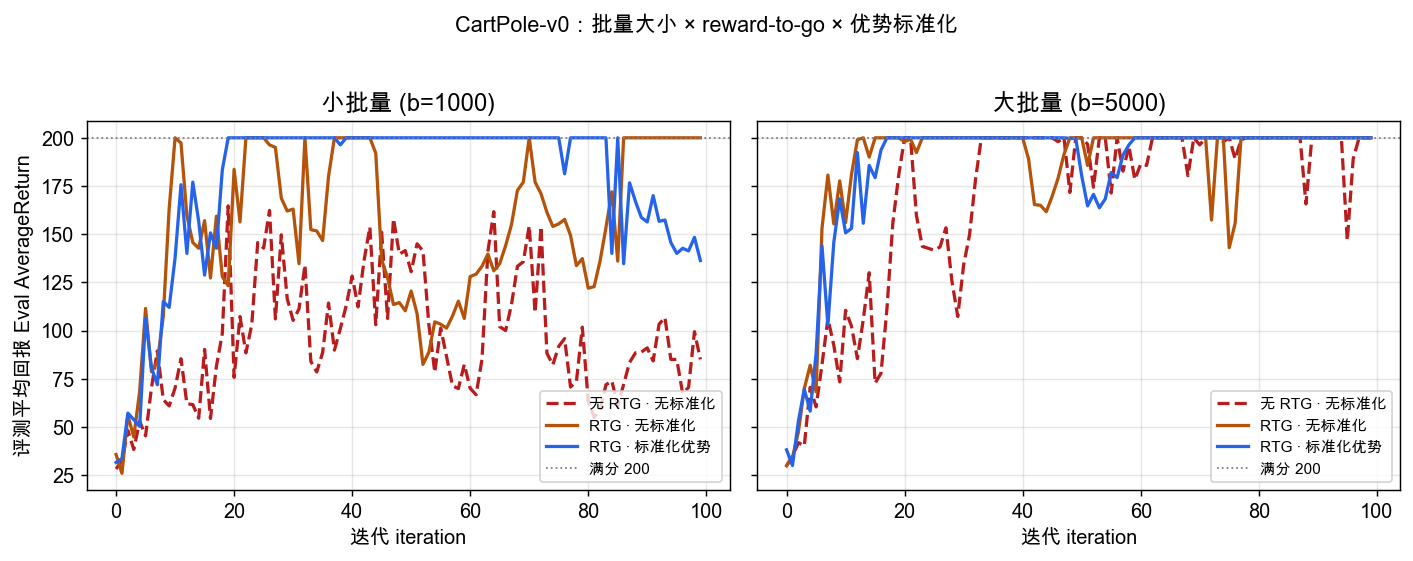
公开曲线显示:大批量面板中的三条曲线后期都在满分附近;小批量面板中,reward-to-go 曲线后期高于无 reward-to-go 曲线。
图 1:CartPole-v0 学习曲线。左侧小批量中无 RTG 曲线更低;右侧大批量中三条曲线后期都在满分附近。
读图要点
(1) 大批量面板的三条曲线后期都在满分附近。(2) 小批量中 RTG 曲线后期高于无 RTG 曲线。(3) 这是单种子联合配置比较,不能把差异直接归因为单个因素。
图 0:视频 1:CartPole-v0 代表性策略 rollout。视频中杆保持竖直,小车持续做左右调整。
6.2 Exp2 · InvertedPendulum:找到能稳定解决任务的 batch/lr
公开曲线显示三种 batch/lr 联合配置的结果不同:绿色曲线后期保持在满分附近,另外两条曲线更低且波动明显。由于 batch 与学习率同时变化,本实验不能拆分二者的独立作用。
图 2:InvertedPendulum-v4 三种联合配置的学习曲线。绿色曲线后期保持在满分附近。
读图要点
曲线的尖刺形态与高方差更新机制一致,但回报曲线没有直接测量梯度方差。绿色配置同时改变 batch 与学习率,不能分别归因。
图 0:视频 2:InvertedPendulum-v4 代表性策略 rollout。视频中倒立摆保持竖直,小车做小幅水平调整。
视频:inverted_pendulum_rollout.mp4
6.3 Exp4 · HalfCheetah:reward-to-go × baseline 消融
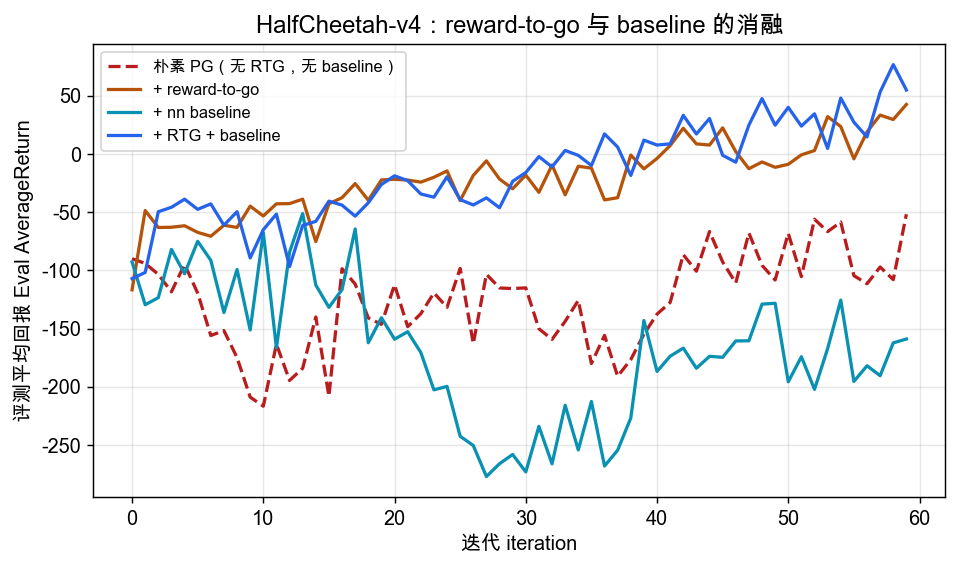
公开曲线比较有/无 RTG 与有/无 neural baseline 的四种配置。含 RTG 的两条曲线后期高于不含 RTG 的两条曲线;该结果是单种子、缩预算观察。
图 3:HalfCheetah-v4 消融。橙(+RTG)与蓝(+RTG+baseline)一路从 -100 爬到 +40~+55;红虚线(朴素 PG)在 -100~-150 徘徊;青色(只加 baseline、不加 RTG)反而一度跌到 -270,是四者最差。
为什么”只加 baseline 不加 RTG”反而最差?(关键现象)
本次配置中,含 RTG 的两条曲线后期更高。RTG 通常可移除与当前动作无关的过去奖励项,但本实验未直接测量梯度方差,也不能推出 baseline 普遍“必须先有 RTG”。
图 0:视频 3:HalfCheetah-v4 代表性策略 rollout。视频中可见策略持续向前移动。
6.4 Exp5 · Hopper:GAE-λ 偏差-方差权衡
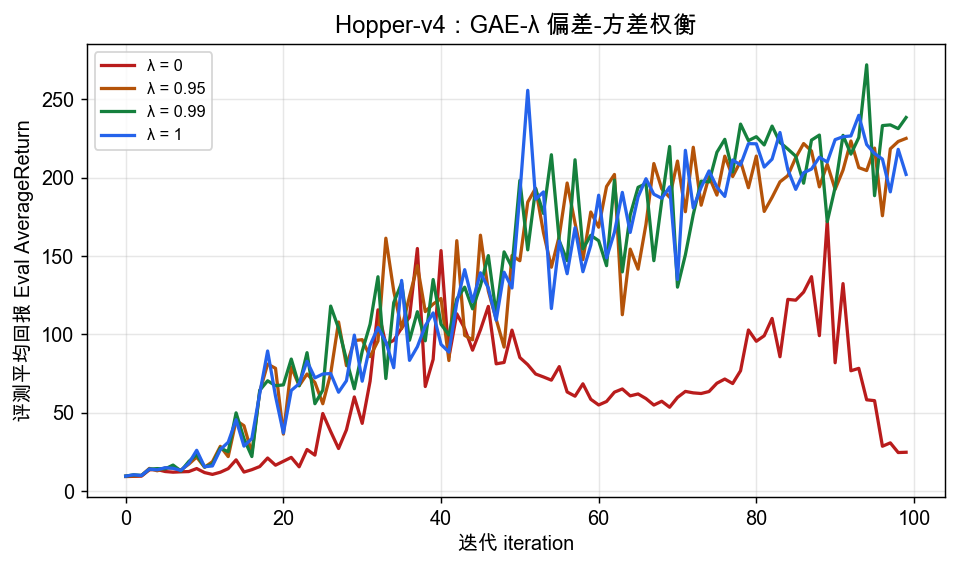
公开曲线比较 。 的后期回报高于 ;曲线没有直接测量梯度估计的偏差或方差。
图 4:Hopper-v4 GAE-λ 扫描。 后期较低,另外三条曲线后期较高。
读图要点
该单种子扫描与 GAE 的偏差—方差机制一致,但不足以单独证明 的较低回报由偏差造成,或 的曲线形态由梯度方差造成。
图 0:视频 4:Hopper-v4 代表性策略 rollout。视频中可见策略连续起跳并向前推进,随后失稳。
6.5 训练损失监控(Training_Loss)
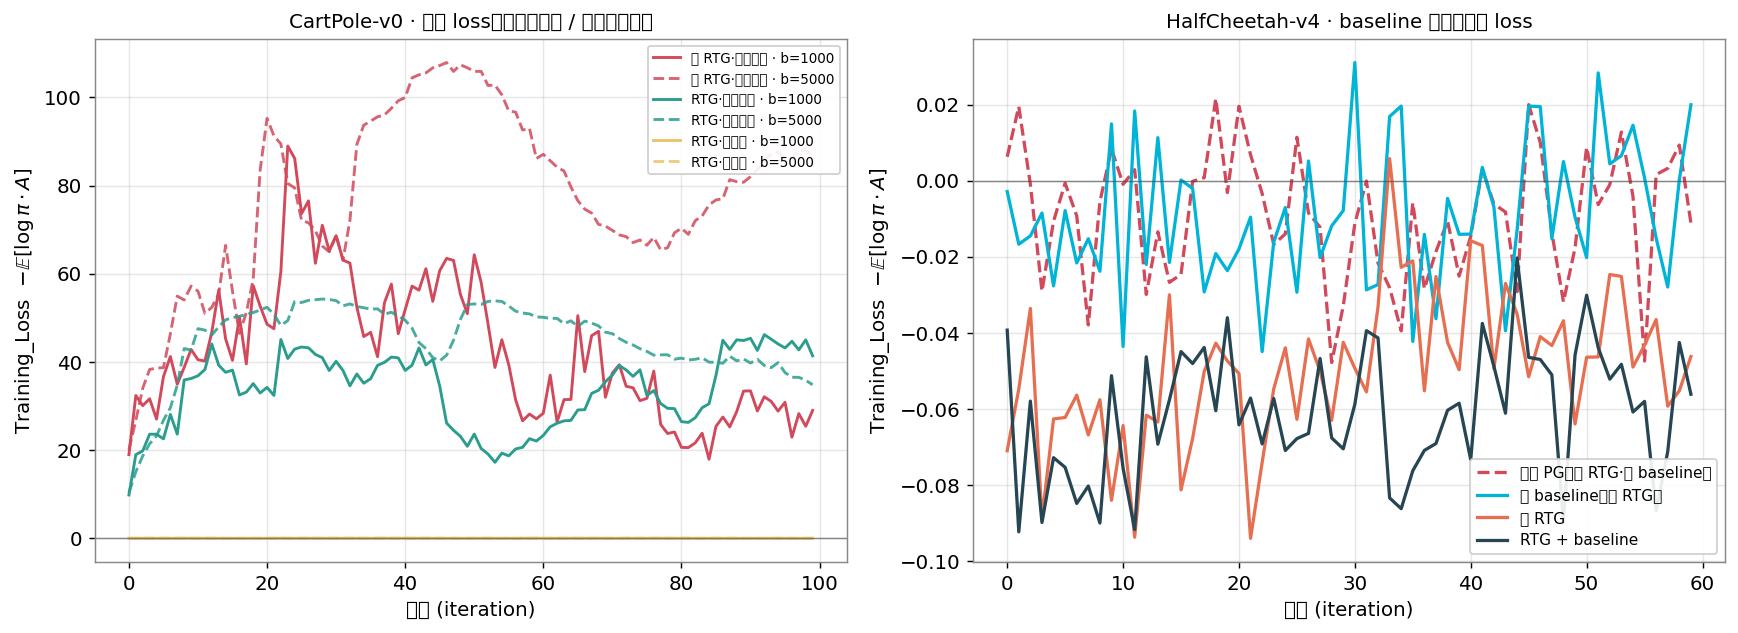
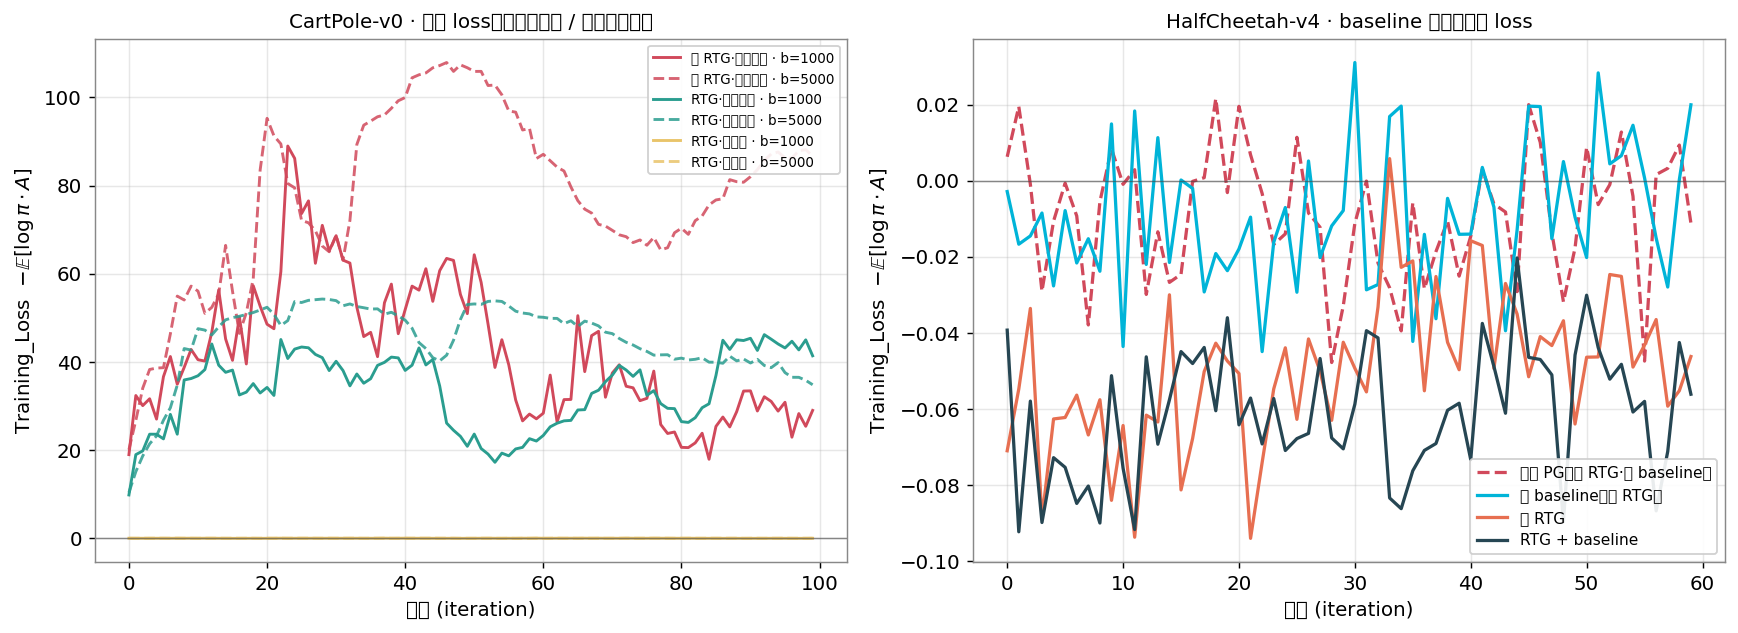
下图展示策略代理损失 的曲线。原始标量未公开,因此只保留图中可观察到的尺度差异。
图 5:策略代理损失曲线。左为 CartPole-v0 配置比较,右为 HalfCheetah-v4 配置比较;不同面板的纵轴尺度不同。
读图要点:loss 的尺度由”优势是否标准化”决定,而非由”学得好不好”决定
- CartPole(左): 标准化优势的曲线更接近零;这与优势重标度会改变代理损失尺度一致。
- HalfCheetah(右): 四条曲线都处于较小尺度,代理损失的绝对值不能直接作为策略质量排序。
- 当前图不直接测量 baseline 对梯度方差的影响,也不支持把尺度差异写成单因素因果。
重要:Training_Loss 不是”越小越好”的收敛指标
与监督学习不同,PG 代理损失没有“最优值为 0”的含义,其尺度受优势重标度影响。评估策略表现应结合公开回报曲线,不能只看该损失图。
7. 现象分析
7.1 方差:PG 一切问题的根源
多张公开回报曲线有明显波动,这与策略梯度估计方差较大的机制一致;曲线本身也混合了环境随机性与评测噪声,不能作为梯度方差的直接测量。
7.2 batch size:最”钝”但最可靠的降方差
在独立同分布等条件下,Monte Carlo 均值估计的方差随样本数增加而下降。CartPole 大批量面板中的三条曲线后期都在满分附近;InvertedPendulum 的绿色联合配置后期较高,但该配置同时改变 batch 与学习率,不能把差异单独归因于 batch。
7.3 reward-to-go:几乎”免费”的降方差
RTG 把与当前动作因果无关的过去奖励从估计量中移除。小批量 CartPole 与 HalfCheetah 的公开曲线中,含 RTG 的配置后期更高;这是单种子配置观察,不足以直接测量方差下降幅度,也不能证明它是后续 baseline/GAE 的必要前提。
7.4 baseline:有条件的降方差
减去只依赖状态的 在标准 score-function 推导中不改变期望梯度。HalfCheetah 的本次配置中,含 RTG 的两条曲线后期高于不含 RTG 的两条;实验未直接测量值函数拟合误差或梯度方差,因此不能据此确定性能差异的具体机制。
7.5 GAE-λ:把偏差-方差做成一个旋钮
GAE 用 在短程自举与长程回报之间插值。图 4 中 的后期回报高于 ;由于没有直接测量估计偏差与梯度方差,本实验只把这一现象视为与经典机制一致。
四种手段的统一视角
手段 降的是 是否引偏差 额外采样成本 本次实测最大收益 batch↑ 方差(理想独立样本下随样本数下降) 否 需要更多样本 CartPole 大批量三条曲线后期均接近满分 reward-to-go 方差(删无关项) 否 不额外采样 小批量 CartPole 与 HalfCheetah 中含 RTG 曲线后期更高 baseline 方差(减基准) 否* 需训练值函数 本次 HalfCheetah 配置结果依赖是否含 RTG GAE-λ 方差↔偏差可调 是(通常 引入自举偏差) 不额外采样 Hopper 中间与高 曲线后期较高 *baseline 理论无偏;实践中若 拟合差会引入”估计噪声”而非”系统偏差”。
8. 理论 ↔ 实践对接(回扣模块 03)
8.1 REINFORCE 的高方差 → 尖刺曲线
模块 03 第 7–8 节说明在其近似假设下,PG 梯度方差会随时域、奖励尺度增大,并随独立 batch 平均约按 降低。本次曲线尖刺与高方差更新导致策略跨越稳定区边界的解释一致,但单条 return 曲线也混合了环境随机性与评测样本噪声,不能把尖刺当作梯度方差的直接测量。
8.2 reward-to-go 与因果性
模块 03 第 4 节: 时刻的动作不可能影响此前奖励,故在标准 on-policy 推导中可移除相应项而不改变期望梯度,并通常降方差。小批量 CartPole 与 HalfCheetah 的结果支持 RTG 有益;但有限种子下的回报差异同时受优化随机性影响,应视为与理论一致的实验结果,而非对方差大小的直接估计。
8.3 baseline 与梯度无偏性的边界
模块 03 第 5–6 节证明任何只依赖状态的 都满足 ,故在标准条件下减 baseline 不改变期望梯度。6.3 中含 RTG 的配置后期更高,但实验未测量 的拟合误差,不能确定差异由 baseline 预测质量造成。
8.4 GAE 的偏差-方差权衡
GAE 属于模块 06 的进阶内容,但其思想是模块 03“用 做 baseline / 自举”的自然延伸:, 在短程自举与长程回报之间插值。图 4 的结果与该机制一致,但没有直接测量偏差或方差,不能称为“完整复现”。
前沿实践(2024–2026)
本实验只比较课程作业中的策略梯度配置,不据此概括 2024–2026 年大模型强化学习方法的采用情况。
9. 反思
为什么这样:训练采集用采样
On-policy 训练数据采集需按当前随机策略采样,以匹配策略梯度估计中的分布并保留探索。单独评测可选择随机或确定性协议;确定性评测不会反向阻止训练改进,但必须明确协议并保持比较一致。
为什么这样:loss 用 mean 而非 sum
模块 03 的公式是对轨迹内求和 。能不能严格照抄用 sum? 可以,但 batch 里轨迹条数/长度会波动,sum 会让有效梯度尺度随 batch 漂移、训练不稳。用
mean相当于把 折进学习率,是”数学等价 + 工程更稳”的常见做法。这解释了为什么几乎所有实现都用 mean。
为什么这样:本次 baseline 配置依赖 reward-to-go
本次 HalfCheetah 配置中,含 RTG 的曲线后期更高;这提示 baseline 的效果可能受回归目标与预算影响。单种子消融不能推出 baseline 普遍必须先配 RTG。
为什么这样:GAE 甜点在 0.95~0.99 而非 0 或 1
本次曲线中间 配置后期较高,但单种子结果不能证明极端点普遍更差,也不能把差异直接归因于偏差或方差。 的选择应结合值函数质量、任务与多种子评估。
数据诚实性 / 本次实验的局限
- 单种子(seed=1)。 曲线差异可能包含初始化和采样随机性,不宜过度解读;严谨结论需多种子重复。
- HalfCheetah / Hopper 做了规模缩减。 完整预算与外部参考分数未公开;本报告只描述公开曲线中的单种子相对趋势,不声称结论跨预算稳健。
- 跳过了课程中的 LunarLander 实验,baseline 的考察改用 HalfCheetah 四配置比较;该替代不等同于隔离得更干净。
- loss 仅作诊断、非收敛指标。 代理损失的绝对值、正负与量级受优势尺度影响,不能当作“越小越好”的策略质量指标。
High-level insight
HW1 的主题是”分布会漂移”,HW2 的主题是”梯度估计充满噪声”。策略梯度给了我们一个理论上优雅、实践上极不稳定的对象,而这份作业的四个技巧——batch、reward-to-go、baseline、GAE——本质上是同一件事的四种切法:在不(过多)引入偏差的前提下,把 的方差压下来。理解它们的共性(都在降方差)与差异(代价、前置条件、是否可调偏差),你就握住了从 REINFORCE 一路到 PPO、GAE、乃至今天 LLM 的 GRPO 的同一根主线:如何用有限的采样,得到一个既准又稳的策略改进方向。
Claim–Evidence 对照
| 结论 | 状态 | 证据 | 升级条件 |
|---|---|---|---|
| 在现有 CartPole-v0 单种子实验中,大批量配置的三条学习曲线均达到满分附近。 | 已验证 | 图片 ↗ | — |
| 在现有 CartPole-v0 小批量实验中,reward-to-go 配置的后期回报高于无 reward-to-go 配置。 | 已验证 | 图片 ↗ | — |
| 在现有 HalfCheetah-v4 消融中,包含 reward-to-go 的两条曲线后期高于不含 reward-to-go 的两条曲线。 | 已验证 | 图片 ↗ | — |
| 在现有 Hopper-v4 扫描中,GAE λ=0.95、0.99 和 1 的后期回报高于 λ=0。 | 已验证 | 图片 ↗ | — |
| 现有 rollout 视频分别展示了四个实验环境中的代表性策略行为。 | 已验证 | 视频 ↗视频 ↗视频 ↗视频 ↗ | — |
证据文件
9 个文件