CS285 HW5 实验报告:探索(RND)+ 离线 RL(CQL / AWAC / IQL)
本报告迁移自原课程材料,经 AI 事实核查未发现存疑项,未逐页人工审核;结论与证据请以页面列出的原始文件为准。
实验目标
HW5 把"探索"与"离线 RL"拼成一条流水线,按 5 个 Part 递进:
实验设置
| 环境 | Pointmass Easy / Medium / Hard;迁移报告记录为单种子、缩减预算,但未公开环境锁定文件、运行配置或原始日志。 |
|---|---|
| 随机种子 | 未固定或正文另述 |
| 关键配置 | 无 |
本报告迁移自 CS285 课程材料 [1]。
本报告是模块 10(探索)与模块 09(离线 RL)的动手配套。实验在 Pointmass Easy / Medium / Hard 上串联无监督探索与离线学习:RND 用固定随机目标网络的预测误差构造探索奖励 [2];CQL、AWAC 与 IQL 分别以保守 Q 估计、优势加权策略更新和 expectile 回归处理离线数据 [3] [4] [5]。公开证据包括结果图与 rollout 视频;原始 TensorBoard 日志、stdout、代码、运行配置和 checkpoint 未随迁移公开,因此正文中的结果数字仅按这些公开图表核对。迁移报告记录为单种子、缩减预算;同一 Part 内可看趋势,跨 Part 不用于算法排名。
本报告要回答的问题
- RND 内在奖励能否让状态覆盖比 ε-贪婪随机探索更均匀、进而学到更好的策略?(Part 1)
- 在同一批探索数据上做纯离线学习,CQL 相比朴素 DQN 如何改变 Q 值?保守度 、数据量、奖励平移缩放各自的影响?(Part 2)
- 把 RND bonus 与环境奖励混合做”监督式”探索,比纯无监督探索好在哪?(Part 3)
- AWAC 的温度 、IQL 的 expectile 如何权衡”贴数据 vs 贴 Q-贪婪”?三种离线算法(CQL/AWAC/IQL)孰优?(Part 4/5)
- 这些实测如何回扣模块 09(CQL 的条件性保守保证 / IQL 隐式最大化)与模块 10(count / RND / 信息增益)的理论。
一句话结论
在 Easy 图中,RND 组后期回报高于随机探索组,且访问覆盖更分散;Medium 离线图中,CQL 的两类 Q 曲线低于 DQN,奖励变换设置下 DQN 与 CQL 的后期回报均高于各自未变换设置;AWAC 与 IQL 的图则显示不同超参数曲线在图示区间内存在差异。以上都是公开图中的相关观察,不据此判定具体因果机制。
证据口径 / 复现契约
- 环境与重复: 迁移报告记录为 Pointmass、单种子和缩减预算;精确依赖版本、种子编号、各 Part 步数及运行配置未公开,不能在本页独立核对。
- 比较限制: 不同 Part 的 buffer、预算与 actor 设置未统一,不能用于算法排名。
- 视频: 导航视频各展示一条 rollout,不能作为训练配置、平均成功率、存档重载链路或算法排序证据。
- 公开范围: 本页公开结果图与 rollout 视频,不公开原始日志、代码、checkpoint 或本机运行路径。
【单种子趋势】【同 Part 内参数扫描】【跨算法存在混杂】 CQL/AWAC/IQL 若 buffer、预算、actor 不同,只能说明均可工作,不能排名。
1. 作业目标与要求
HW5 把”探索”与”离线 RL”拼成一条流水线,按 5 个 Part 递进:
| Part | 要实现 / 验证的东西 | 本报告覆盖 |
|---|---|---|
| 1 | 实现 RND 内在奖励,用 argmax(探索 critic) 做无监督探索;对比 RND vs 随机探索的状态覆盖与学习曲线 | ✅ Easy + Medium(回报 + 4 张密度热力图) |
| 2 | 实现 CQL 保守正则,离线对比 CQL vs DQN;扫 、扫数据量、试 reward 平移缩放 | ✅ Medium 离线, + 数据量 + shift/scale |
| 3 | 把 RND bonus 与环境奖励混合做”监督式”探索,再离线利用;对比 DQN/CQL | ✅ Hard(shift/scale) |
| 4 | 实现 AWAC 优势加权 actor 更新;扫温度 | ✅ Easy + Medium, |
| 5 | 实现 IQL 的 expectile 值函数回归;扫 ,并与 CQL/AWAC 横比 | ✅ Easy + Medium, |
需要自己补全的关键代码点(skeleton 中标为 TODO):RND 的目标/预测网络与预测误差(exploration/rnd_model.py)、探索↔利用切换与 RND bonus 归一化与混合奖励(agents/explore_or_exploit_agent.py)、CQL 保守项(critics/cql_critic.py)、AWAC 的优势估计与 actor 更新(agents/awac_agent.py + policies/MLP_policy.py)、IQL 的 expectile V 回归与 Q 回归(agents/iql_agent.py + critics/iql_critic.py)。评测环境:
| 环境 | 结构 | 观测 | 动作 | ep_len | 奖励 |
|---|---|---|---|---|---|
PointmassEasy-v0 | 两段走廊 + 一个直角弯 | 2 维 | 5 个离散(上下左右+停) | 50 | 稀疏:每步 ,到目标停 |
PointmassMedium-v0 | 多转弯迷宫 | 2 维 | 5 个离散 | 150 | 同上 |
PointmassHard-v0 | 四房间(窄通道) | 2 维 | 5 个离散 | 100 | 同上 |
为什么用网格世界而不是 MuJoCo?
探索与离线 RL 的核心矛盾(覆盖不足、分布外高估)在难探索的稀疏奖励迷宫里最尖锐、也最好可视化——2 维状态可以直接画成密度热力图,一眼看出”agent 到底去过哪里”。
2. 环境与任务介绍
本节按迁移报告记录评测环境与任务流水线;相关源码未作为公开证据迁移,因此参数表用于说明实验设置,不作为独立复现材料。
2.1 Pointmass 环境族(Easy / Medium / Hard)
三个环境是同一个 Pointmass(gym.Env) 类用不同 difficulty 实例化而来(Easy=0 / Medium=1 / Hard=2),只在地图、起点/目标、网格尺寸、horizon 上不同,其余机制完全共享:
- 状态空间:2 维连续坐标 ,
observation_space为Box,但返回给 agent 的观测经_normalize_obs按网格高/宽归一化到 (起点在左下、目标在右上角附近)。 - 动作空间:
Discrete(5),映射ACT_DICT= {0:停留 、1:下 、2:上 、3:左 、4:右 };每个动作再叠加高斯噪声(action_noise=0.5)并分 10 个子步做连续位移 + 撞墙检测——所以动力学是随机的,这正是需要”探索”的原因。 - 奖励:默认稀疏——
reward = int(dist<ε) − 1,即每步 −1、只有落在目标半径 内那一步为 0(dense_reward默认关闭;若开则为 )。回报越接近 0 越好。 - 目标 / 终止:固定
fixed_goal;当 (resize_factor)或步数用尽即done。到达目标即”解开”该迷宫。
环境(difficulty) | 底图 | 网格尺寸 (resize×原图) | 起点→目标 (归一化前) | 目标半径 | Horizon max_episode_steps |
|---|---|---|---|---|---|
PointmassEasy-v0(0) | Maze5x5(L 形走廊 + 一个直角弯) | 10×10(×2) | 2 | 50 | |
PointmassMedium-v0(1) | Maze6x6(多转弯迷宫) | 6×6(×1) | 1 | 150 | |
PointmassHard-v0(2) | FourRooms(四房间 + 窄门) | 22×22(×2) | 2 | 100 |
| 共享机制 | 取值 / 说明(源码核对) |
|---|---|
| 观测维度 / 动作维度 | obs_dim=2(归一化 )/ Discrete(5) |
| 动作噪声 | 高斯 action_noise=0.5,10 子步连续积分 + 撞墙回退(simulate_step) |
| 奖励 | 稀疏 (每步 −1,到目标 0) |
| 终止 | 到达目标(dist<)或 horizon 用尽 |
| 最优可达距离 | networkx 全源最短路 _compute_apsp(仅供参考/评测,不参与训练) |
2.2 离线数据集从哪来、规模多大
HW5 没有外部数据集——离线 buffer 完全由探索阶段自采:agent 先在环境里跑 num_exploration_steps 步(用 RND 定向或随机策略),把每条 转移写进 replay buffer。开启 --offline_exploitation 后,一旦越过 num_exploration_steps 就停止写 buffer,利用 critic / actor 只在这批固定数据上更新,即”纯离线”。因此:
| 项 | 本报告取值 / 来源 |
|---|---|
| 数据来源 | 探索策略自采(RND 内在奖励引导 或 ε-贪婪随机),写入 replay_buffer |
| 数据规模(transition 数) | = num_exploration_steps:主对比 10000,数据量消融用 5000 / 10000 / 20000 |
| 离线切换 | --offline_exploitation:越过探索阶段停采,只在固定 buffer 上离线优化 |
| 奖励变换(可选) | ,稀疏环境上常用 抬升尺度 |
“探索质量 = 离线数据质量”
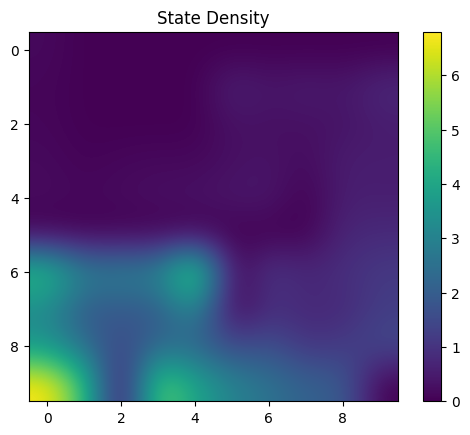
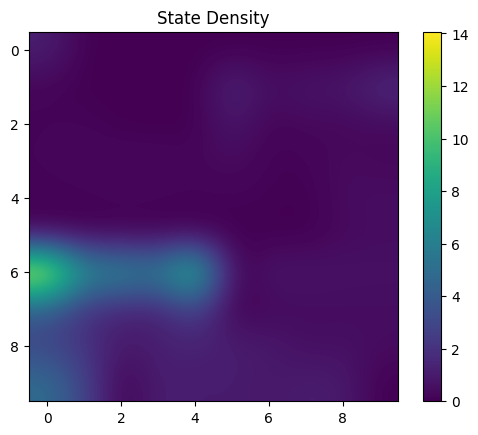
这正是 HW5 把两个模块串成流水线的关键:离线 buffer 的覆盖广度完全由探索策略决定;RND 把状态覆盖沿走廊铺开(见 Part 1 密度图),离线算法才有到达目标的转移可学。
2.3 任务流水线(5 个 Part 复述)
五个 Part 沿”先探索、后离线”递进,每个 Part 要验证的核心问题:
| Part | 阶段 | 任务 | 关键变量 |
|---|---|---|---|
| 1 | 探索 | RND 内在奖励探索 vs ε-贪婪随机探索:比状态覆盖与离线回报 | use_rnd / unsupervised_exploration |
| 2 | 离线 | CQL vs DQN:Q 值高估、保守度 扫描、奖励平移缩放 、数据量消融 | cql_alpha / exploit_rew_shift·scale / num_exploration_steps |
| 3 | 监督探索 | RND bonus 与环境奖励混合的”监督式”探索 + 奖励变换,再对比 DQN/CQL(Hard) | 混合权重退火 / shift·scale |
| 4 | 离线 | AWAC 优势加权 actor,扫温度 | awac_lambda |
| 5 | 离线 | IQL expectile 值回归,扫 ,并与 CQL/AWAC 横比 | iql_expectile |
3. 实验环境与局限
迁移报告记录本次实验使用 Pointmass 环境、单种子和缩减预算。由于没有公开环境锁定文件、运行配置与原始日志,本页删除精确依赖版本、种子编号和各 Part 步数,不主张第三方可逐项复现,只对公开图表与视频中可见的现象负责。
4. 实验 setting 与公开限制
公开结果图标出了所比较的方法、奖励变换和参数扫描取值,可用于核对正文中的曲线比较;但完整运行配置未公开,无法核对精确依赖版本、种子编号、训练步数及未显示在图中的默认超参。因此本节不再把迁移报告中的这些数字写成已验证的实际运行事实。
5. 代码实现讲解(关键原创片段)
5.1 RND:用”随机网络的预测误差”当好奇心
RND 使用固定随机初始化的目标网络与可训练的预测网络,并以预测误差作为探索奖励;论文也说明预测误差还会受到随机性、模型失配和优化过程影响,不能把误差直接等同于访问计数 [2]。
(此处的实现代码或复现命令不在本站发布。)
5.2 探索↔利用切换 + RND bonus 归一化 + 混合奖励
explore_or_exploit_agent 是整条流水线的调度器:探索阶段用 ArgMaxPolicy(exploration_critic) 采数据;越过 num_exploration_steps 后把 collect-policy 切到 exploitation_critic;offline_exploitation 打开时越过阈值就停止写 buffer(纯离线)。RND bonus 必须归一化——它跨状态能差 100×,不归一会让 critic 训练被极端样本主导。
(此处的实现代码或复现命令不在本站发布。)
step_env 里的离线门控(越过探索阶段后不再写 buffer):
(此处的实现代码或复现命令不在本站发布。)
5.3 CQL:在 Bellman 误差上加一个”压 OOD”的保守项
CQL 在标准 (D)DQN 残差上加入保守正则,以数据分布内动作作为参照抑制其他动作的 Q 值;下界结论依赖论文给出的条件,并非任意深度网络上的逐点保证 [3]:
(此处的实现代码或复现命令不在本站发布。)
为什么这个正则能”压 OOD 高估”?
离线 RL 的灾难链是:Q 高估某个没在数据里出现的 OOD 动作 → 提取策略漂向该动作 → 真跑起来烂。CQL 的正则相对于”数据动作”把”所有动作的 soft-max”整体压低——数据动作被抬、其余(尤其被高估的 OOD)被压,于是 Q 在数据外更保守;理想条件下可得到策略期望价值的下界保证,但现实深网中不是普遍逐点真值下界。 就是”保守多少”的旋钮。
5.4 AWAC:优势加权的”加权行为克隆”
AWAC 的 actor 更新把数据中的 按 加权做最大似然,并通过受约束的策略更新限制偏离已有数据 [4]。本实现中权重不参与梯度;离散动作下 可直接求和。
(此处的实现代码或复现命令不在本站发布。)
5.5 IQL:expectile 值回归 + 用 V(s’) 做 bootstrap
IQL 用 expectile 回归估计数据支持范围内的高价值动作,并在 TD 目标中避免查询样本外动作 [5]。本报告采用值函数 与 bootstrap:
(此处的实现代码或复现命令不在本站发布。)
expectile 与 CQL 的分工
CQL 和 IQL 治的是同一个病(OOD 高估),但手法相反:CQL 显式惩罚 OOD 动作的 Q;IQL 压根不碰 OOD 动作——它只用数据里出现过的 训 ,再用 expectile 的 做”温和的 max”。 时 (最乐观), 退化成普通均值回归(最保守)。
5.6 训练损失监控
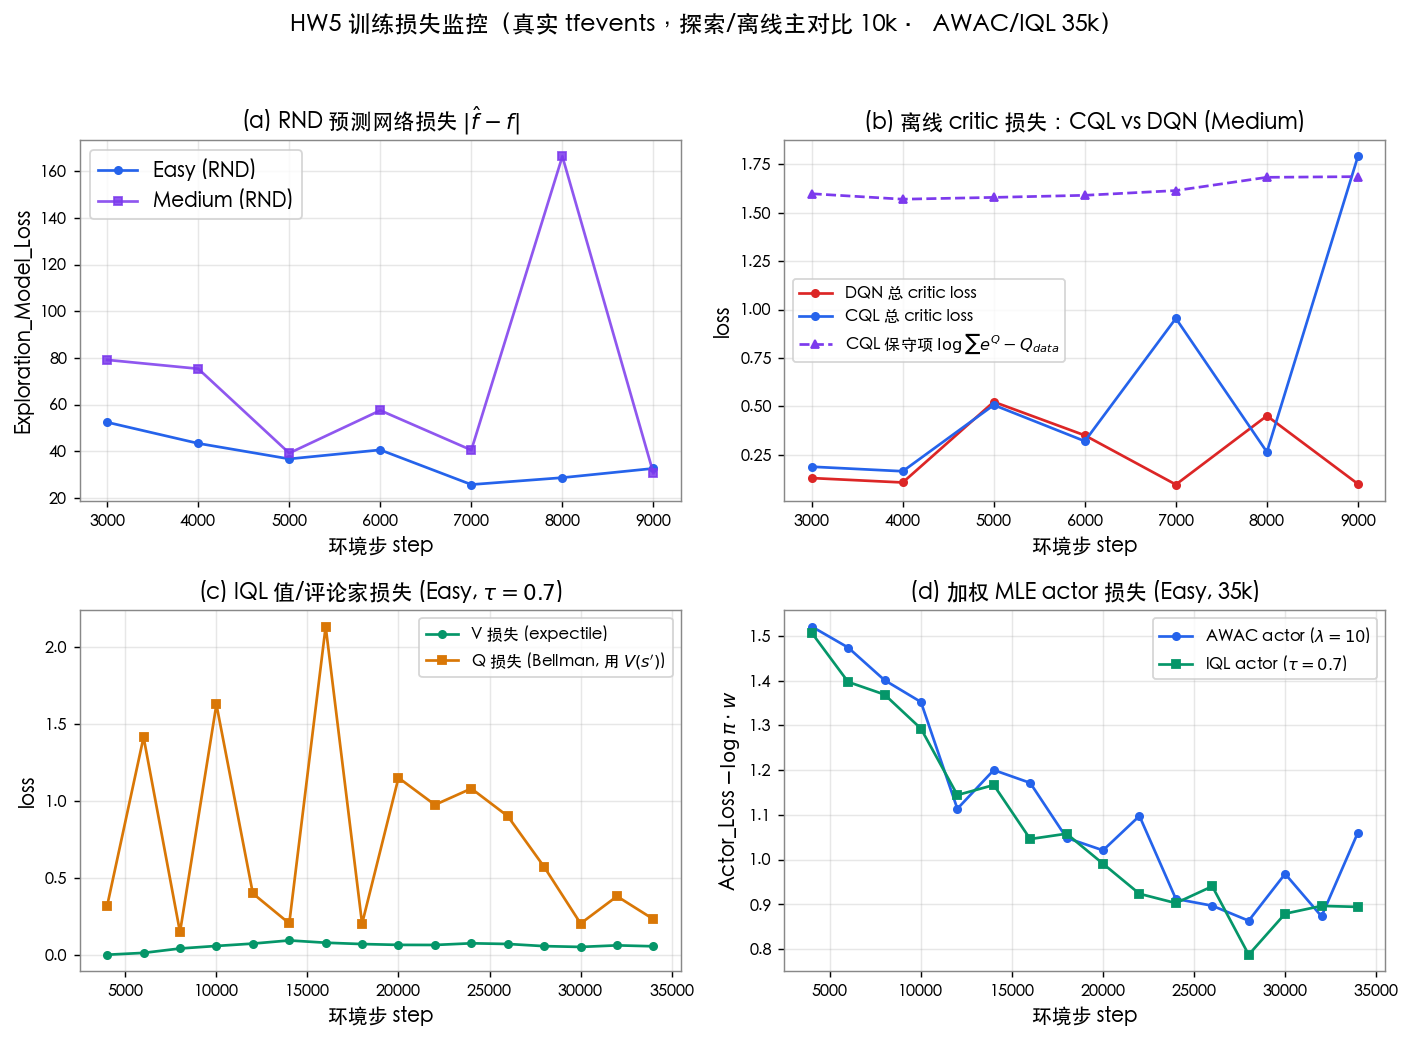
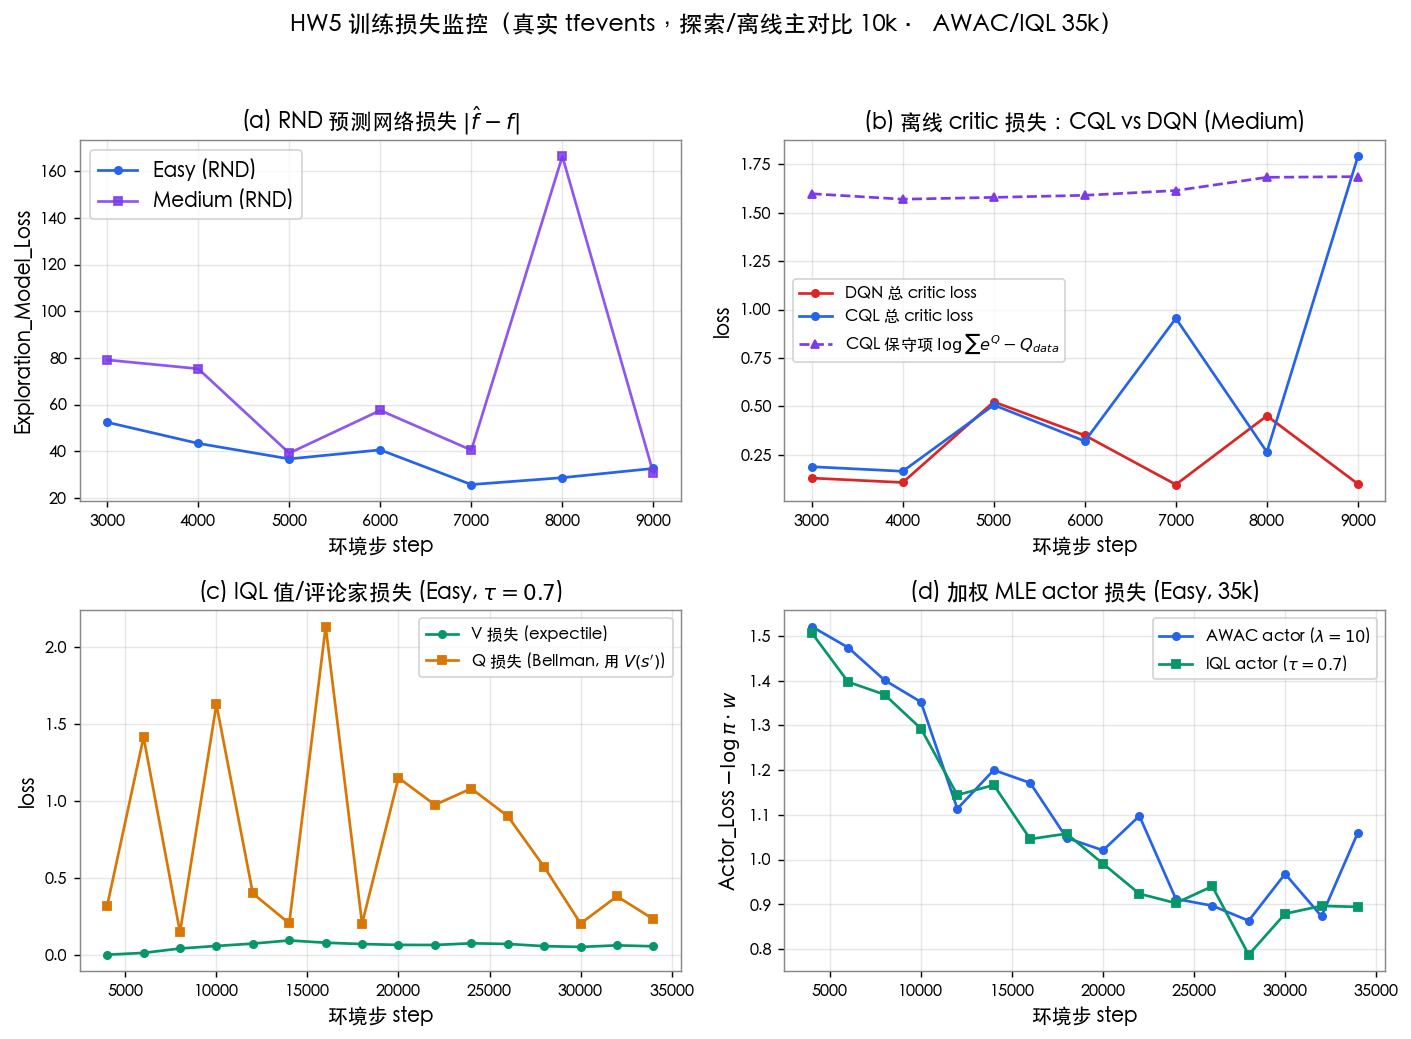
迁移产物保留了一张训练损失汇总图,包含 RND、CQL / DQN、IQL 与 actor 损失曲线。原始事件日志未公开,因此下文只描述图中可见趋势,不把曲线单独解释为收敛证明。
图 0:迁移时导出的四类训练损失曲线。(a) RND 预测损失;(b) CQL / DQN critic 损失;(c) IQL 的 V / Q 损失;(d) AWAC / IQL actor 损失。原始事件日志与采样配置未公开。
怎么读这四条损失
- (a) RND 预测损失整体下降(Easy 52→~30;Medium 噪声大但趋势向下):这与预测网逐渐拟合反复访问状态、内在奖励衰减的机制一致。Medium 中间尖峰可能来自新状态,也可能来自 minibatch 构成、优化噪声或表示尺度变化;没有把该时刻轨迹与损失对齐,不能断言它“对应首次闯入新区域”。
- (b) CQL 的”总 critic 损失”= DQN 的 Bellman 残差 + 一个持续为正的保守项(紫色虚线稳定在 ≈1.6):这条虚线 恒 > 0,说明 CQL 一直在把数据动作 Q 往上抬、把 soft-max(含 OOD)Q 往下压——它抬高了总损失并施加保守压力;这条曲线本身不能证明“Q 是真值下界”。DQN 无此项,Bellman 残差更小但仍可能受 OOD 外推与选择偏差影响。
- (c) IQL 的 V 损失极小且平稳(≈0.05)、Q 损失更大且抖:expectile-V 回归的目标(target Q)在本次运行中较稳定;Q 用 bootstrap,目标更易波动。IQL 避免显式查询 OOD 的 ,降低了一类外推风险,但函数逼近、优化或数据问题仍可能导致不稳定,不能表述为“不会发散”。
- (d) AWAC / IQL 的 actor 损失在图示区间下降(≈1.5→~0.9);这与策略逐步拟合加权数据动作相符,但单条损失曲线不能证明算法已收敛。
6. Part 1:RND vs 随机探索
【单种子趋势】【同预算探索对照】 Medium 主要证据是有限时域访问占用度,不是稳态分布。
无监督探索(--unsupervised_exploration):探索阶段只用内在奖励铺覆盖,利用 critic(CQL)只在环境奖励上离线学习、用作评测。对比 RND 定向探索与 ε-贪婪随机探索在 Easy / Medium 上的最终回报与状态密度。
| 环境 | 探索方式 | 最终 Eval 回报 | 最好 Eval 回报 | 解读 |
|---|---|---|---|---|
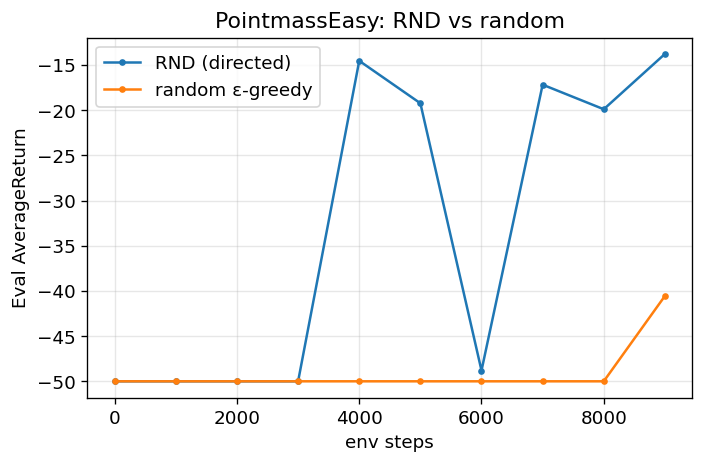
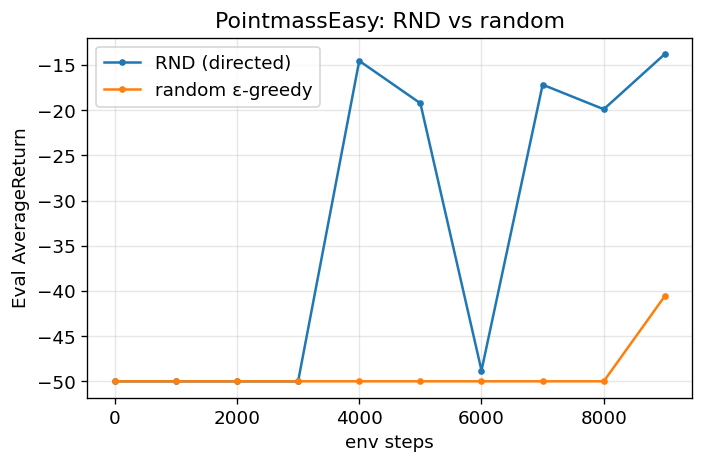
| Easy(ep_len 50) | RND | −13.78 | −13.78 | 后期回报高于随机组 |
| Easy(ep_len 50) | 随机 ε-贪婪 | −40.56 | −40.56 | 后期回报低于 RND 组 |
| Medium(ep_len 150) | RND | −150.0 | −150.0 | 降规模下回报未收敛,看覆盖 |
| Medium(ep_len 150) | 随机 ε-贪婪 | −150.0 | −150.0 | 覆盖挤在起点角落(见热力图) |
图 1:PointmassEasy 上 RND(蓝)与随机(橙)的 Eval 回报曲线。RND 组后期回报高于随机组,但中途有明显回落;该图不支持稳定性或单条轨迹成功率结论。
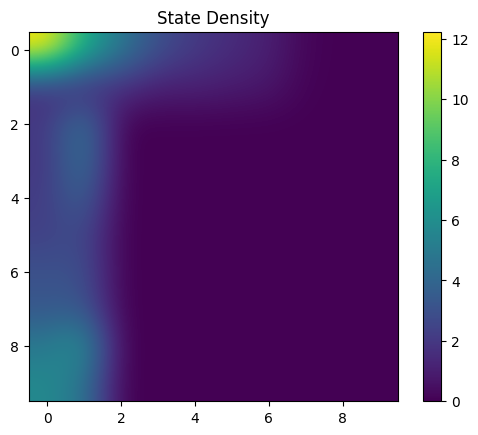
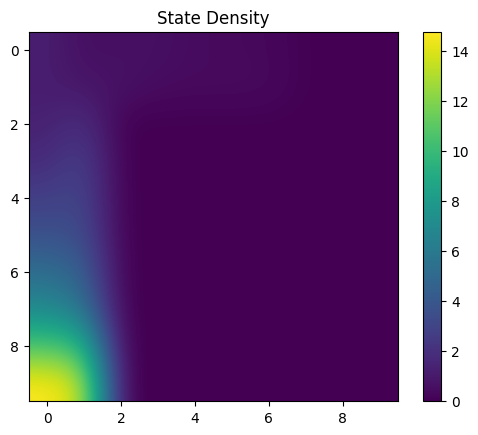
Medium 上两者最终回报都为 −150;在该缩减预算下,回报曲线没有显示出方法差异,因此这里只比较公开的状态覆盖密度图:
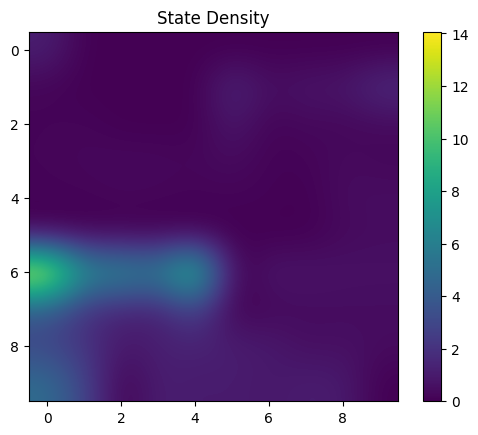
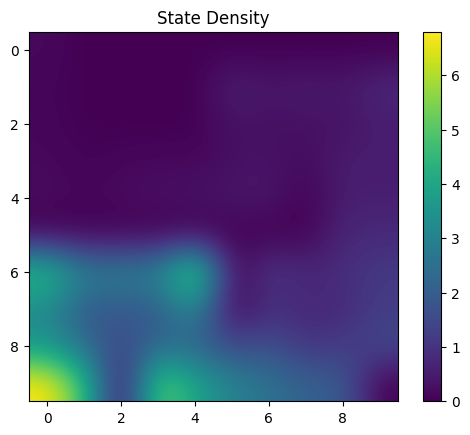
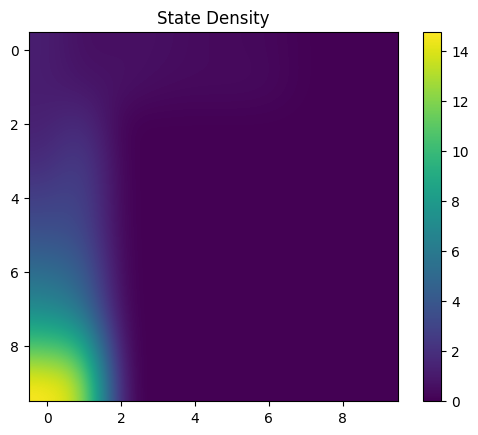
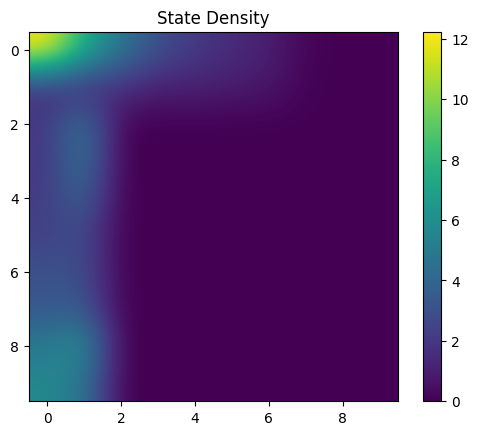
图 2:replay buffer 的状态访问密度。上排 Easy、下排 Medium;左列 RND、右列随机。RND 把访问密度沿可达走廊/通道铺开,随机探索的密度高度集中在起点角落(右下亮块)——这正是 RND 内在奖励驱动”离开已访问区”的直接体现。
为什么 RND 覆盖更广?(本质)
这里观察到的是有限时域、从固定起点出发的访问占用度,不是随机游走的稳态分布;真正稳态在遍历链上通常会忘记起点,也不普遍满足“访问概率随距离指数衰减”。在本迷宫与给定步数内,随机动作来不及充分混合,因此访问量集中在起点附近。RND 以预测误差作新颖度代理,促使 explore critic 偏向尚未拟合的区域,从而把覆盖推向走廊深处;但“误差 = 新颖”只在观测噪声与函数逼近误差受控时近似成立。数据若未覆盖目标相关区域,后续纯离线算法确实无法可靠学出相应行为。
7. Part 2:离线学习(CQL vs DQN)
【单种子】【同 Part 参数扫描】 Q 值下降说明保守压力生效,不直接证明真实价值下界。
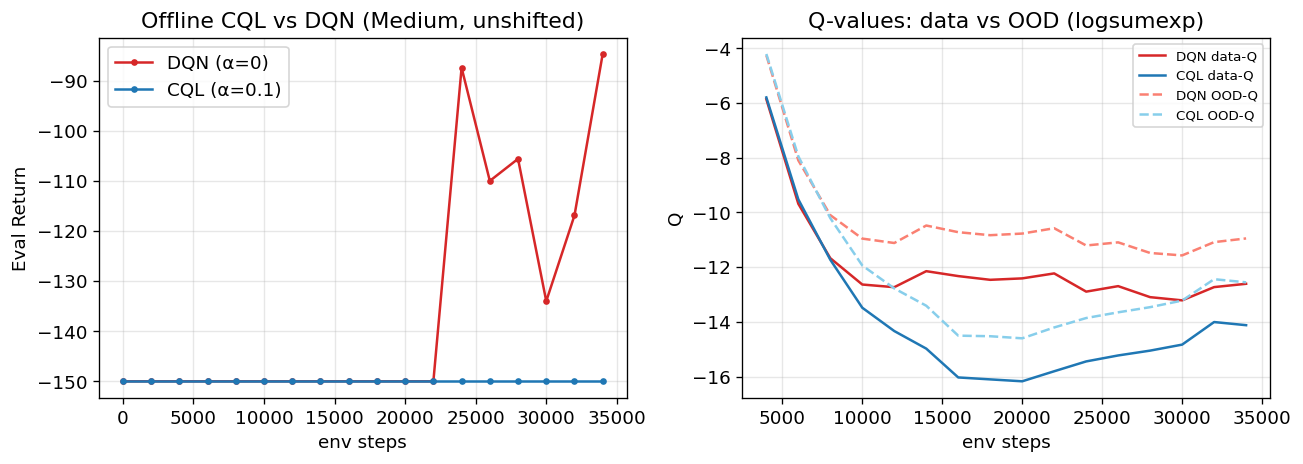
在 RND 收集的数据上做纯离线(--offline_exploitation)训练:越过 num_exploration_steps 后停止采数据,只在固定 buffer 上更新利用 critic。cql_alpha=0 即朴素 DQN,0.1 即 CQL。环境 PointmassMedium。
7.1 CQL vs DQN 的 Q 值与回报
| 方法 | 最好 Eval 回报 | 末段 Eval 回报 | 末段 数据动作 Q | 末段 OOD soft-max Q | |
|---|---|---|---|---|---|
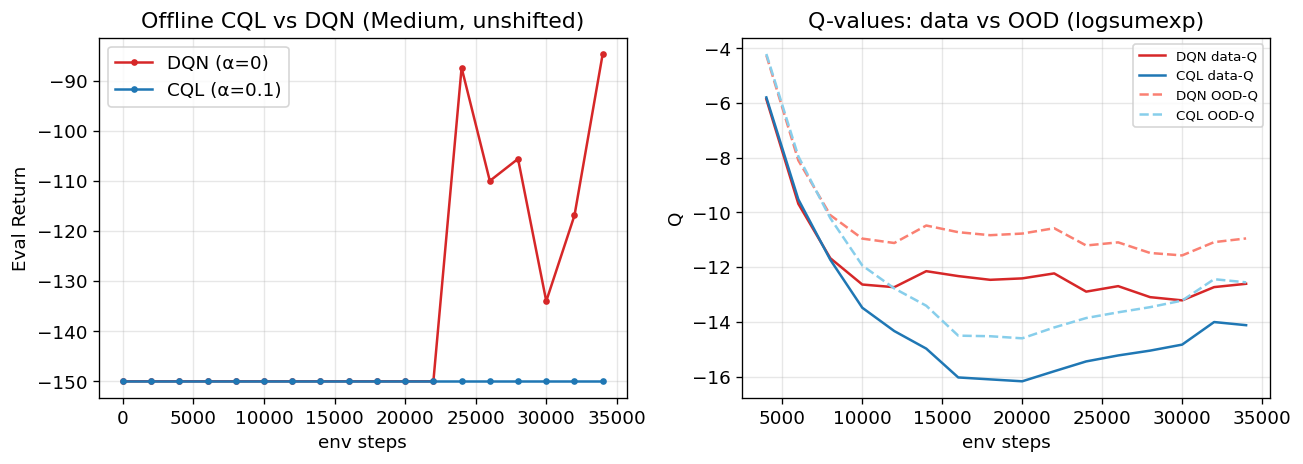
| DQN | 0 | −84.67 | −111.85 | −12.85 | −11.20 |
| CQL | 0.1 | −150.0 | −150.0 | −14.32 | −12.74 |
图 3:离线 CQL(蓝)vs DQN(红)。左:Eval 回报;右:数据动作 Q(实线)与 OOD soft-max Q(虚线)随训练的演化。
本次 CQL 的 Q 值是否低于 DQN?
是的。 在未做奖励变换的 Medium 图中,CQL 的数据动作 Q 与 soft-max Q 曲线后期均低于 DQN;同一图中 CQL 回报未优于 DQN。这与保守正则的方向一致 [3],但单次实验不能证明真实价值下界,也不能仅凭曲线确定回报差异的原因。
7.2 保守度 扫描
| 方法 | 最好 Eval 回报 | 末段 数据动作 Q | 末段 OOD Q | 解读 | |
|---|---|---|---|---|---|
| 0 | DQN | −84.67 | −12.85 | −11.20 | 无保守,Q 最高 |
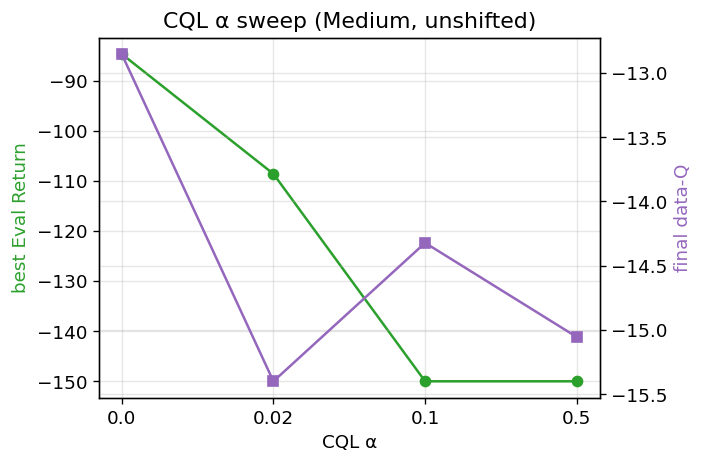
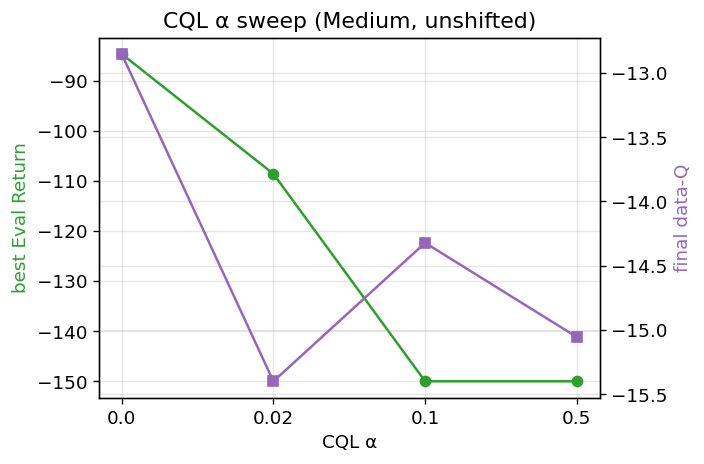
| 0.02 | CQL | −108.60 | −15.40 | −13.79 | 轻保守,Q 已被压低 |
| 0.1 | CQL | −150.0 | −14.32 | −12.74 | 图中回报最低 |
| 0.5 | CQL | −150.0 | −15.06 | −13.64 | 过度保守 |
图 4:CQL (Medium 未变换奖励)。绿线(回报)随 增大而下降,紫线(数据动作 Q)在 后整体低于 DQN。该单种子曲线只支持图示设置内的相关变化,不能单独确定回报差异的原因。
7.3 奖励平移缩放(关键)+ 数据量消融
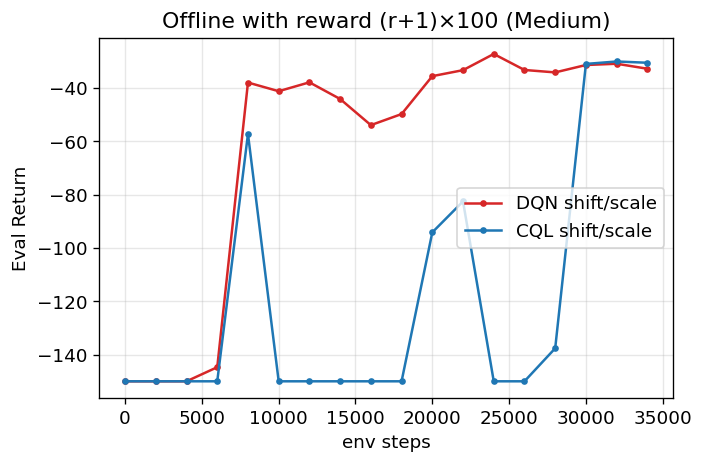
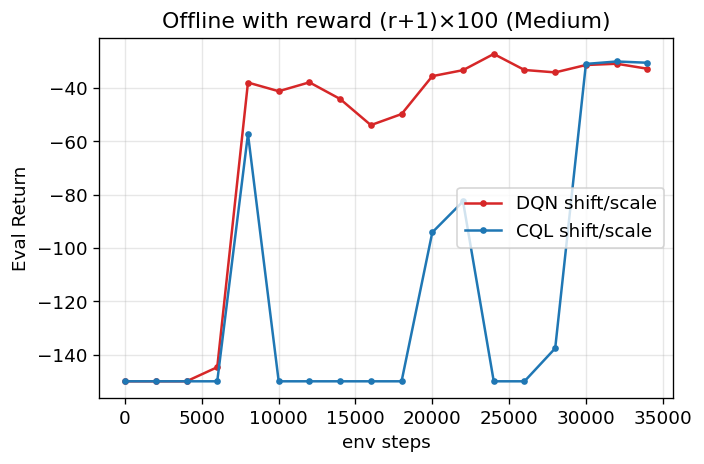
本次另行测试了奖励变换 。公开曲线显示 Medium 离线实验中 DQN 与 CQL 的后期回报均高于各自未变换设置:
| 设置(Medium 离线) | 方法 | 最好 Eval 回报 | 对比 |
|---|---|---|---|
| 原始奖励 | DQN | −84.67 | 未变换:都学不好,CQL 更差 |
| 原始奖励 | CQL α=0.1 | −150.0 | |
| DQN | −27.33 | 变换后:两者都近最优 | |
| CQL α=0.1 | −30.15 |
图 5:公开曲线显示,奖励变换 设置下,DQN 与 CQL 的后期回报均高于各自未变换设置;同图中 CQL 的数据动作 Q(29.0)低于 DQN(34.9)。这些曲线不能单独判定变化由哪一机制造成。
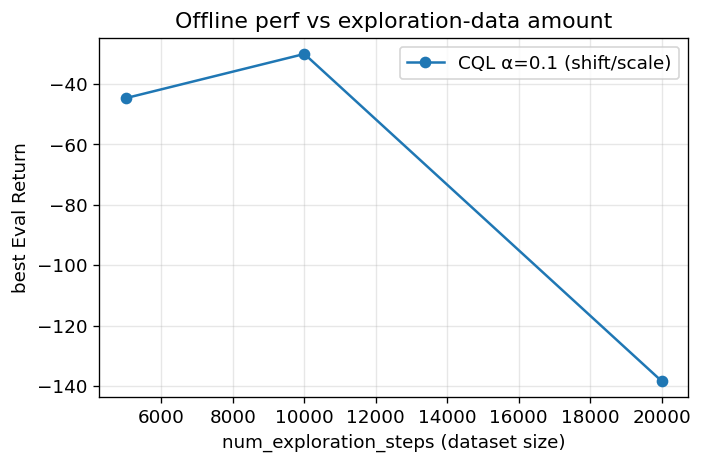
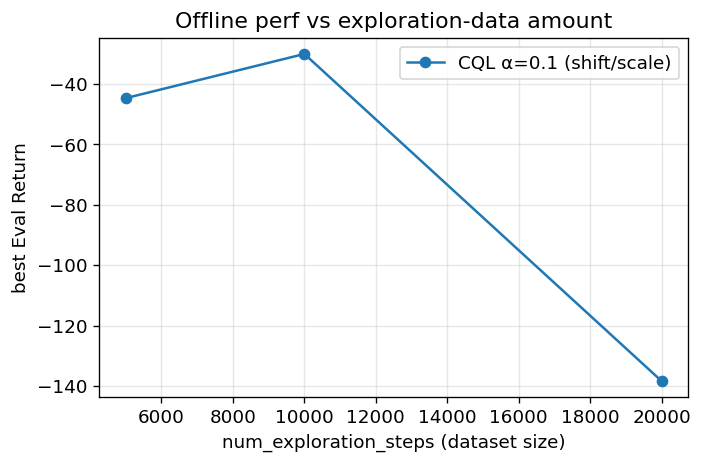
数据量消融(固定 CQL α=0.1 + shift/scale,变 num_exploration_steps,即离线数据量):
num_exploration_steps | 5000 | 10000 | 20000 |
|---|---|---|---|
| 最好 Eval 回报 | −44.77 | −30.15 | −138.38 |
图 6:离线回报随探索数据量的变化。5000→10000 时性能提升,但 20000 时下降到 −138。该扫描同时改变了剩余离线优化步数,且只有一个种子,因此不能把差异单独归因于数据量或数据质量。
8. Part 3:监督式混合奖励探索
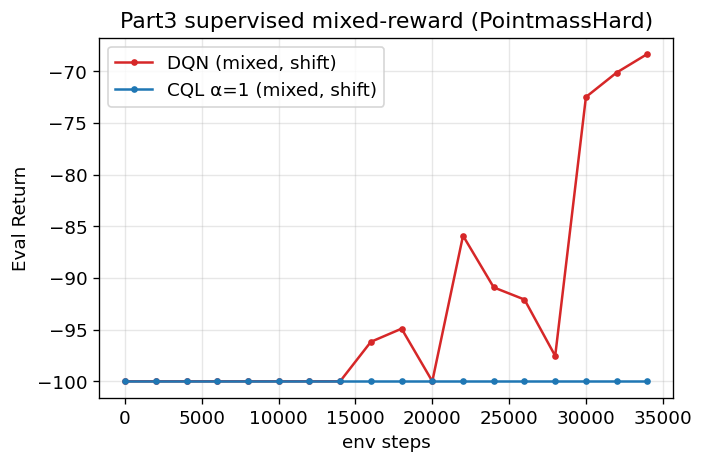
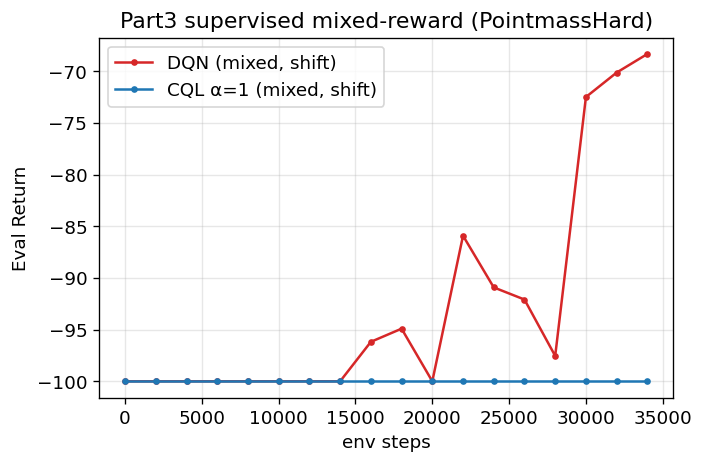
与 Part 1/2 的”纯无监督探索 + 纯离线”不同,这里 explore critic 学混合奖励 (explore_weight_schedule 从 1 线性退火到 0),利用阶段继续在线微调。公开图记录了 Hard 四房间中 DQN 与 CQL 的单种子结果。
| 环境 | 方法 | 最好 Eval 回报 | 末段 数据动作 Q | |
|---|---|---|---|---|
| Hard 四房间 | DQN | 0 | −68.33 | 5.97 |
| Hard 四房间 | CQL | 1.0 | −100.0 | 3.55 |
单种子结果
本次缩减预算、单种子运行中,DQN 曲线后期上升,而 CQL 曲线保持在 −100。该图支持“此设置下 CQL 未优于 DQN”,但不足以判断差异来自保守系数、预算还是随机性。
图 6:Part 3 监督式混合奖励探索下 DQN vs CQL 的 Eval 回报曲线。
9. Part 4:AWAC(优势加权 actor)
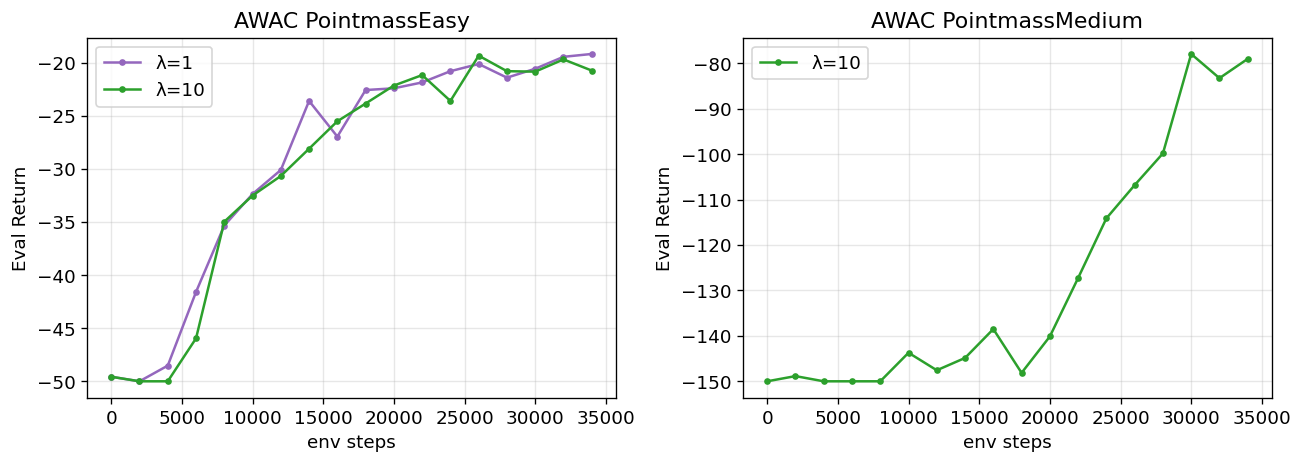
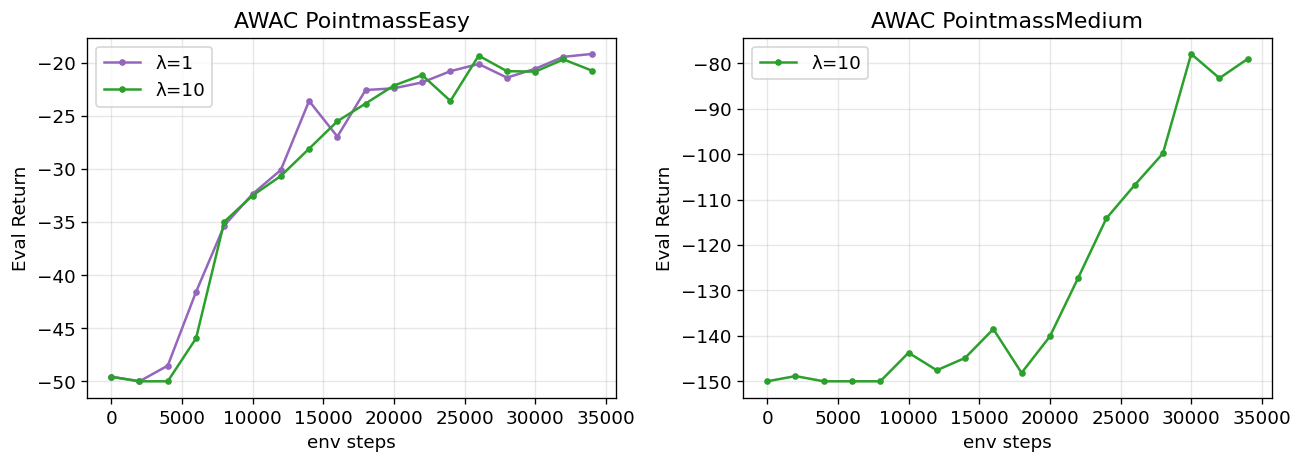
AWAC 以 为权重做加权 MLE。公开图比较了 Easy / Medium 上不同温度 的曲线。
| 环境 | 主曲线最好 Eval | |
|---|---|---|
| Easy | 1 | −19.16 |
| Easy | 10 | −19.32 |
| Medium | 10 | −77.92 |
的效应
在主曲线图示区间内,Easy 上 与 两条主曲线后期接近。这是单种子观察,不能据此断言温度造成的差异。
图 7:AWAC 在 Easy(左)/ Medium(右)上不同 的 Eval 回报曲线。
大小意味着什么?
是优势权重 的温度: 越大,权重越趋于均匀; 越小,权重越集中于高优势动作。公开曲线中,Easy 上两条主曲线后期都接近 −19。
10. Part 5:IQL(expectile 回归)+ 三算法横比
【跨算法混杂】 CQL/AWAC/IQL 的预算、buffer 与 actor 不同;横比只说明均可完成 Easy,不提供排名。
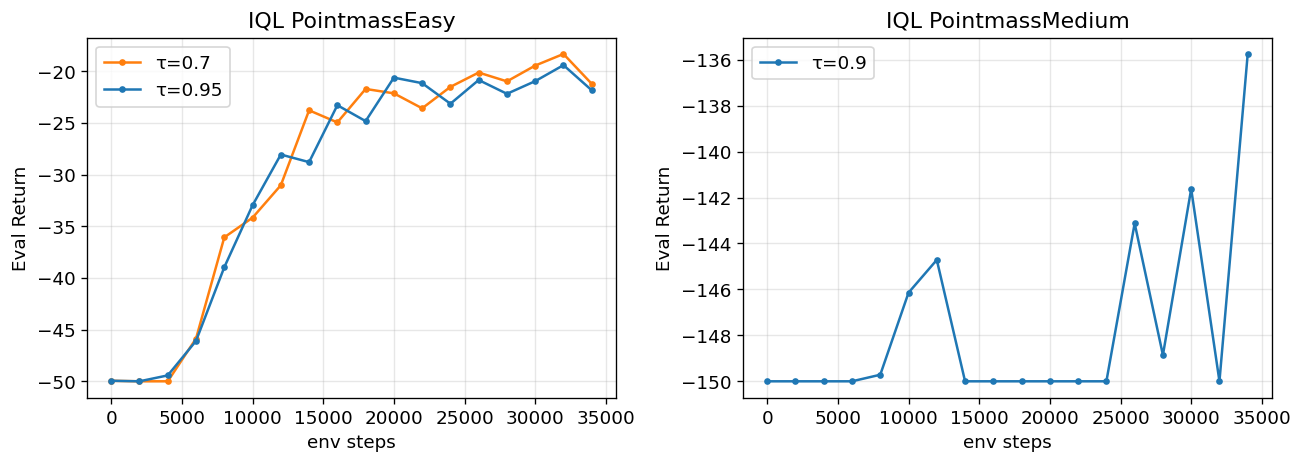
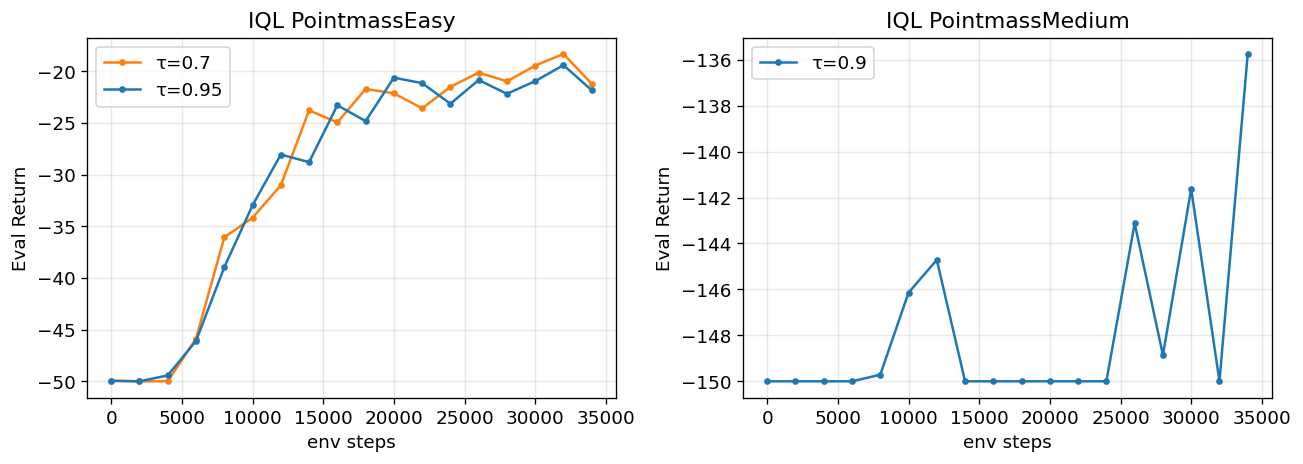
IQL 复用 AWAC 的 actor,但 critic 改成”expectile V 回归 + V(s’) bootstrap 的 Q”。扫 ()。
| 环境 | 主曲线最好 Eval | |
|---|---|---|
| Easy | 0.7 | −18.33 |
| Easy | 0.95 | −19.41 |
| Medium | 0.9 | −135.75 |
图 8:IQL 在 Easy(左)/ Medium(右)上不同 expectile 的 Eval 回报曲线。
越大越好?
控制 expectile 回归对正负残差的非对称权重 [5]。Easy 上两条主曲线后期接近;这是单种子观察,这里不作普遍的超参数因果结论。
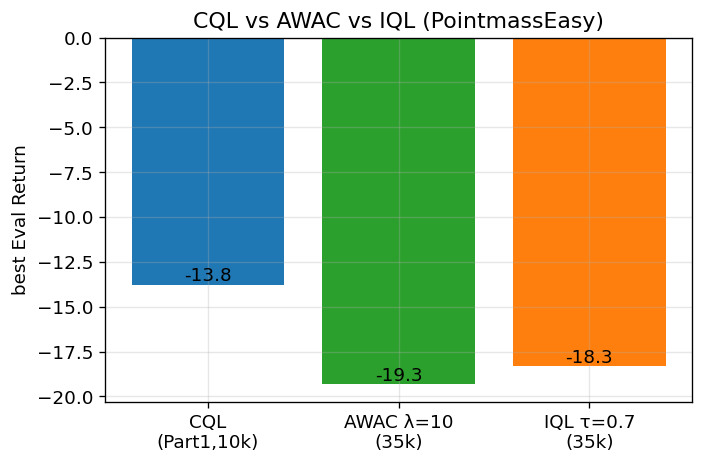
10.1 三种离线算法横比(PointmassEasy)
| 算法 | OOD 处理方式 | 关键超参 | Easy 最好回报 |
|---|---|---|---|
| CQL(利用 critic,Part1) | 显式保守正则(条件性下界) | α=0.1 | −13.78 |
| AWAC | 优势加权 MLE,隐式贴数据 | λ=10 | −19.32 |
| IQL | expectile V,完全不查 OOD | τ=0.7 | −18.33 |
图 9:三种离线算法在 PointmassEasy 上的最好回报。三条公开曲线都出现了到达目标对应的回报;由于预算与完整配置未统一公开,该图不用于算法排名。
横比的公平性说明
三者并非严格同预算/同设置,且完整运行配置未公开。因此这张横比只能说明三条公开曲线都出现了到达目标对应的回报,不宜据此断言优劣排序。若要严格横比,需要固定同一份 buffer、预算与重复设置后重跑。
11. 结果可视化(视频)
前面各 Part 用曲线和热力图记录实验趋势。本节公开四段 rollout 视频,用于观察访问覆盖和单条导航轨迹;视频不是训练配置、平均成功率或算法排名证据。
降规模说明(与正文一致)
迁移报告将这些视频描述为缩减预算下生成,但训练步数、运行配置和候选轨迹信息未公开,不能由视频核对。下文只描述画面可见行为:探索视频展示两组访问覆盖的差异,导航视频各展示一条到达目标的轨迹。
11.1 探索:RND vs 随机(状态覆盖动画)
图 0:视频 1(PointmassMedium):左侧标为 RND,右侧标为随机探索。画面中的累计热力图显示随机组访问集中在起点附近,而 RND 组沿可达走廊覆盖得更远;两组在视频中都未抵达目标区。
视频:expl_medium_rnd_vs_random.mp4
图 0:视频 2(PointmassHard = FourRooms):画面中随机探索的高频区域集中在起点所在房间,RND 组的访问轨迹延伸到相邻门洞附近。视频只支持这一可见覆盖差异。
视频:expl_hard_rnd_vs_random.mp4
11.2 离线:学到的策略从起点导航到 goal
视频 3(左)展示 PointmassEasy 中一条从起点到目标的轨迹;视频 4(右)展示 PointmassMedium 中一条绕过隔墙到达目标的轨迹。视频只支持这些可见行为,不支持训练配置、选择过程、稳定成功或平均性能结论。
视频:nav_easy_offline.mp4 视频:nav_medium_offline_cql.mp4
12. 理论 ↔ 实践对接
12.1 回扣模块 10(探索):count / RND / 信息增益
模块 10 把探索奖励分为基于计数、基于预测误差和基于信息增益等思路。RND 属于预测误差方法:固定随机目标网络、训练预测网络,并把误差作为探索奖励;论文明确指出误差还可能来自随机性、模型失配和优化动态 [2]。本实验的密度图只说明在给定环境、预算与种子下,RND 组覆盖更分散。
12.2 回扣模块 09(离线 RL):CQL 条件性下界与 IQL 隐式最大化
模块 09 的主线是 distributional shift → OOD 动作 Q 高估 → 策略漂移。三种解法在本作业里各占一角:
- CQL(条件性下界): 在 Bellman 误差上加入保守项;论文区分逐点 Q 下界与策略期望价值下界,并给出采样误差和保守系数等条件 [3]。
- AWAC(隐式约束到数据): 以优势加权似然更新策略,并通过约束避免策略过度偏离数据 [4]。
- IQL(隐式最大化): 用 expectile 回归在不查询样本外动作的情况下进行多步动态规划 [5]。
CQL 下界的条件与口径(要点)
对每个 最小化 的一阶条件给出 相对行为分布被整体下压,且对 压得更狠。加上 Bellman 项后,原论文在表格/充分表达、采样误差受控、保守系数足够等条件下给出策略期望价值口径的下界;不能简写成对每个 都有 。直观:soft-max 项像一个”对所有动作的天花板税”,只有数据动作能获得退税,于是没数据支撑的动作 Q 被系统性压低。
12.3 探索质量决定离线上限
本实验把探索与离线学习串联:探索阶段决定固定数据集中有哪些状态与动作,离线阶段只能从这些数据中学习。公开证据显示本次 RND 组覆盖更分散,但没有固定同一 buffer、多种子比较所有算法,因此不能从本实验建立“覆盖导致最终回报改善”的一般因果结论。
13. 反思
为什么这样:RND 目标网要冻结、且两网初始化不同
RND 的定义使用固定随机目标网络与可训练预测网络 [2]。若二者初始函数完全相同,初始预测误差会为零;但实际误差是否可靠表示新颖度仍受数据、模型和优化动态影响。
为什么这样:RND bonus 要做 running-std 归一化
本实现对 RND bonus 做 running-std 归一化,以控制训练中的奖励尺度。公开证据没有保留“归一化 / 不归一化”消融,因此不主张该处理在本实验中必然更稳定。
为什么这样:IQL 用 V(s’) 而非 max Q(s’,·) 做 bootstrap
IQL 用 expectile 值函数构造更新,并避免在 TD 损失中查询样本外动作 [5]。这减少了一类分布外查询,但不等于对任意函数逼近和数据集都能保证训练稳定。
数据诚实性 / 本次实验的局限
- 缩减预算。 迁移报告记录为缩减预算,但精确步数与运行配置未公开;本报告只描述公开图中的趋势。
- Medium/Hard 离线未收敛。 在降规模预算下 Medium 纯离线常卡在 −150;Part 1 的 Medium 结论主要靠覆盖热力图而非回报。
- 单种子。 迁移报告记录为单种子,但种子编号与原始评测日志未公开;公开曲线不支持跨种子结论。
- 两处非算法/正确性改动:给 run 脚本加
--num_timesteps/--learning_starts(默认值不变)、修 IQL 优势形状 bug(§3)。均不影响算法语义。
High-level insight
本报告可核实的核心观察是:在给定单种子与缩减预算下,RND 组覆盖更分散,几种离线更新在各自设置中呈现不同的 Q 值与回报曲线。更一般的算法优劣与因果关系需要固定数据、统一预算和多种子实验。
Claim–Evidence 对照
| 结论 | 状态 | 证据 | 升级条件 |
|---|---|---|---|
| 在本次 Easy 实验中,RND 组后期评测回报高于随机探索组。 | 已验证 | 图片 ↗ | — |
| 在本次有限步数的 Easy 与 Medium 实验中,RND 访问覆盖比随机探索更分散。 | 已验证 | 图片 ↗图片 ↗图片 ↗图片 ↗ | — |
| 在未变换奖励的 Medium 离线实验中,CQL 的数据动作 Q 与 soft-max Q 曲线低于 DQN,而评测回报未优于 DQN。 | 已验证 | 图片 ↗ | — |
| 本次 Medium 离线实验中,奖励变换设置下 DQN 与 CQL 的后期评测回报均高于各自未变换设置。 | 已验证 | 图片 ↗ | — |
| 本次 AWAC 实验中,Easy 的两条温度曲线后期接近,Medium 的回报在后期改善。 | 已验证 | 图片 ↗ | — |
| 本次 IQL 实验中,Easy 的两个 expectile 设置后期回报接近,Medium 设置仅有有限改善。 | 已验证 | 图片 ↗ | — |
| 导航视频分别展示了 Easy 与 Medium 中一条到达目标的 rollout。 | 已验证 | 视频 ↗视频 ↗ | — |
证据文件
18 个文件
参考来源
- [1]CS 285: Deep Reinforcement Learning(UC Berkeley)(在新窗口打开)↩
- [2]Exploration by Random Network Distillation(在新窗口打开)↩
- [3]Conservative Q-Learning for Offline Reinforcement Learning(在新窗口打开)↩
- [4]AWAC: Accelerating Online Reinforcement Learning with Offline Datasets(在新窗口打开)↩
- [5]Offline Reinforcement Learning with Implicit Q-Learning(在新窗口打开)↩