Goal-conditioned RL:HER、迁移与 Sim2Real proxy
本报告迁移自原课程材料,经 AI 事实核查未发现存疑项,未逐页人工审核;结论与证据请以页面列出的原始文件为准。
实验目标
本作业从零实现 9×9 goal-conditioned 导航、UVFA DQN、no-HER baseline、future/final HER、dense/sparse reward 与动力学域随机化。
实验设置
| 环境 | 观测不是图像,而是 row/column 分解 one-hot:agent 两组 + goal 两组,共 $4N=36$ 维。这样保留 goal-conditioned 的核心结构,又把感知混杂从 HER 因果问题中拿掉。 |
|---|---|
| 随机种子 | 0、1、2 |
| 关键配置 | default-config.json |
本报告迁移自 CS285 课程材料 [1]。
本作业实现 9×9 goal-conditioned 导航、UVFA DQN、no-HER baseline、future/final HER、dense/sparse reward 与动力学域随机化。公开的 结果汇总 记录了 21 个 CPU 训练 run 的 success、return 与运行元数据;视频是单轨迹演示,不替代统计结果。
项目入口
结果汇总 · 关键配置 · demo manifest · 方法对照 demo
1. 摘要与证据口径
主要结果
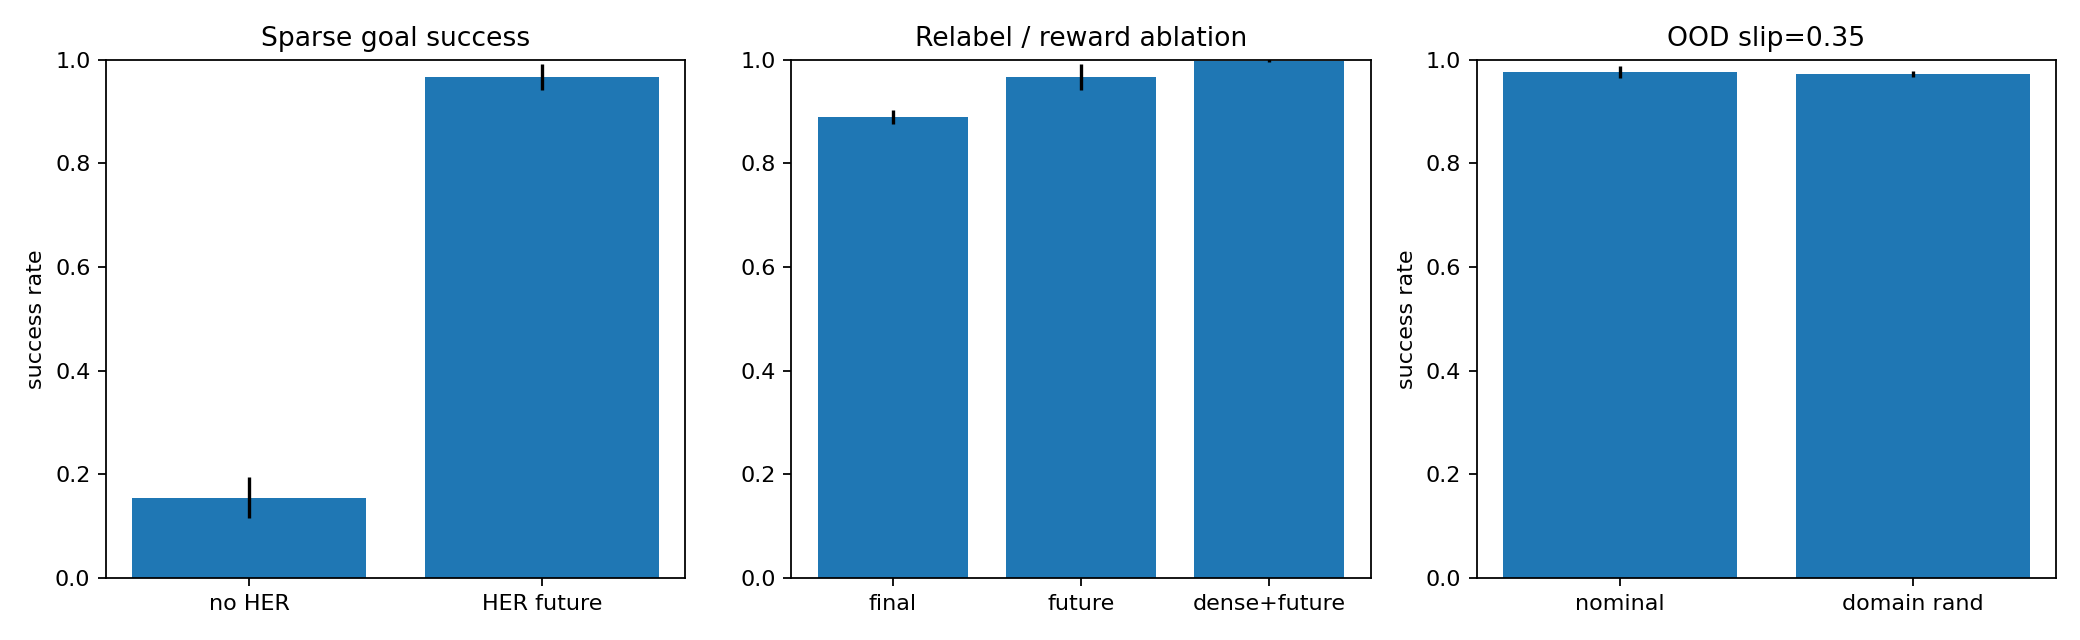
稀疏奖励下,无 HER 成功率只有 15.5%±4.0%,future-HER 达到 96.7%±2.5%;final-HER 为 89.0%,future-HER 为 96.7%,dense+future 为 99.8%。然而域随机化并未提升 OOD:名义训练 97.7%,域随机化 97.3%,两者 CI 重叠——这是对“domain randomization 一定有效”的直接反例。
证据等级 / 复现契约
- 【B:toy mechanism evidence】 每条件 seeds={0,1,2};500 train episodes/run;最终 200 个独立 episodes。误差为 seed SD;95% CI 对三个 seed 均值做 10,000 次 bootstrap,n=3 时仅描述。
- 公开结果文件记录 Python 3.13.5、PyTorch 2.9.0、CPU,以及每个 run 的耗时;本站不发布完整命令耗时。
- 所有汇总标量见 results.json;原型中的逐 run CSV、TensorBoard events 与 checkpoint 不随本站发布。
- 视频选择规则与对应统计见 demo manifest;它们是单轨迹示例,不代替 200-episode 统计。
图 1:HER、relabel/reward 与 OOD transfer 三组受控实验,error bar 为 3-seed SD。
2. 环境:GoalGrid-9
| 组成 | 定义 |
|---|---|
| 状态 | agent 位置 与 desired goal ,均在 9×9 网格 |
| 动作 | 上/下/左/右;越界 clip;horizon=28 |
| 任务分布 | 随机 start/goal,初始 Manhattan distance≥6 |
| 稀疏奖励 | 成功 +1,否则每步 −.05 |
| dense 消融 | 成功 +1,否则 |
| 动力学 shift | 以 slip probability 随机执行另一动作;名义 0,OOD .35 |
观测不是图像,而是 row/column 分解 one-hot:agent 两组 + goal 两组,共 维。这样保留 goal-conditioned 的核心结构,又把感知混杂从 HER 因果问题中拿掉。
3. UVFA goal-conditioned Q
Universal Value Function Approximator 把目标作为价值函数输入:
网络为 36→128→128→4 ReLU MLP;Adam 1e-3、γ=.98、batch=128、target 每 40 episodes hard update。训练 ε 从 1 线性降到 .05。UVFA 让同一状态可对不同目标给不同动作,这是 HER 能复用轨迹的前提。
4. HER:把失败解释成“完成了别的目标”
原轨迹目标 未到达时,从该 transition 之后真实达到的状态集合选择 ,重算奖励与终止:
每个原 transition 保留一次,再生成 个 relabel。future 从 后任一 achieved goal 采样;final 总用终点。关键是同时重算 reward 和 done,否则会产生逻辑不可能的数据。
(此处的实现代码或复现命令不在本站发布。)
HER 的 off-policy 假设
relabel 后的轨迹不是“在新目标条件下由行为策略采的”,但 Q-learning 本身 off-policy,可从这些 transition 学 Bellman target。对强 on-policy 方法直接 relabel 会引入更复杂的 importance/likelihood 问题。
5. 设置、代码结构与复现
(此处的实现代码或复现命令不在本站发布。)
| 实验 | 条件 | 重复 |
|---|---|---|
| A | no-HER vs future-HER,sparse | 3 seeds×500 episodes |
| B | final sparse / future sparse / future dense | 各 3 seeds |
| C | nominal slip=0 vs train slip∼U(0,.35);OOD slip=.35 | 各 3 seeds |
| 公平对照 | 共同协议 | 唯一变化 | demo 选择 |
|---|---|---|---|
| no-HER / future-HER | 同 sparse GoalGrid、网络、500 episodes、seeds 0/1/2 | replay 是否 k=4 relabel | 固定 seed 1;预声明评估流中分别找首个失败/成功 |
| nominal / DR | 同 future-HER、500 episodes、同 OOD slip=.35 | 训练期 slip 分布 | 固定 seed 1、env seed 91;不按 DR 胜负挑选 |
公开配置固定了 seeds、训练/评估回合数、HER 参数和 OOD slip;见 default-config.json。测试源码与运行日志不随本站发布,因此不把测试通过数量列为公开结论。
6. 实验 A:HER vs 无 HER
| 条件 | final success mean±SD | bootstrap 95% CI | Δ vs no-HER | 样本效率 / 证据 |
|---|---|---|---|---|
| no-HER | .155±.040 | [.125,.200] | — | 500 train episodes;B |
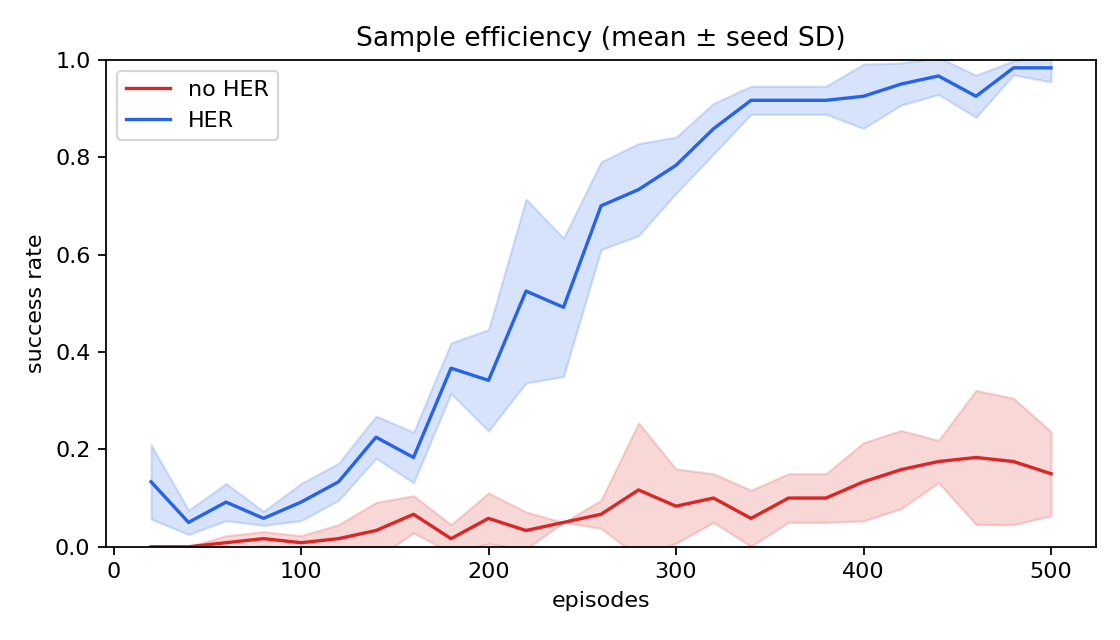
| future-HER | .967±.025 | [.950,.995] | +.812 | 同 500 episodes;图 2 每 20 episodes probe;B |
图 2:每 20 episodes 独立评估 40 episodes;实线为 3-seed mean,阴影为 seed SD。最终表格另用 200 episodes。
差异不是“HER 改了网络”,而是失败 episode 也贡献正 TD target:no-HER 随机探索很少命中远目标,replay 几乎全是 −.05;HER 对轨迹实际经过的位置提供成功监督,UVFA 再把局部移动规律泛化到 desired goal。
7. 实验 B:HER strategy 与奖励密度
| 条件 | 3-seed success | mean | 解释 |
|---|---|---|---|
| final + sparse | .880/.885/.905 | .890 | 每条轨迹 relabel goal 单一,覆盖较窄 |
| future + sparse | .995/.955/.950 | .967 | 同一轨迹产生多尺度子目标 |
| future + dense | .995/1.000/1.000 | .998 | 额外距离 shaping,最易但改变任务信息 |
dense reward 的 3.1pp 增益小于“无 HER→HER”的 81.2pp,说明当前瓶颈主要是成功信号稀疏。但 dense 组拥有额外距离 oracle,不能与 sparse 组当成同信息量算法排名。
8. 实验 C:动力学迁移 / Sim2Real proxy
训练域 nominal 每次动作都按指令执行;域随机化组每 episode 采 。评测统一固定 ,代表 actuator mismatch:
| 训练 | OOD success mean±SD | 95% CI | 结论 |
|---|---|---|---|
| nominal | .977±.012 | [.970,.990] | 已经很强 |
| domain randomization | .973±.006 | [.970,.980] | 方差略低,均值无提升 |
保留的负结果
域随机化没有提高均值。一个可能解释是该 fully observed、closed-loop 任务允许策略在后续步骤纠正随机动作,但本实验没有直接分解原因。若要研究更明显的 transfer gap,应预先定义更强的动力学或观测偏移并重新运行,而不能在看到结果后只保留有利设置。
9. 统计与训练诊断
- success 与 return: success 是 episode-level Bernoulli;return 还编码路径长度(每步 −.05)。两者均在 JSON,不能只拿 shaped return 代替任务成功。
- TD loss: CSV 中记录 rolling TD Huber loss,但 loss 下降只说明拟合 replay target,不保证到达新目标;报告主轴因此用 held-out success。
- bootstrap: 先得到每个 seed 的 200-episode success,再对 3 个 seed 均值重采样 10k 次;没有把 600 episodes 错当 600 个独立训练重复。
- best/last: 主表只用训练结束 checkpoint 的固定评估,不做 best-seed/best-checkpoint selection。
10. 方法对照 Demo:HER 行为改进与 DR 负结果
图 0:no-HER(左)vs future-HER(右):同 sparse task、seed 1、last checkpoint。脚本在预声明 eval stream(env seed 81)选首个失败/成功,不挑训练 best;蓝线为执行路径,绿星为 goal。总体 success .155→.967。
视频:noher_failure.mp4视频:her_success.mp4
图 0:nominal(左)vs domain randomization(右):同 seed 1、固定 env seed 91、OOD slip=.35;两条都成功。3-seed×200 episodes 的 OOD success 为 .977 vs .973,直观结果是“几乎相同”,不是 DR 胜利。
视频:nominal_ood.mp4视频:domainrand_ood.mp4
11. 理论对接:多任务、迁移与研究方法
UVFA: 把 task descriptor 并入函数逼近器,是多任务共享表示的最小形式;与模块 12 的 context-conditioned policy/value 一致。HER: 不创造新物理 transition,只改变“这段经验在什么目标下有意义”,相当于 goal-space 数据增强。域随机化: 优化的是训练域分布上的期望,只有随机化分布覆盖真实域且 capacity/optimization 足够,才可能提高真实域性能;它不是 invariance 保证。
模块 22 的研究方法体现在:预先分离 success/loss,固定 3 seeds,保存逐 run 原始记录,明确负结果,并把“机制证据”和“机器人外推”分级。
12. 外推边界与下一步
绝不能外推为机器人结论
本环境没有相机、状态估计、连续力矩、接触、延迟、安全约束、现实数据成本或硬件磨损。HER 在网格中有效,只说明 reward relabeling 机制可工作;不能推出真实抓取会提高 81pp。slip 随机化仅是 Sim2Real proxy,不是 Sim2Real。
- 3 seeds 的 CI 很粗;下一步至少 10 seeds,按 seed 做 paired comparison。
- domain randomization 负结果提示 benchmark 太易恢复;应增加不可逆障碍和 observation shift,并在实验前定义 OOD。
- future relabel 在这里没有 goal validity/feasibility 问题;机器人中 achieved goal 可能碰撞、不安全或不可复现。
- 可继续实现 continuous UVFA actor、TD3/SAC+HER、curriculum goal sampling 和 successor features,比较“重标数据”与“分解动力学/奖励”的迁移路径。
Claim–Evidence 对照
证据文件
9 个文件