VLA / 具身闭环:离线动作像专家,不代表闭环安全
本报告迁移自原课程材料,经 AI 事实核查未发现存疑项,未逐页人工审核;结论与证据请以页面列出的原始文件为准。
实验目标
VLA / 具身闭环:离线动作像专家,不代表闭环安全
实验设置
| 环境 | 10×10 连续闭环网格包含 agent、两种颜色的目标区和带缺口障碍墙。语言 one-hot 指定“去绿色区”或“去红色区”;proprio 是归一化 $(x,y,t/H)$;40×40 RGB 负责给出障碍、两个目标和 agent 的空间关系。目标颜色随语言改变,因此只读 proprio 无法确定应去哪个终点。 |
|---|---|
| 随机种子 | 0、1、2 |
| 关键配置 | cpu.jsonproduction_libero_maniskill_NOT_RUN.yaml |
本报告迁移自 CS285 扩展课程材料 [1]。
本作业从零构建 2-D 视觉+proprioception+language goal 的 manipulation/navigation proxy,以可控成本真实运行 expert→BC→DAgger→domain randomization→action chunking。评测把任务成功、碰撞成本和潜在安全接管分开,并用相同训练设置下的 chunk1/2 执行对照观察 OOD success–safety trade-off。
项目入口
README / 代码目录 · tests · artifacts · demo manifest · 方法对照 demo
0. 结论与证据契约
一句话结论
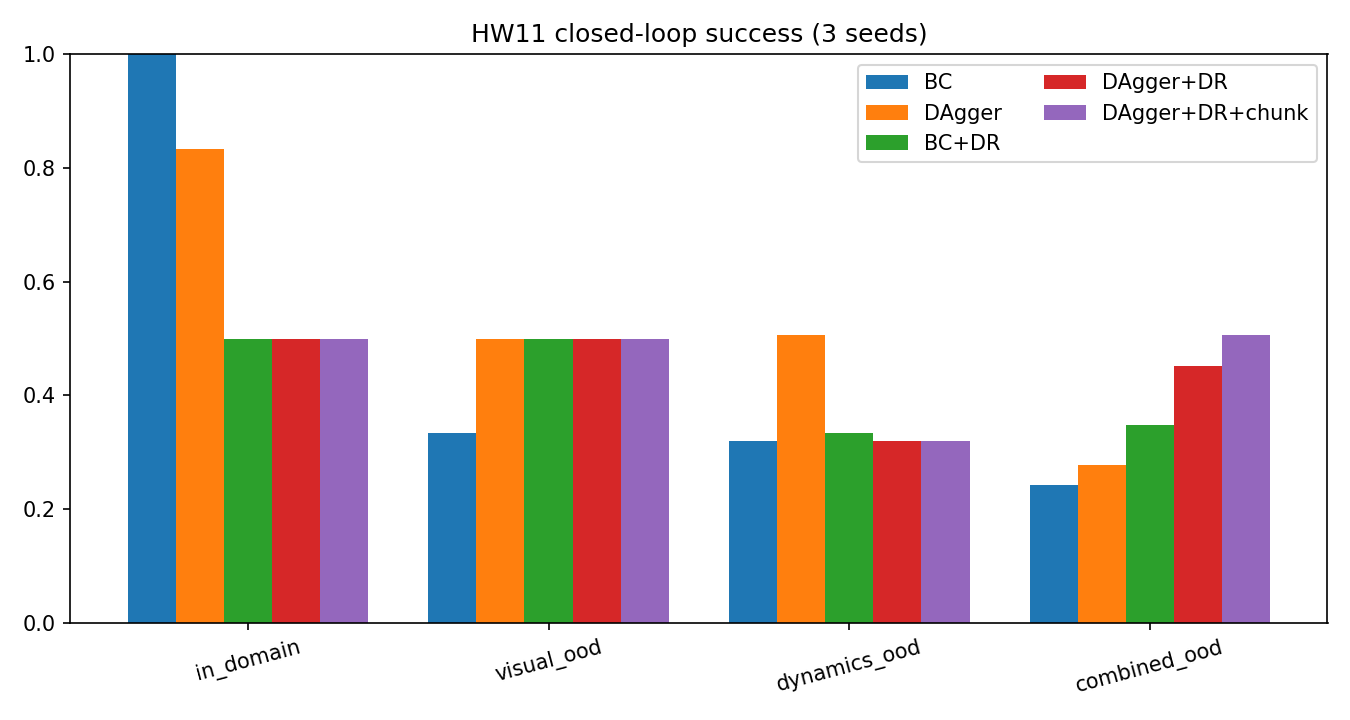
BC 在训练域成功率 1.000、零碰撞,却在 dynamics OOD 降到 0.319 且每回合碰撞 11.19;DAgger 把该条件改善到 0.507 / 3.45。相同训练设置下的 DAgger+DR chunk1→chunk2 对照在 combined OOD 为 0.451/3.19 → 0.507/4.80:成功提高但碰撞也增加;ID 下两者都不安全(13.00 vs 12.17),不能把全部 ID 碰撞归因于 chunk。
本报告的证据边界
- 已执行: CPU、seed 0/1/2;每 seed 72 个 expert episodes;每方法×条件×seed 48 个闭环评测 episode;当前公开 manifest 记录用时 56.16 s。
- 比较: BC、两轮 DAgger、BC+domain randomization,以及相同训练设置下 DAgger+DR 的 chunk1/chunk2 执行对照。DAgger 有额外 expert query,不能伪装成同离线数据量。
- 条件: in-domain、visual OOD、dynamics OOD、combined OOD;另有不混入主指标的 safety-layer 评测。
- 没有执行: LIBERO、ManiSkill、接触操控、GPU VLA、真机。生产配置严格标记 NOT RUN。
- 原始证据:逐 episode 聚合结果、3-seed summary/CI、训练曲线、manifest。
1. 视觉 + proprio + language 的闭环环境
10×10 连续闭环网格包含 agent、两种颜色的目标区和带缺口障碍墙。语言 one-hot 指定“去绿色区”或“去红色区”;proprio 是归一化 ;40×40 RGB 负责给出障碍、两个目标和 agent 的空间关系。目标颜色随语言改变,因此只读 proprio 无法确定应去哪个终点。
状态转移含 action slip 与一步 delay:(delay 条件)或以概率 被随机方向替换。碰障时状态不变并累计 cost,走到错误颜色目标会失败终止。
| 观察通道 | shape | 用途 | OOD 操作 |
|---|---|---|---|
| RGB | 3×40×40 | 障碍、agent、双目标 | 颜色置换、条纹、像素噪声 |
| proprio | 3 | agent 坐标与进度 | 动力学改变后仍会更新 |
| language | 2 | 选择绿色/红色目标 | 保持不变,防止任务 ID 漂移 |
| action | 5 类 | 单步控制 | 滑移与一步延迟 |
执行与成功标准: 策略必须在 horizon=34 内到达语言指定颜色目标;错误目标、碰撞循环和 timeout 均失败。Reward 与 collision cost 分开,行为 demo 不以最终到达掩盖中间碰撞。这是可执行 2-D scaled task,不是真机操控。
它为什么只是 manipulation/navigation proxy
到达颜色区近似“把末端移动到目标区域”,但没有抓取、接触、姿态、力矩和物体动力学。它能测闭环分布偏移与安全记账,不能测真实操作技能。
2. Part 1:Expert dataset、BC 与复合误差
expert 使用障碍图上的 BFS,每一步重新从当前状态规划,因此滑移后也能纠正。每条示范保存 image、proprio、language、当前 expert action 和下一 expert action;seed 0 的完整数组以压缩 NPZ 落盘并写 SHA-256。
卷积视觉编码器与 proprio/language 融合后输出两个 action heads。第一头是普通 BC;第二头为 action chunk 的第 2 个 token。离线 train action accuracy 只说明示范分布上的分类,不等于部署成功:
且一旦偏离,后续观察不再来自 expert occupancy。BC 的 in-domain 1.000 与 dynamics OOD 0.319 正是这种 distribution shift 的直接展示。
3. Part 2:两轮 DAgger 与 action chunking
每轮先让当前策略在带滑移与传感噪声的环境闭环 rollout,再在策略真正访问的每个状态查询 BFS expert,并把新标签聚合回数据集:
DR 分支的 DAgger 查询发生在 combined OOD + OOD layout 上。记录的 expert_queries 反映额外监督成本;报告没有把它称作“与 BC 同数据预算”。最终 DR+DAgger 方法执行 2-step chunk:一次推理产生 ,第二步不重新看图。
| 对照 | 共同协议 | 唯一变化 | 公平性限制 |
|---|---|---|---|
| BC → DAgger | 同架构、seed、四条件、48 eval episodes | 两轮 on-policy expert query | 常规 DAgger 多 573–867 queries,非同数据量 |
| BC → BC+DR | 同 BC 目标与评测 | 训练域随机化 | 训练分布更宽,优化难度不同 |
| DAgger+DR chunk1 → chunk2 | 相同训练设置、相同 seed/task/评测流 | 执行时是否开环执行第二 token | 相同训练设置下的 chunk1/chunk2 对照;公开证据不能确认两者为同一权重 |
chunk 的双刃剑
chunk 降低推理频率并提供短时连贯动作,但第二步是开环的;slip、delay 或第一步失败后,第二步可能已不适合当前状态。实验中它提升 combined OOD 平均成功,却造成 in-domain 高碰撞,是必须保留的反例。
4. Part 3:sim-to-real proxy 与 domain randomization
训练期 DR 不只改颜色:每 episode 随机 palette,并交替加入条纹、滑移、偶发一步延迟、传感噪声以及部分 OOD layout。评测拆成四个臂:
| 条件 | 视觉 | 动力学 | 布局 |
|---|---|---|---|
| in-domain | 训练 palette | 无 slip/delay | 训练墙 |
| visual OOD | 固定新 palette + 条纹 | 原动力学 | 训练墙 |
| dynamics OOD | 训练视觉 | 滑移 + 一步延迟 | 训练墙 |
| combined OOD | 新 palette+纹理+噪声 | 滑移 + 一步延迟 | 额外横墙 |
这是一组可重复的 transfer stress test,不是真实域。颜色与纹理变化只是 camera gap proxy;slip/delay 只是 actuator gap proxy。
5. Part 4:碰撞成本、潜在干预与 safety layer
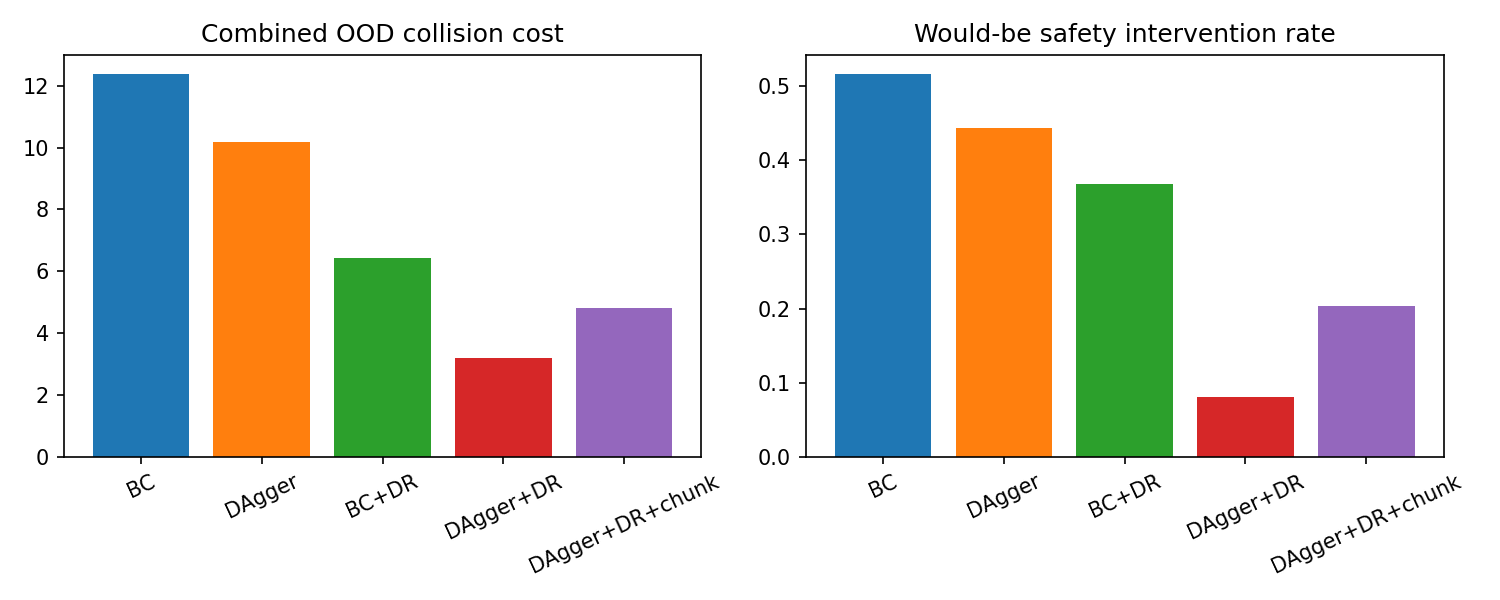
每一步分别记录任务 reward 和 collision cost。若策略动作会立即撞墙,记一次 would-be intervention;主评测仍执行原动作,避免 safety layer 掩盖策略本身。另跑独立 safety-layer 条件,将不安全动作替换为 expert 动作:
为何安全层后仍可能有 collision cost
delay 与 slip 发生在 command 之后:安全层检查“当前 command 是否立即撞墙”,却无法完全阻止上一拍延迟动作或随机 slip。因此它不是零风险证明。
图 1:combined OOD 下碰撞和潜在干预必须独立于 success 报告。
6. Part 5:三种子 in-domain / OOD 结果
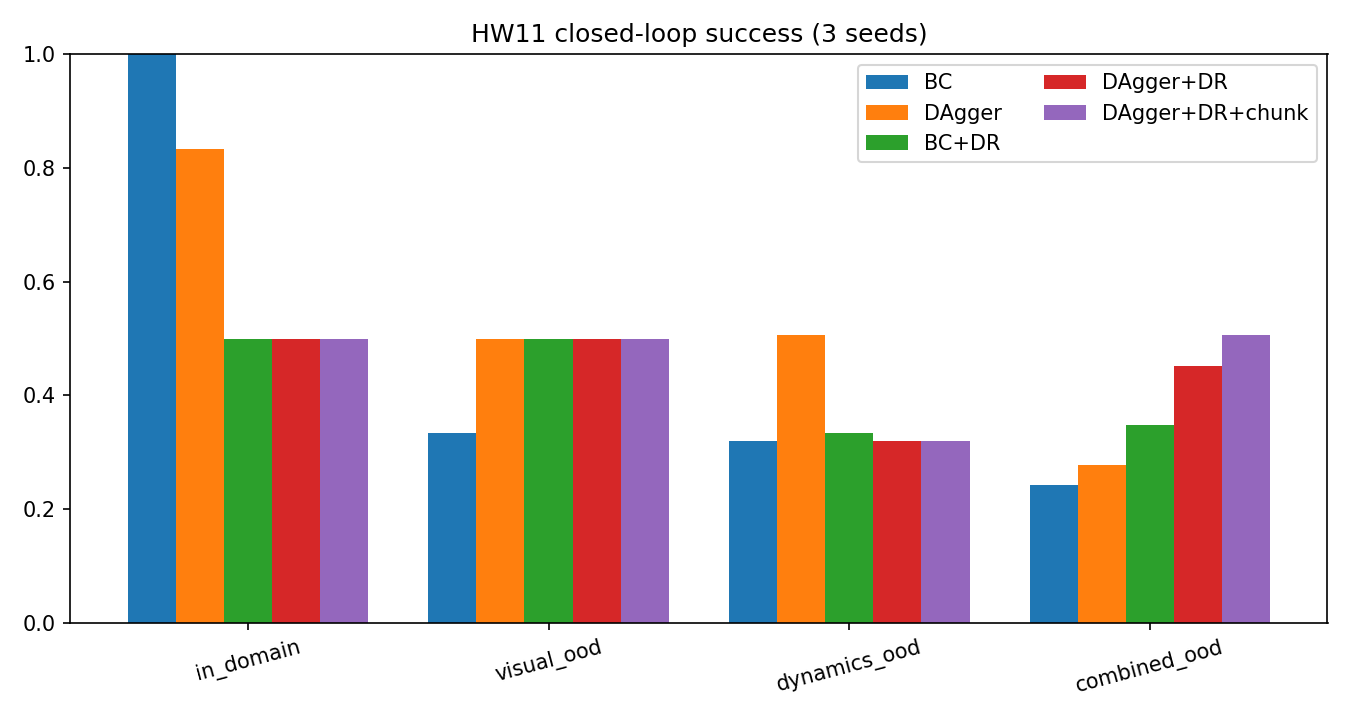
| 方法 | ID success / cost | Visual OOD success / cost | Dynamics OOD success / cost | Combined OOD success / cost |
|---|---|---|---|---|
| BC | 1.000 / 0.00 | 0.333 / 9.67 | 0.319 / 11.19 | 0.243 / 12.39 |
| DAgger | 0.833 / 0.00 | 0.500 / 9.67 | 0.507 / 3.45 | 0.278 / 10.19 |
| BC + DR | 0.500 / 0.00 | 0.500 / 0.00 | 0.333 / 7.60 | 0.347 / 6.44 |
| DAgger + DR + chunk1 | 0.500 / 13.00 | 0.500 / 15.00 | 0.319 / 12.40 | 0.451 / 3.19 |
| DAgger + DR + chunk2 | 0.500 / 12.17 | 0.500 / 15.00 | 0.319 / 12.24 | 0.507 / 4.80 |
图 2:DAgger 主要修复 dynamics shift;DR 主要改善 visual/combined OOD;组合方法没有全域支配。
三 seed 的 df=2 t-CI 保存在 summary.json。多个区间很宽甚至越过 [0,1],原因是只有 3 个 seed 且方法对初始化敏感;正文不以“CI 重叠/不重叠”宣称显著性。每 seed 每条件的 48 episode 已降低 rollout 噪声,但不能消除训练 seed 方差。
实测 trade-off
DAgger 将 dynamics OOD 的成功率提高约 18.8 个百分点,同时将碰撞从 11.19 降至 3.45;但 combined OOD 只提高 3.5 个百分点。状态纠偏并不会自动产生视觉不变性。
7. Part 6:监督 loss、闭环成功与失败 taxonomy
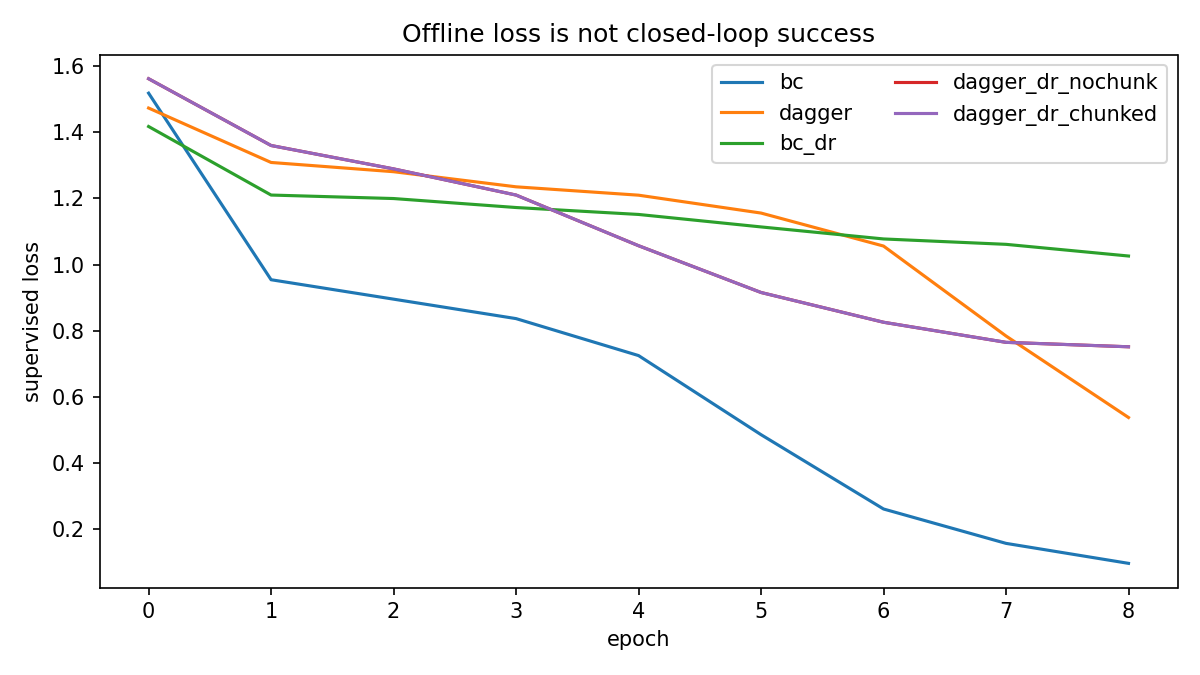
图 3:loss 是示范分布上的 surrogate;不同方法的数据分布不同,不能按最低 loss 排闭环能力。
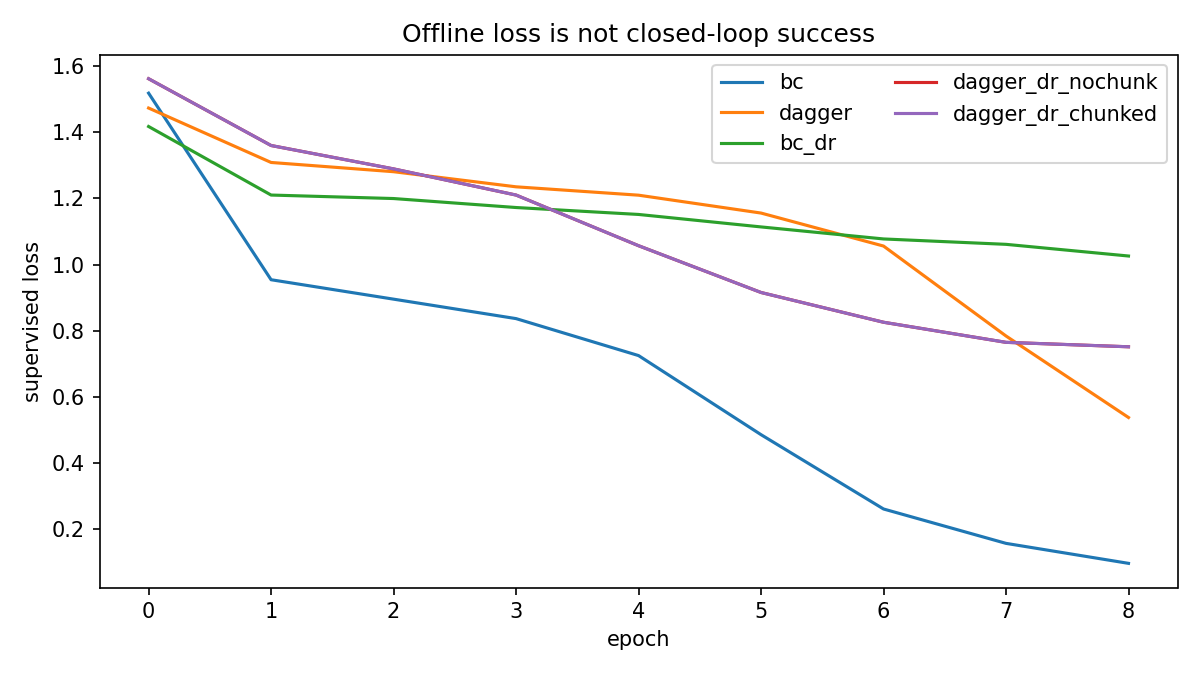
每个 episode 终局归为四类且总和等于评测回合数:
- success: 到达语言指定颜色目标;
- wrong_target: 到达另一颜色,暴露 language conditioning 失败;
- collision_loop: 未成功且碰撞次数达到阈值,典型于 delay/chunk 与墙交互;
- timeout: 未达到上述条件,常见于策略振荡或停留。
负结果 1 · DR 代价
BC+DR 的 visual OOD 碰撞降为 0,但 in-domain success 从 BC 的 1.000 降到 0.500;训练分布更宽不保证在固定容量/预算下全面更好。
负结果 2 · Chunk 安全 trade-off
相同训练设置下的 chunk1/chunk2 对照中,chunk2 相对 chunk1 的 combined OOD success 为 0.507 vs 0.451(+5.6pp),碰撞却从 3.19 升至 4.80(+1.61)。ID 下两者都出现碰撞且 chunk2 略低,因此旧的“ID 碰撞由 chunk 单独造成”解释不成立。证据只支持:本 OOD 流中开环第二 token 换来成功率,同时增加安全成本。
8. 方法对照 Demo:BC/DAgger、DR 与 chunk ablation
图 0:BC dynamics OOD:seed 0 checkpoint、固定 rollout seed 777;delay/slip 后碰撞。三 seed success/cost=0.319/11.19。
图 0:DAgger dynamics OOD:相同 checkpoint seed 与 rollout 规则;总体 0.507/3.45。行为改善与额外 expert query 同时存在。
图 0:BC+DR visual OOD:固定 seed 0 / rollout 777;新 palette 与条纹域。总体 0.500/0.00,但 ID success 仅 0.500。
图 0:Chunk1:DAgger+DR seed 0,in-domain 每步重规划;三 seed cost=13.00。
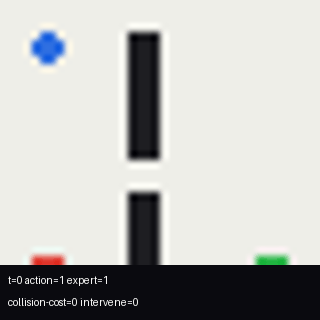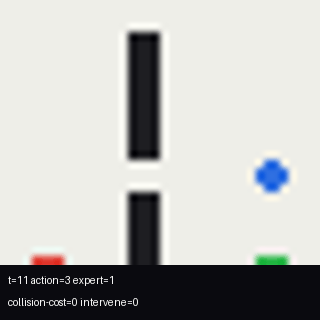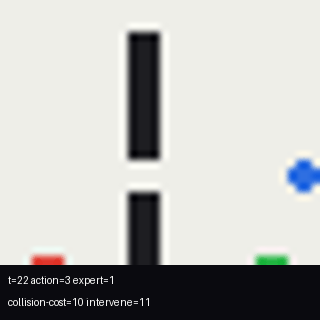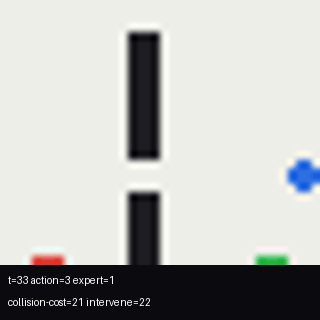
图 0:Chunk2:相同训练设置下执行第二 token;seed 0 / rollout 777。三 seed ID cost=12.17,说明两者都不安全。
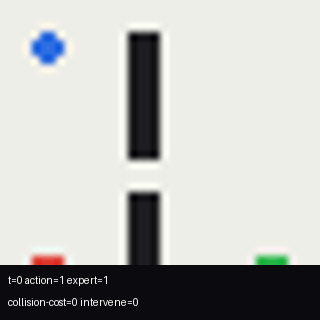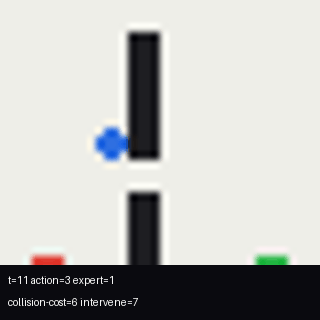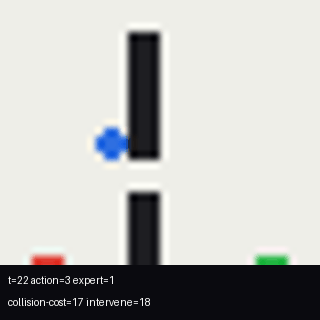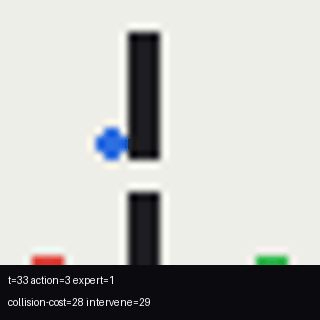
图 0:Chunk2 combined OOD:额外墙、视觉噪声、slip 与 delay;总体 0.507/4.80,对照 chunk1=0.451/3.19。
GIF 是固定 seed 的可解释轨迹,不代表均值;算法排序只使用全部 3×48 episode 的 JSON 指标。
9. 工程、测试与复现命令
(此处的实现代码或复现命令不在本站发布。)
- 测试: 本站未公开测试日志,不据此声称测试通过数量。
- 公开证据: 逐 seed JSON、汇总、训练曲线、failure taxonomy、图与 GIF;模型 checkpoint 和 expert 数据集不在本站发布。
- 配置:CPU config;LIBERO/ManiSkill NOT RUN。
10. 与 LIBERO、ManiSkill 和真机的断裂
| 本作业具备 | 真实系统还缺什么 | 不能声称 |
|---|---|---|
| RGB+proprio+language 融合 | 多相机标定、depth、时间同步 | 真实视觉泛化 |
| 离散移动与障碍碰撞 | SE(3) 动作、接触、抓取、摩擦 | 操控成功率 |
| slip/delay/noise DR | system ID、actuator P99、真实传感噪声 | sim-to-real transfer |
| 即时安全替换 | 关节限位、力控、E-stop、人工 SOP | 真机安全认证 |
生产配方 · NOT RUN
配置列出 LIBERO-Long/Goal、ManiSkill3、OpenVLA/ACT/Diffusion、20 Hz、多相机、三 seed、延迟 P99、CVaR 与人工接管日志;本机没有安装或执行这些组件,也没有任何真机轨迹。
11. 面试题与参考要点
Q1:BC loss 很低,为什么闭环仍失败?
BC 只拟合 expert occupancy;一次误差进入未见状态后,后续误差相关并复合。闭环 rollout 和 recovery test 才测部署能力。
Q2:DAgger 的公平比较要记录什么?
额外 expert query 数、策略 rollout 数、聚合迭代、访问状态分布和安全成本;不能只说“同 epochs”。
Q3:为什么 success 不能替代 safety?
策略可以先撞很多次再偶然到达目标。约束 MDP 中 reward 与 cost 是不同随机变量,至少分别报 success、collision、intervention 和尾部风险。
Q4:action chunk 何时危险?
环境变化快、第一步可能失败、delay/slip 大或障碍近时,后续 token 基于过期观察。可缩短 chunk、重叠重规划、置信触发中断并逐步做 safety check。
Q5:Domain randomization 为什么可能降低 ID?
固定模型容量与训练预算被更宽的域分摊,随机化范围可能覆盖不真实区域;需要 posterior randomization、容量/预算匹配和 ID/OOD 同时报表。
Claim–Evidence 对照
| 结论 | 状态 | 证据 | 升级条件 |
|---|---|---|---|
| BC 在 in-domain 的三种子平均成功率为 1.000、碰撞成本为 0,但在 dynamics OOD 中为 0.319 / 11.19。 | 已验证 | 数据 ↗数据 ↗ | — |
| DAgger 在 dynamics OOD 中将平均成功率提高到 0.507,并将每回合碰撞成本降到 3.45,但使用了额外 expert query。 | 已验证 | 数据 ↗数据 ↗ | — |
| BC+DR 在 visual OOD 中达到 0.500 成功率和 0 碰撞,但 in-domain 成功率从 BC 的 1.000 降到 0.500。 | 已验证 | 数据 ↗图片 ↗ | — |
| 相同训练设置下,DAgger+DR 的 chunk2 相对 chunk1 在 combined OOD 中提高成功率,同时增加碰撞成本,形成 success–safety trade-off。 | 已验证 | 数据 ↗数据 ↗视频 ↗ | — |
| 主评测与 safety-layer 评测分开记录,公开结果不能把 safety layer 的收益当作原策略安全性。 | 已验证 | 数据 ↗图片 ↗ | — |
| LIBERO、ManiSkill、接触操控、GPU VLA 与真机实验尚未运行。 | NOT RUN | 配置 ↗ | 在公开基准或真机环境中按配置完成至少三个种子的训练与独立评测,并公开任务成功率、安全成本、干预率、延迟和视频证据。 |
证据文件
16 个文件